ARTICLE · 1026700
DeepSeek-Harness 源码深读(08):崩溃那一刻,凭什么敢说“这条命令没执行过”
摘要:session-checkpoint-policy 全部 83 行,在三个流量必经的扩展点上设“先落盘再放行”的闸:请求派发前、工具体执行前、步边界。flush 失败,请求就不发,工具体就不跑。逐行拆完这 83 行,看崩溃归因的语义是怎么拼出来的。
会话跑到一半,进程被 kill -9。重新打开,模型醒了,第一问往往是:我刚才那条删文件的命令,到底执行了没有?
这一问决定它敢不敢重试。答“没执行”,重跑一遍就行;答“不知道”,就得先去文件系统里查证。还有一种最坏的情况:日志里查无此条,文件却真的被改了。这条副作用成了日志之外的幽灵,永远无法归因。
《源码剖析(十一)》《一个能热插拔的插件,只要四个导出》拿 session-checkpoint-policy 当过模板:83 行,四个导出,最小插件的活教材。但那篇只把它当背景板。这篇把它本体拆开,因为“怎么写插件”之外,它还回答了一个更重的问题:一个不提供任何服务、不定义任何事件的纯监听器插件,凭什么改变整个运行时的崩溃语义。
我们先把结论放这儿。它在三个所有流量必经的扩展点上各设一道闸,规则统一:先 flush 落盘,再放行下游。持久化失败,请求干脆不发,工具体干脆不跑。这套姿态有个名字,fail-closed,出错时默认拦截。
深读线的上一篇拆 JSONL 持久化,日志怎么写盘清楚了。这篇拆另一半:什么时候必须写。
一、先看没有它的世界:200 毫秒的幽灵窗口
《源码剖析(五)》讲过会话日志的写侧设计:事件同步提交进内存,落盘走 write-behind,先攒一小批再写,攒批的间隔用一次 fsync 换吞吐。攒多久?这段是批处理窗口的默认值(session-persistence/src/coordinator.ts:29-30):
/** Default maximum intentional wait before a live session batch starts writing. */export const DEFAULT_WRITE_BATCH_MAX_DELAY_MS = 200200 毫秒。这条是事件进队列的门(write-behind.ts:45-56):
enqueue(event: SessionEvent): void { const wasEmpty = this.pending.length === 0 this.pending.push(structuredClone(event)) if (this.barrier !== undefined) return if (this.automaticPaused) { this.automaticPaused = false this.deadlineExpired = false this.armTimer() } else if (wasEmpty) { this.armTimer() }}注意 armTimer 的触发条件:队列从空到非空,起一个 200ms 的定时器,到期把这批事件写下去。窗口内崩溃,这批事件就没了。
窗口本身没罪,攒批换吞吐是正当设计。有罪的是窗口和副作用的错位:tool/call 事件还在内存里排队,工具体已经在改文件系统了。此刻断电,磁盘上查无此调用,文件却真的动了。恢复后的模型面对一个无迹可寻的既成事实。
所以要有一个角色,在要紧的时刻强制排空缓冲。它不能靠每个调用方自觉 flush,调用方会忘,也会漏。它得站在所有流量必经的位置上。
先把三道闸的全景图放这儿,后面每一节都在填它的一段:
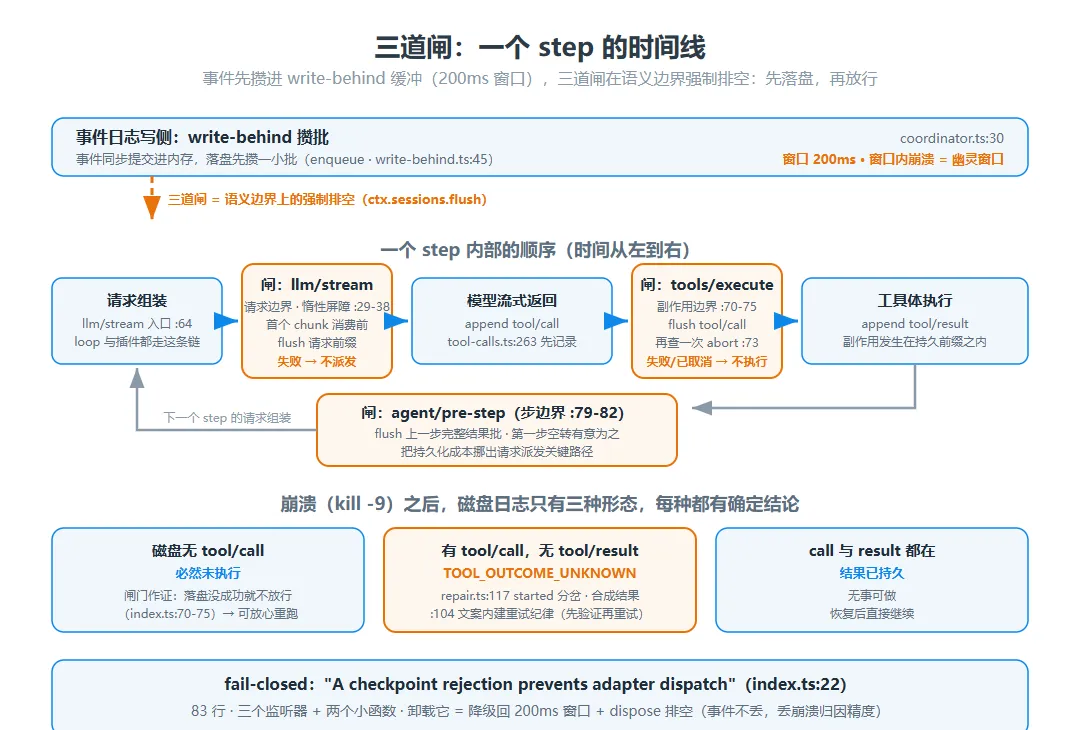
一个 step 的时间线
二、第一道闸:请求派发前
插件给自己选的位置,声明在 inject 里。这段是它的全部站位(index.ts:12-18,摘录):
import type {} from '@deepseek-ai/dsh-session-persistence' // :12// …export const name = 'session-checkpoint-policy' // :15/** Services whose request, tool, session, and persistence boundaries this policy joins. */export const inject = ['llm', 'sessionPersistence', 'sessions', 'tools'] // :18第 12 行那个空 import 有个讲究:什么都不导入,只声明包依赖存在,等于写下“我和持久化是一对”。inject 的四项则保证装载它时,llm 适配层、持久化、会话仓库、工具注册表必然都已在。四个服务各对应一道它要介入的边界。
第一道闸挂在 llm/stream 上。这是模型调用的单一必经入口,loop 里的调用、任何插件的调用,都从这条瀑布链过(《源码剖析(四)》拆过它)。这段是监听器本体(index.ts:64-68):
ctx.on('llm/stream', (options, next): AsyncIterable<StreamChunk> => { if (options.sessionId === undefined) return next() const session = ctx.sessions.get(options.sessionId) return session === undefined ? next() : afterCheckpoint(ctx, session, next)})带 sessionId 的调用才需要闸,找不到会话的放行。闸门本体在 afterCheckpoint(index.ts:29-38):
function afterCheckpoint( ctx: Context, session: Session, next: () => AsyncIterable<StreamChunk>,): AsyncIterable<StreamChunk> { return (async function* (): AsyncIterable<StreamChunk> { await ctx.sessions.flush(session) yield* next() })()}注意这个写法:监听器立即返回一个 async generator,flush 写在 generator 体内。generator 不被迭代就不执行,所以组流本身不付 flush 成本;直到下游真正来拉第一个 chunk,flush 才发生,而拉第一个 chunk 的瞬间,就是 HTTP 请求即将派发的瞬间。顺序由此钉死:本次请求的完整前缀(request/header 快照、历史消息、上一步的 tool/result)先 fsync 到磁盘,适配器才拿到派发资格。
flush 的入口也讲究。插件调的 ctx.sessions.flush() 是会话仓库的独占入口,这段是它的文档注释(core/session/src/index.ts:1009-1016,摘录):
/** * Dispatch the awaited `session/flush` durability checkpoint for `session`, * with the carrier captured at {@link enter}. THE flush entry point: the * store owns the carrier, so callers (the checkpoint policy's per-request * barrier, goal-round-driver's idle checkpoint, teardown drains, and consumers * that flush themselves before reading storage) must come through here * rather than dispatch a raw `ctx.parallel('session/flush', …)` — one owner, * one spelling, and the scoped-dispatch invariant can pin it. */one owner, one spelling,一个属主一种写法。注释把合法调用方列成了名单:检查点策略的每请求屏障、goal-round-driver 的空闲检查点、收尾排空。谁都不许绕开 store 直接派发 session/flush 事件。
fail-closed 就藏在这套顺序里。flush 抛异常,await 那行 reject,generator 死掉,next() 永不被调用,适配器未被派发。源码注释写得很直白:“A checkpoint rejection prevents adapter dispatch”(index.ts:22)。持久化失败,宁可这个请求不存在,也不让它变成磁盘上查无此行的幽灵。
三、第二道闸:工具体执行前,多查一次 abort
副作用的闸更微妙。这段是 tools/execute 的监听器(index.ts:70-75):
ctx.on('tools/execute', async (exec, next): Promise<ToolExecutionResult> => { if (exec.agent === undefined || exec.parent !== undefined) return next() await ctx.sessions.flush(exec.agent.session) if (exec.signal.aborted) return abortedBeforeDispatchResult() return next()})开头两个放行条件各有含义。exec.parent !== undefined 是嵌套调用,外层的顶层调用已经 flush 过,嵌套执行发生在同一个持久前缀之内,再 flush 只是空转;exec.agent === undefined 是无代理上下文的调用,没有可 flush 的会话。
然后是那行多出来的判断:flush 完成后,重新查一次 signal.aborted。
为什么必须重查?flush 是磁盘 I/O,毫秒级。这段时间里用户可能已经按了 Esc。如果只在 flush 前查一次,取消信号会在 I/O 间隙里漏进来,工具体照样执行一个用户刚刚取消的副作用。重查命中就返回 abortedBeforeDispatchResult()(index.ts:41-50):
function abortedBeforeDispatchResult(): ToolExecutionResult { return { content: [{ type: 'text', text: 'Error: tool call aborted before dispatch' }], isError: true, error: { message: 'tool call aborted before dispatch', info: { name: 'AbortError', code: TOOL_ABORTED_BEFORE_DISPATCH }, }, }}注意 error.code:TOOL_ABORTED_BEFORE_DISPATCH,结构化错误码,从 dsh-tools 导入。这让“取消”在日志上可区分:结果事件要么是真实执行产出,要么带着明确的“没派发”标记,模型能看懂这两种结果不是一回事。
四、崩溃之后:日志形态的三分对账
两道闸都设好了,现在回到开场的 kill -9,看恢复时能对出什么账。
先补一块写侧事实:agent-loop 执行工具前,会先把 tool/call 事件 append 进日志。这段是事件类型(core/session/src/types.ts:279-283):
/** * The model requested one tool invocation: `name` with the raw `arguments` * JSON string exactly as the model produced it (unparsed). `callId` pairs the * call with its `tool/result`. */'tool/call': { turn: number; step: number; callId: CallId; name: string; arguments: string }append 的现场在 agent-loop 的 appendToolCall(tool-calls.ts:261-266),函数注释把契约说了个干净:“Append a started call and return the event seq that its result must cite”。先记录,后执行,结果引用记录的序号。
于是崩溃后,磁盘上的日志只有三种形态,每种都有确定结论。
第一种,tool/call 不在磁盘上。第二道闸替它作证:落盘没成功就不会放行工具体,这条命令必然没执行,模型可以放心重跑。
第二种,tool/call 在,tool/result 不在。执行可能已经开始,结果没来得及写。恢复侧的 repair.ts 为它合成一条结果,错误码这样分岔(repair.ts:117-119):
error: started ? { name: 'ToolOutcomeUnknownError', code: TOOL_OUTCOME_UNKNOWN } : { name: 'ToolNotStartedError', code: TOOL_NOT_STARTED },UNKNOWN 那个分支的文案直接写给模型(:104):结果未知,按工具语义决定是否重试,只读或幂等的可以重试,可能有副作用的先验证外部状态,不要盲目重试。重试纪律写进了错误消息本体,不靠系统提示里加一句“请谨慎”。
第三种,tool/result 也在。结果已持久,无事可做。
我核稿时注意到,这套对账有个前提藏在顺序里:闸门守护的是“记录在案”和“实际执行”的先后,前提是 agent-loop 守约先 append 后 execute。插件自己不复查这个顺序,它信任链路上游。
五、第三道闸,和一条写进类型注释的责任边界
还差第三道闸。这段是 agent/pre-step 的监听器,连同源码注释(index.ts:77-82):
// Before each request, persist everything committed by the preceding step;// the first step's call is an intentional no-op beyond any prompt intake.ctx.on('agent/pre-step', async ({ agent }, next): Promise<PreStepDecision> => { await ctx.sessions.flush(agent.session) return next()})每个 step 开始前,把上一步提交的所有东西(assistant 消息、tool/result、step/end)推到持久层。注释也认账:第一步的这次 flush,除提示摄入外是空转,有意为之。
三道闸的分工到这里齐了。pre-step 守步边界,上一步的完整结果批持久;llm/stream 守请求边界,本次请求的前缀持久,失败拦派发;tools/execute 守副作用边界,tool/call 持久,abort 重查。pre-step 和 llm/stream 背靠背,看着冗余,分工其实说得通:pre-step 把持久化成本从请求派发的关键路径挪到步边界,还让排在它后面的只读消费者(上下文投影之类)看到的也是已持久状态。
责任边界最有分量的证据,在会话的类型定义里。turn/end 事件的文档注释(types.ts:244-250,摘录):
/** * Closes turn `turn` with the {@link TurnEndReason} that ended it. A turn * with no entered step has no `step/start` or `step/end`. The loop does not await a * flush at turn boundaries: `dsh-session-checkpoint-policy` owns the * per-request durability checkpoint, and consumers that read storage after * `whenIdle()` flush themselves. */主循环自己不在 turn 边界做 flush,注释点名交给谁:dsh-session-checkpoint-policy 拥有每请求的耐久检查点。耐久性策略从 loop 的职责里剥离,集中进一个可插拔的包。卸掉它,loop 不会有任何报错。
六、卸掉它,代价是什么
这个插件不提供服务、不定义事件,是纯监听器。卸载它的后果一句话说完:三道闸消失,耐久性降级回 write-behind 的 200ms 窗口,外加 dispose 时的收尾排空。事件不丢,收尾排空兜底;丢的是崩溃归因的精度,幽灵窗口重新打开。
两笔账要算清楚。
收益账:83 行换全局崩溃语义。它没写一行恢复代码,恢复侧的截断与合成在 session 内核(repair.ts)早就有了;它只负责让“磁盘上有什么”和“世界里发生过什么”对得上。
成本账:每个请求、每次顶层工具调用,一次强制 fsync(JSONL 后端的 appendLines 每批 fsync 一次,jsonl/index.ts:647)。批量工具并行执行时,每个调用各自过闸,协调器把同会话的并发 flush 合并成串行链。用吞吐换语义,这笔账在重放成本高、副作用不可逆的 Agent 场景下划算,在你自己的场景下未必。
还有一条边界要认:它守护的是三条扩展点,不是整个世界。某个插件绕过 tools/execute 直接改文件系统,这里无感知。接缝式架构的守门员只管门,不管翻墙。
七、设计对账
三个问题收尾。
闸为什么设在扩展点,不靠调用方自觉?llm/stream 是模型调用唯一入口,tools/execute 是工具执行必经链,pre-step 是每步必过钩子。在这三处设闸,新增调用方自动被覆盖,不依赖任何人的记性。散在各个生产方的话,一处遗漏就是一个新幽灵。
为什么选 fail-closed?反过来的是 fail-open:持久化失败照常放行,会话不卡,代价是产生磁盘查无此行的副作用。fail-closed 是请求卡死在闸上,代价是可用性。Agent 的副作用多数不可逆,重放一次模型调用便宜,撤销一次误删没有后悔药。它选了卡死。
为什么三道闸不并成一道?并成一道就得选位置:放在请求边界,工具执行前的长间隔没人管;放在工具边界,请求前缀的保证缺口没人补。三道闸对应三种语义边界,各管各的时点。
结语
回到开场的 kill -9,逐条对账。模型问“那条删文件的命令执行了没有”,答案从磁盘读:tool/call 不在日志里,tools/execute 那道闸替它作证,落盘没成功就不放行,必然没执行(index.ts:70-75);tool/call 在而 result 缺,repair.ts:117 的分岔给它 TOOL_OUTCOME_UNKNOWN,:104 的文案连重试纪律一并交给模型;请求前缀的完整性归 llm/stream 管,第一个 chunk 派发之前,request/header 已在磁盘上。
三道闸,两个十行的小函数,一个空 import,83 行全部摊开了。下一篇深读拆 session-projection:这串已经钉死在磁盘上的事件,怎么被算成模型每一步看到的消息列表。检查点管“存没存下来”,投影管“算不算得出来”。
你的 Agent 崩溃恢复之后,敢对哪条副作用说“肯定没执行”?评论区聊聊你的归因方案。
本系列基于 DeepSeek Harness 源码(MIT,0.1.1-rc.1)与官方 Agent Notes 整理,仓库:github.com/deepseek-ai/deepseek-harness。有收获就点个关注,下一篇见。