ARTICLE · 1029701
腾讯开源 WeKnora:让吃灰的文档,变成会问答、能推理的知识库
企业里最常见的知识困境,不是没有文档,而是文档“躺着”:散在网盘、飞书、Notion、项目目录与历史群聊中;查得到不等于答得准,答得出也不等于能持续维护。
腾讯开源的 WeKnora 想处理的,正是这条从原始资料到可用知识的链路。它把 RAG 问答、ReAct Agent 推理、MCP 工具与联网检索,以及自动生成 Wiki 的能力整合在同一个平台中。目标不是做一个聊天框,而是让文档成为可以检索、推理、演化和治理的知识资产。
一套框架,三种知识工作方式
1. RAG 快问快答:先把日常检索做好
对于制度、产品手册、技术文档和 FAQ 这类问题,最需要的是快速且有出处的回答。WeKnora 提供基于知识库的 RAG 问答,并支持稠密检索、BM25、父子分块、GraphRAG 等检索策略。回答过程可展示 RAG 流水线进度,并通过引用卡片与参考资料抽屉回到原始来源。
2. ReAct Agent:遇到复杂问题,决定下一步该查什么、用什么工具
当问题不是一次检索能回答时,Agent 模式会把知识库检索、MCP 工具和 Web Search 编排到多步推理中。它可以根据中间结果继续寻找资料、调用受限工具、汇总结论。对用户而言,这不是单纯“检索后生成”,而是一个有过程、有边界的任务执行链路。
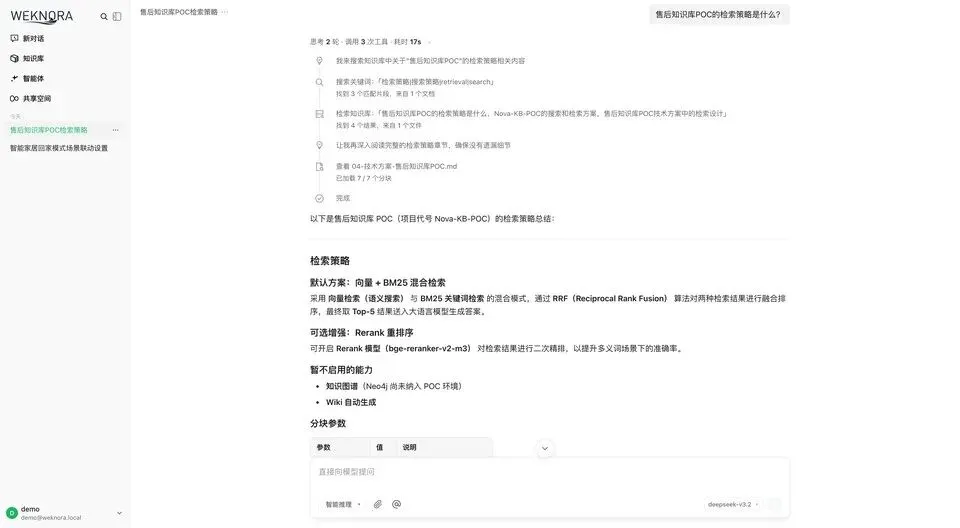
WeKnora Agent Mode:工具调用与推理过程界面(仓库公开截图)
3. Auto-Wiki:从原始文档到可维护的知识网络
WeKnora 最值得关注的方向,是 Wiki Mode。Agent 可以把原始文档提炼为结构化、互相链接的 Markdown Wiki 页面,并提供知识图谱浏览。更关键的是,生成结果不是一次性答案:页面可在浏览器中人工编辑、保留修订历史、查看行级 diff,并一键回滚。
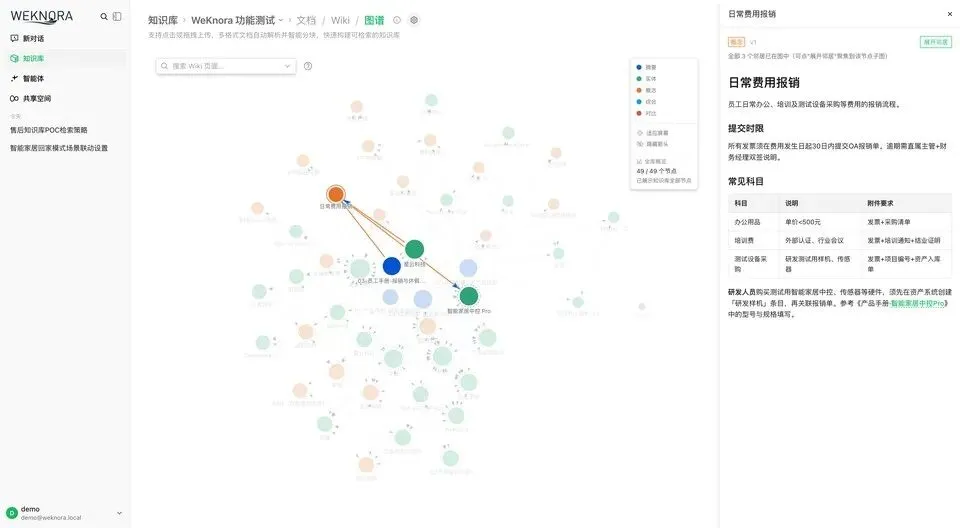
WeKnora Wiki Knowledge Graph:从文档集合到关联知识网络(仓库公开截图)
为什么说它在让文档“活起来”?
能导入:支持 PDF、Word、Excel、图片、网页、Markdown、PPT、JSON 等多种资料;并规划或支持飞书、Notion、语雀、RSS 等数据源同步。 能回答:日常问题可走快速 RAG 检索,回答带引用和资料来源。 能推理:复杂任务可由 ReAct Agent 调度检索、MCP 与联网搜索。 能沉淀:原始材料被整理为结构化、可互链的 Wiki 页面与知识图谱。 能校正:知识库分块与 Wiki 页面都支持编辑、版本对比和回滚,编辑后可自动重新索引。 能治理:以工作区 RBAC、资源归属、审计日志、受限 API Key 与可观测性支撑团队使用。
RAG、Agent 与 Wiki,不应该彼此割裂
很多知识库产品只停留在“上传文件—问一个问题”。WeKnora 的思路是将三个层次接起来:RAG 解决高频事实查询,Agent 解决需要多步行动的复杂问题,Wiki 则把一次次提问与碎片资料转化为长期可阅读、可维护的知识结构。
这三者并非简单堆叠:更好的 Wiki 会改善检索的组织方式;更可靠的检索和来源引用能让 Agent 少一些无依据的发挥;人工修订和版本记录又让知识库能够持续变好。
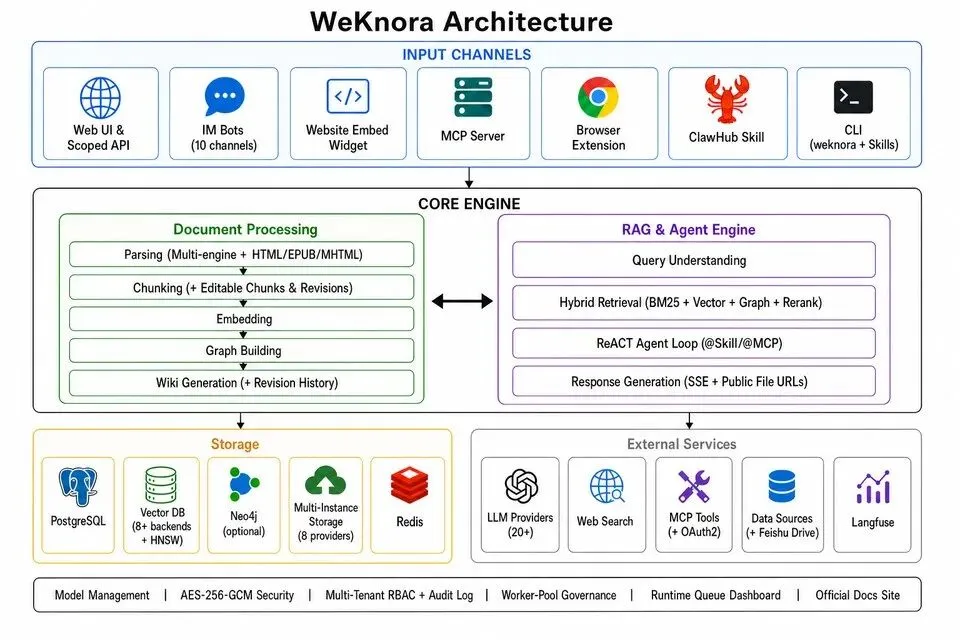
WeKnora 模块化架构:从文档解析、检索到模型推理的可替换流水线(仓库公开架构图)
面向生产环境的“知识治理”部分
真正落地企业知识系统,挑战不只在模型效果。WeKnora 还覆盖了多工作区与四级角色权限、知识库资源归属和审计日志;支持多个对象存储实例按工作区或知识库绑定;集成 Langfuse 跟踪 Agent 推理、Token、工具调用与管线链路。
它也提供多模型、多向量数据库与多存储后端选择,可本地或私有云部署。对有数据边界要求的团队而言,这些能力比一个漂亮的问答界面更接近实际的上线条件。
如何开始体验?
建议从一个边界清楚的小知识库开始:导入团队 SOP、产品手册或项目文档,先检查解析效果和引用命中,再为复杂场景配置 Agent、MCP 与必要的联网检索。不要一开始就把所有历史资料扔进去;知识框架的价值,来自内容质量、权限范围和维护流程一起被设计。
项目地址:https://github.com/Tencent/WeKnora