ARTICLE · 1031253
AI 编程助手账单太贵?这个工具能省三成输入
AI 编程助手账单太贵?这个工具能省三成输入
问编码 Agent 一个问题,它先铺垫两句、解释背景,最后才说出那个你想要的答案。答案本身只有一行,前面两百个字全是客套。
账单上这些都是钱。caveman 想干的事很直接——让 Agent 少说话。
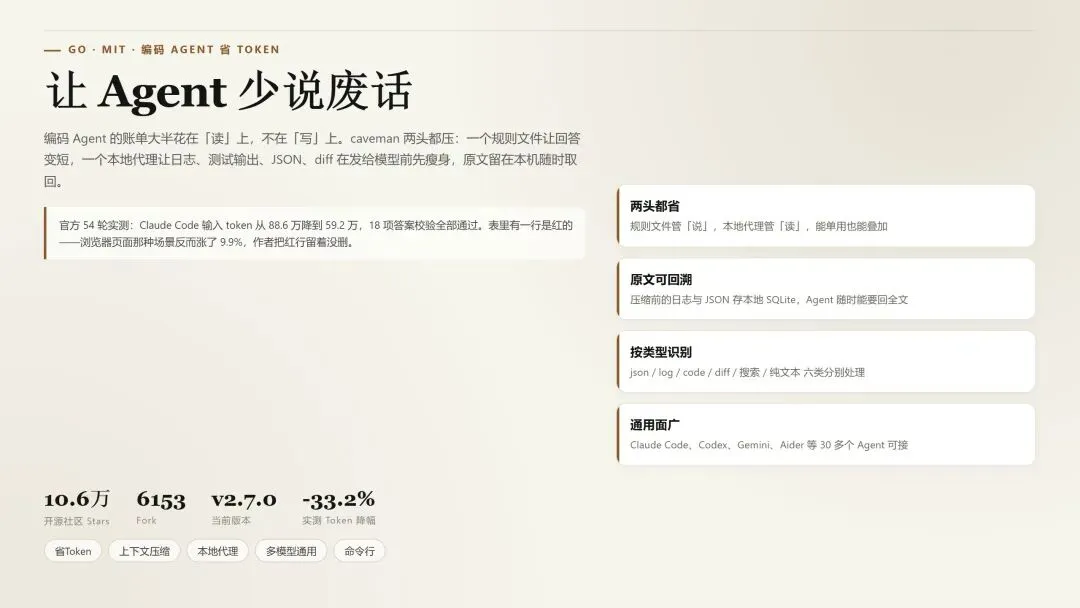
caveman:让编码 Agent 少说废话,两头压 token
它到底解决什么
caveman 是 2026 年 4 月开源的编码 Agent 辅助工具,Go 写成,当前 10.6 万 Star。名字和“原始人说话”那个梗绑在一起:让模型用 Wrap in useMemo 这种电报体回答,保留诊断和修法,砍掉铺垫。
但它真正解决的不是语气,是 token。它把 token 拆成两半:Agent 写出来的是输出,Agent 读进去的是输入。市面上多数“省 token”只盯前一半,caveman 认为真正的账单在后一半。
所以它由两部分组成。技能是一个规则文件,管 Agent 怎么说话,MIT 协议不收费。本地代理是一个跑在你自己机器上的进程,管 Agent 读到的东西——日志、测试输出、JSON、diff、搜索结果,发给模型前先压一遍,原文存本地,随时能要回全文。
三个真正值得看的点
数字给得比同行诚实,包括对自己不利的那一行。官方公开了一份 54 轮 Claude Code 压测:输入 token 总量从 88.58 万降到 59.17 万,降幅 33.2%,18 项答案校验全部通过。但其中“仪表盘 HTML 告警”那一格是从 14.07 万涨到 15.46 万,涨了 9.9%。作者没藏,还写了一句话:哪天我把红的藏了,你就不该再信绿的。
它公开承认自己什么时候没用。文档专门有一节讲边界:按次数计费(比如按 premium request 计费)而不是按 token 计费,回答变短不会让你少付一分钱;纯代码生成、几乎没有叙述文字可砍,也省不下来;短问短答场景下,规则文件本身要占约 1000 个输入 token,可能亏本。这些话通常会被塞进“注意事项”一笔带过。
代理那一半,换来的是“读”的节省。它按载荷类型分流:JSON、日志、代码、diff、搜索结果、纯文本六类各有压法。压缩前的原文写进本地 SQLite 并返回恢复句柄,Agent 觉得信息不够就能把全文拉回来。这一点很关键——很多压缩方案压完就找不回来了。顺带它还能压浏览器页面:200 行表格从 15704 个 token 压到 121 个,小了 129.8 倍。
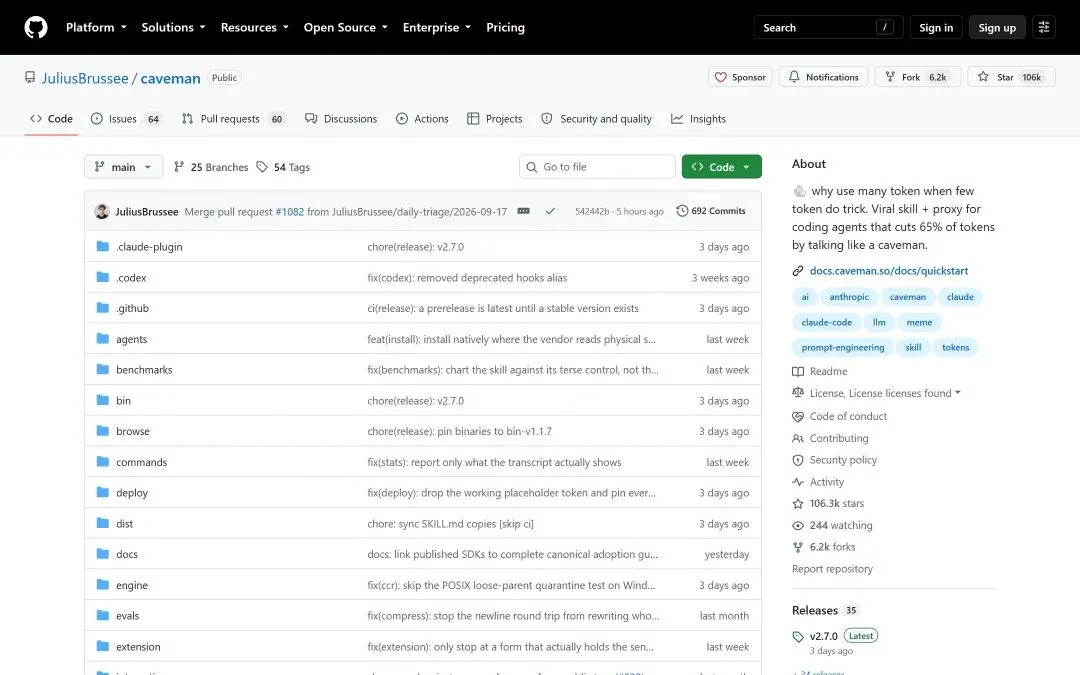
项目仓库页:10.6 万 Star,MIT 与 BSL-1.1 拆分开源
怎么装、怎么用
先装小的那个。技能只要一条命令:npx skills add JuliusBrussee/caveman -g,支持 30 多个 Agent,Claude Code、Codex、Gemini、Cursor、Windsurf、Cline、Copilot 都在列表里。装完在 Agent 里敲 /caveman 生效。
再装代理:npm install -g @caveman-ai/cli && caveman setup --install。
建议的顺序是:先用 caveman learn 让它本地读你几个月的历史,把 token 黑洞按严重程度排出来;再用 caveman learn implement 一次一个 diff 交给你确认。然后务必用 caveman trial -- claude 自己做一次开关对照——官方自己说,这个自测数字比页面上任何官方数字都更值得信。
有一点提前知道:命令行默认发匿名使用统计,发的是命令名和 token 计数,不发 prompt、代码、文件路径。一条 caveman telemetry off 可永久关闭。
槽点,以及它该不该装
许可证是拆开的。技能、CLI、SDK 是 MIT,引擎和运行时是 BSL-1.1:源码可见、自用和自托管免费(含生产),但拿它给第三方做托管服务需要商业授权。要包进对外售卖的产品,这一条必须先问清楚。
实测覆盖面有限。那份 54 轮压测是仓库里的固定报告,原始产物不在代码库,官方自己标注“请当成固定报告看,不是可公开复现的基准”。第三方最严谨的一次 A/B 是 JetBrains 在 2026 年 7 月做的,只测了技能那一半,86 个真实编码任务,输出 token 少 8.5%、成本约少 10%、质量未检出差异——比仓库宣传的保守得多。
项目还在快速迭代期。仓库到 9 月中旬有 124 个打开状态的 issue,官方列出的七个相关仓库里有三个标注“已冻结”,冻结的仍能装能用,但要看清自己用的是哪一块。
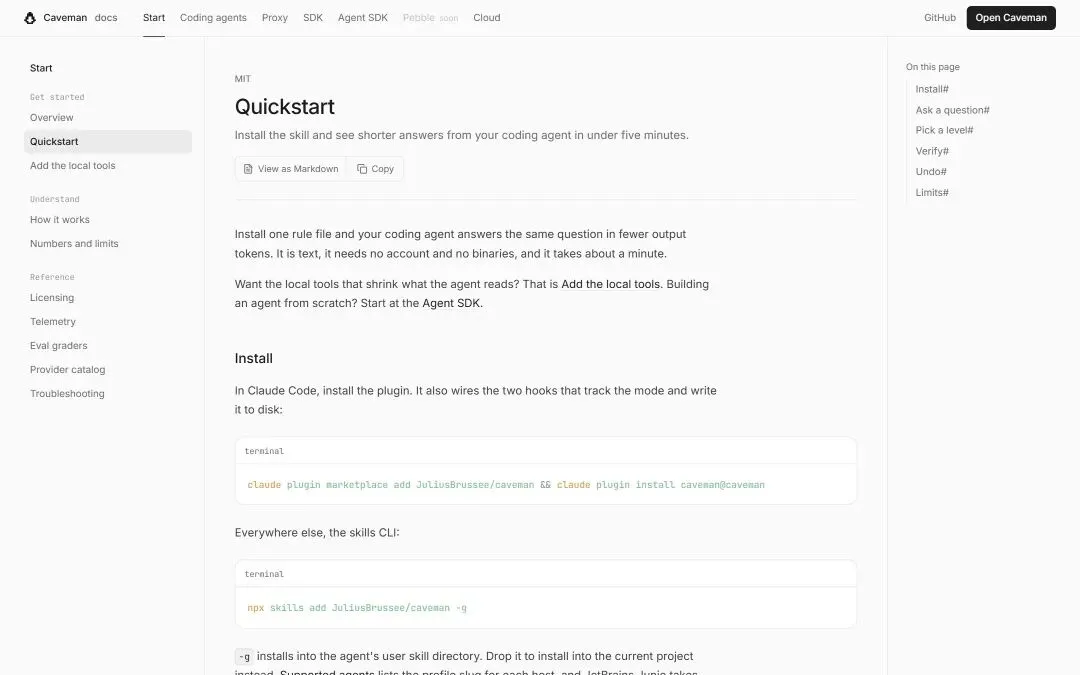
文档站的快速开始页:技能的安装就一条命令
跟同类比,省 token 的做法大致三类:换更小的模型(直接改变答案质量)、自己做上下文管理框架(门槛高、效果看你写的策略)、提示词约束让模型少说(最简单,也最容易被当玄学)。caveman 把第三条做成了可测量的,又在中间夹了一个真在动数据的代理。
判断标准很实际:账单按 token 计价、并且你经常让 Agent 读日志和测试输出,它值得花半小时试一次;计费按“次数”算,或者你几乎不读大文件,那它对你没什么用。
你有没有算过,自己一个月的编码 Agent 账单里,是“写”花得多,还是“读”花得多?