ARTICLE · 1108151
OpenAI 为什么不 Open
OpenAI 为什么不 Open(开源)?
OpenAI是当今世界上数一数二的AI大模型公司,名字带有Open,但是如今却是一家闭源的公司,其实OpenAI的大模型产品一开始是开源的,不过这的从十多年前开始说起了。
2014年,互联网巨头Google收购了 DeepMind,人工智能的研究将成为一家独大的垄断局面,马斯克曾公开经评价全人类的未来就等于攥在一家公司手里可能比核武器还危险。
于是,怀着这种拯救世界的使命感和对抗DeepMind,埃隆·马斯克,山姆·奥特曼等技术理想主义者在2015年成立了OpenAI,那个时候的OpenAI,是个彻底的非营利组织,官网白纸黑字写着使命:确保通用人工智能造福全人类,它还专门发博客承诺,研究成果要免费公开给所有人,这也是"Open"这个名字的由来。
OpenAI成立以来,取得不少成果,GPT-1、GPT-2大模型都是开源的,并公开完整发布的论文和权重、参数。但是从GPT-3开始,模型的权重就不公开了,只能 API 调用;论文只讲原理,不释放模型。直到GPT-3.5,则是彻底的闭源了,GPT-4系列以后都不再公开权重和参数。至此,OpenAI由原来的Open沦为了非常不Open了。
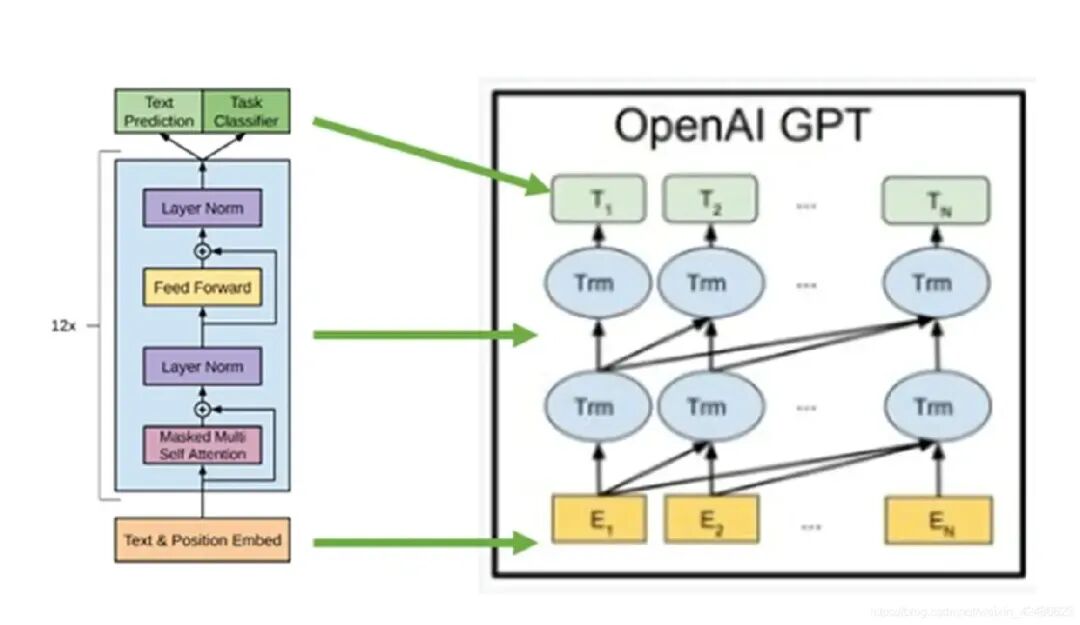
那么为什么OpenAI不再坚持开源了呢?首先他们官方给出的理由是为了安全。GPT-2 发布时他们就已经担心:大模型可以批量生成钓鱼邮件、虚假新闻、深度伪造文本、自动化恶意内容。到 GPT-3 时代,能力跃升巨大:一旦完整权重流出,任何人拿到模型,都可以脱离 OpenAI 的安全护栏、审核、限流,无限制做恶意用途。也就是说,如果仅仅是API 模式下,OpenAI 能加内容过滤、速率限制、日志审计,但是权重一旦开源,攻击者可以本地离线微调、绕过所有安全防护,OpenAI 无法管控。
当然,最重要的原因还是OpenAI从一个非营利组织转变为一个营利公司了。OpenAI 2019 年改组,引入微软投资。如果把旗舰模型权重开源,所有人本地跑,没人付费调用 API,就没有现金流支撑巨额算力投入。说到底,还是为了赚钱,如果没赚钱,那吃什么啊。
同时,OpenAI面临的竞争压力也是越来也大。虽然OpenAI是行业的先驱,但是并没有实现对同行的遥遥领先,后来的Anthropic的Claude、谷歌的Gemini以及中国的Deepseek,都是其强大的竞争对手。如果把 GPT-3、GPT-4 以及后来的更先进的大模型权重放出,竞争对手、大厂可以直接拿到模型,在其基础上二次微调、做产品,快速复刻 OpenAI 的能力,抢走市场。
但是在2025 年 8 月,OpenAI又回心转意,放出了GPT-OSS大模型,这也是被同行所卷,因为单纯的闭源并不能拉开与同行的差距,而且会使得自己的生态出问题。Meta Llama、Deepseek、Qwen等开源模型快速追赶,开源生态越来越强,OpenAI 需要抢夺开发者、企业私有化部署市场,所以推出GPT-OSS 开放权重模型,但它定位是开放权重的次级模型,并不是旗舰版的大模型,像GPT-6 Astra、GPT-6 Sol、GPT-6.1 Sol这种最强的主模型依旧闭源。