ARTICLE · 1197784
AI编码token太贵?这个Rust工具让Claude Code省2.7倍token!
日增 1,647 个 GitHub Star。
6,883 个 Star,持续加速。
Rust 编写,Apache-2.0 开源。
一行命令索引整个项目——AI 编码 Agent 终于不用盲目读文件了。
比 grep 节省 2.7 倍 token,比纯内存节省 26 倍。
今天就来聊聊,这个让 AI 编码 Agent 告别"grep 驱动"的本地搜索工具——XERJ。
AI 编码 Agent 的 token 浪费问题
你用 Claude Code 或 Cursor 写过不熟悉的代码库吗?
翻译一下:你的 AI 助手拿到一个陌生项目——它不知道从哪下手——于是它开始"grep 驱动"。
什么是"grep 驱动"?
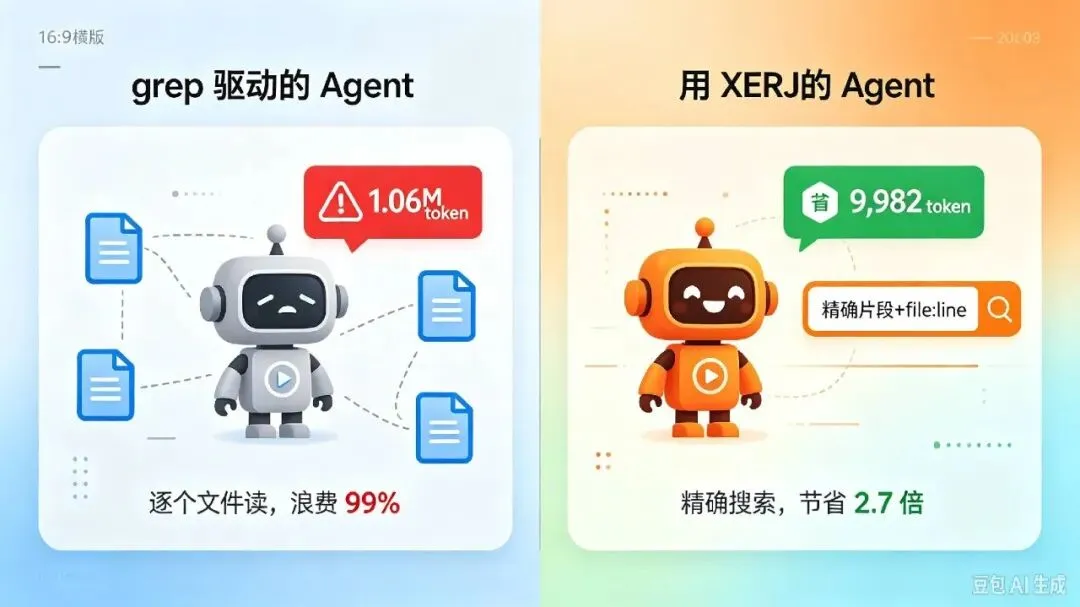
通俗说:你的 AI 助手像个"金鱼脑"——它不认识代码库,就逐个文件 grep,把整个文件读进上下文窗口,找到需要的代码片段,然后写代码。
问题:
一个文件可能只有 5 行代码有用——但 AI 把整个 500 行的文件都读了进来。
翻译一下:你花了 500 行的 token 钱,只用了 5 行的信息——浪费 99%。
实测数据:
在某个代码库上,grep 驱动的 Agent 消耗了 1.06M 输入 token——相当于一本《战争与和平》。
翻译一下:你的 AI 助手读了一本"小说",只是为了找到 5 行代码。
更惨的是"修复循环":
AI 写错了→你让它改→它又读一堆文件→又写错→又改→又写错→又改……
翻译一下:token 在燃烧,你的钱包在流泪。
XERJ 是什么?
XERJ 是一个本地 AI搜索工具——一行命令自动索引任何文件夹,Agent 直接搜索精确片段,不再盲目读文件。
翻译一下:XERJ 就像给 AI 助手装了一个"搜索引擎"——它不再逐个文件 grep,而是直接搜索它需要的代码片段。
核心能力:
1. 自动索引。
xerj autoindex ~/my-project一行命令——代码、文档、日志、PDF、SQLite、CSV——全部自动索引。
翻译一下:不用写 schema,不用配 pipeline——指向哪里,索引哪里。
2. 精确搜索。
xerj search "how do we rotate the WAL segment"返回精确片段 + file:line 行号——不是整个文件,是精确片段。
翻译一下:就像 Google 搜索——给你想要的结果,不是整个网页。
3. 符号级定位。
xerj def "euler_to_rotationmatrix"go-to-definition:定位符号定义的位置 + 签名。
翻译一下:就像 IDE 的"跳转到定义"——但跨文件、跨项目。
4. Elasticsearch 兼容。
现有 Elasticsearch 客户端直接可用——你的工具链无缝对接。
翻译一下:你不需要学新工具——Kibana、Logstash 直接用。
实测数据:2.7 倍 token 节省
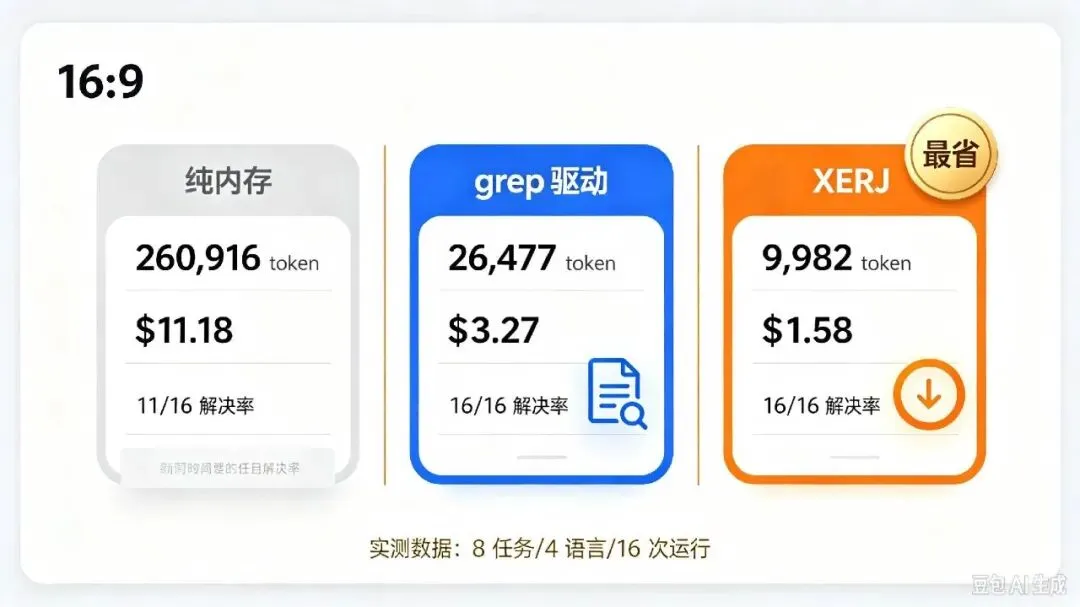
XERJ 团队做了 controlled study——8 个任务、4 种语言、16 次运行,对比三种方式:
| 纯内存 | |||
| grep 驱动 | |||
| XERJ | 9,982 | $1.58 | 16/16 |
关键结论:
1. 比 grep 节省 2.7 倍 token,成本降低 2.1 倍。
翻译一下:同样的任务,grep 花 1.58。
2. 比纯内存节省 26 倍 token。
翻译一下:纯内存方式花 1.58——省了 7 倍钱。
3. 单个 Java 任务最高节省 278 倍。
翻译一下:有些任务,grep 花了 278 倍的 token——XERJ 直接秒杀。
4. 日常开发用户报告约 5 倍 token 节省。
翻译一下:实测数据是 2.7 倍,但日常使用用户报告 5 倍——因为真实场景更复杂。
但要注意:XERJ 的价值受"记忆度"影响——私有代码、内部代码、小众代码、新代码,XERJ 优势明显。但对于流行的公共库(模型已经记住了),XERJ 优势不大。
翻译一下:你用 jQuery 写代码,AI 早就背下来了——不需要 XERJ。但你用公司内部框架,AI 不认识——XERJ 就派上用场了。
安装使用:3 步上手
Step 1:安装 XERJ
curl -fsSL https://xerj.org/get | sh一行命令——Rust 静态二进制,无 JVM,无依赖。
翻译一下:比 npm install 还简单。
Step 2:启动服务
xerj --insecure --data-dir ./data &后台运行——--insecure 表示关闭 TLS 和 API Key 认证(仅本地开发使用)。
翻译一下:--insecure 不是不安全——是你自己的机器,你就是管理员。
Step 3:一键接入 Claude Code/Cursor
xerj initMCP + Skill 自动配置——一行命令搞定。
翻译一下:装好就用,不用写配置文件。
五大使用场景
1. Reference Coding(参考编码)——核心场景
索引相似的开源项目——写代码前先查别人怎么解决的。
翻译一下:你要写一个"用户认证模块"——XERJ 帮你找到 3 个类似开源项目的实现——AI 先看别人怎么写,再写自己的代码。
这就是上面实测数据用的场景——2.7 倍 token 节省,16/16 解决率。
翻译一下:AI 不是"从零开始"——而是"站在巨人的肩膀上"。
2. Codebase Q&A + RAG
索引代码库——问机制返回精确片段而非目录列表。
翻译一下:你问"这个项目的数据库连接怎么配的"——XERJ 返回配置代码片段 + 行号,不是"你去 src/config/ 目录下看看"。
3. 安全审计
索引目标代码树——跨文件类型查询 sink 模式、密钥、危险调用。
翻译一下:你要审计一个项目的安全性——XERJ 帮你找到所有 SQL 注入点、硬编码密钥、危险函数调用。
4. 日志/事件分析
混合格式自动转为类型化索引——支持 Elasticsearch 聚合。
翻译一下:你的日志有 JSON、CSV、纯文本——XERJ 自动识别格式,创建类型化索引,你可以用 Elasticsearch 语法查询。
5. Agent 长期记忆
/_memory/{namespace} 存储 Agent 学习成果——下次按语义召回。
翻译一下:你的 AI 助手这次学到了东西——存进 XERJ——下次还能用。不再是"金鱼脑"了。
技术亮点
1. Rust 编写——单个静态二进制,无 JVM,无依赖。
翻译一下:启动快、占用小、不折腾。
2. tree-sitter 解析——代码带符号和行号,不是纯文本。
翻译一下:XERJ 理解代码结构——函数名、变量名、类名——不是简单的字符串匹配。
3. 自动推断——嗅探文件类型,自动创建类型化索引。
翻译一下:不用写 schema——XERJ 自己判断文件类型,自动索引。
4. MCP集成——xerj init 一键接入 Claude Code/Cursor。
翻译一下:装好就用,不用写配置文件。
5. 社区驱动——使用者提交 field report 即算加入社区。
翻译一下:你用 XERJ 做了点什么,写个简短报告提交——你就是社区成员了。
写在最后
XERJ 是 AI 编码 Agent 的"搜索引擎"。
6,883 个 Star,日增 1,647——Rust 编写,Apache-2.0 开源。
比 grep 节省 2.7 倍 token,比纯内存节省 26 倍。
一行命令——xerj autoindex——你的 AI Agent 就不再盲目读文件了。
适合谁用?
1. 用 Claude Code/Cursor 写不熟悉代码库的开发者。
2. 需要参考开源项目实现的 Reference Coding 场景。
3. 需要做安全审计、日志分析、Codebase Q&A 的工程师。
翻译一下:只要你用 AI 编码工具写代码——XERJ 就值得试。
GitHub: https://github.com/xerj-org/xerj
文档: https://xerj.org/docs
去试试,你会回来的。