ARTICLE · 1230767
AI每日新闻|常驻工具、后台助理与可验证工作
从能生成一次结果,到能持续做事,AI工具正在补上运行环境、验收和安全管理。本期整理10月21—22日发布或更新的10条资讯,涉及较早完成的研究会保留真实日期。
本地工具
01. MiniMax Mini App:把一次对话变成常驻工具
摘要:MiniMax 为桌面端本地会话带来 Mini App,让生成的工具在对话结束后继续运行。
它可以同时包含前端和 Node 后端,把文件和状态留在自己的目录中,通过插件安装,并与 Agent 双向调用。
这更适合需要反复打开的数据面板、文件处理器或内部小工具。使用范围是 macOS、Windows 桌面端的本地会话;应用以当前用户身份在本机运行,安装时仍要确认代码和来源可信。
来源:MiniMax|10月22日官方介绍
视频创作
02. 可灵4.0接入OpenArt,镜头控制更具体
摘要:可灵官方转发确认,Kling 4.0 已在 OpenArt 上线。
OpenArt 介绍了起始、中间、结束帧控制,以及最多10张参考图、文字或图片生成和视频编辑等功能。
对视频创作者来说,变化在于能更明确地约束镜头过程和参考内容,而不只描述一个大概结果。这里说的是 OpenArt 的接入与功能范围,具体使用额度、价格和其他平台开放情况应分别查看,不能直接套用。
来源:可灵官方、OpenArt|10月22日官方转发
漏洞修复
03. PHP关键漏洞披露,AI发现之后仍要完成修补
摘要:OpenAI 披露,Calif 使用 GPT-5.6 Sol 发现 PHP 严重漏洞,Wiz 也独立报告了问题。
PHP 维护者主导修复发布,多方进行了约两个月的协调,OpenAI 同时提供了版本检查工具。
对站点运营者,最实际的动作是核对所用 PHP 版本,并按维护方指引升级。AI 可以帮助寻找漏洞,但发现、修复、部署更新是不同环节;PHP 的使用规模也不能直接当作实际受影响站点数量。
来源:OpenAI|10月21日公告
后台助理
04. Claude Duet进入研究预览,开始处理后台事务
摘要:Anthropic 推出独立应用 Claude Duet,以研究预览形式向美国 Pro、Max 用户开放候补登记。
它可连接账户,每隔数小时检查一次信息,并在后台持续处理任务;电脑关闭后,虚拟机中的工作仍可继续。
它适合整理信息、草拟回复和跟进事务,但发送、付款、签署、删除等操作仍需批准。Duet 与 Claude 共享套餐用量,后台检查也会消耗额度;官方也提醒它可能误判事情的轻重缓急,不能当作可靠的全自动助理。
来源:Anthropic|10月21日发布
科研协作
05. 微软回顾KLS证明:关键在于人类引导搜索
摘要:微软研究院回顾了 KLS 猜想证明中的人机协作。
研究者引导 AI 探索大量证明路径,通过判断哪些方向值得保留、哪些应尽快放弃,把搜索逐步推进到有效结果。
这篇博客介绍的是已经完成的研究过程:证明在10月4日完成,并非10月22日才由 AI 独立解出。对科研工作的启发是,把问题拆解、评价标准和路径筛选交给有经验的人把关,往往比一味增加尝试次数更关键。
来源:Microsoft Research|10月21日博客;证明10月4日完成
生物研究
06. AI并行分析小鼠脑数据,结果仍需实验验证
摘要:OpenAI 与 PerturbAI、Scripps 介绍了利用大量 GPT-Rosalind 智能体并行分析复杂生物数据的工作。
机构报告称,对包含数百万小鼠脑细胞的全脑 CRISPR 图谱,系统在32分钟内完成了分析及文献解释。
这个时间对应计算分析环节,不包含完整实验流程,更不代表已经得到临床结论。它展示了把数据拆分、并行检索和综合解释结合起来的可能性;生成的机制解释和实验假设,仍需要后续实验检验。
来源:OpenAI、PerturbAI、Scripps|10月21日研究介绍
云端接入
07. OpenAI与Google Cloud合作,正式开放还要等
摘要:OpenAI 宣布与 Google Cloud 合作,计划把模型和 Codex 带到 Model Garden。
官方表示,正式可用时间在未来数周;这是一项已公布的合作安排,还不能写成所有用户现在就能直接使用。
对已有 Google Cloud 采购和技术体系的企业,这意味着未来有望在熟悉的平台上接入更多模型,并通过 Marketplace 采购、使用符合条件的云支出承诺。实际型号、地区、价格及上线范围仍应以正式开放信息为准。
来源:OpenAI|10月21日公告
智能体训练
08. WorkForge更新:让智能体在可验收的环境里训练
摘要:腾讯与复旦团队的 WorkForge 论文于10月21日更新至 v4,混元官方在22日作了介绍。
它从真实工作文件构建训练环境,并让任务要求、解题方案和程序及语义两类校验器,都能追溯到工作区里的具体证据。
论文报告构建约1.67万个环境,覆盖40个专业领域和60类文件。它针对的是长流程智能体训练与验收,实验成绩属于论文所设定的模型和基准条件;价值在于让“做完了”可以检查,而不是只看回答是否像样。
来源:腾讯混元、复旦团队论文|10月21日v4更新;10月22日官方介绍
技术教程
09. IBM分享四模型预测配方,减少单模型选型试错
摘要:IBM Research 分享了 Granite 时间序列集成预测教程,用统一接口组合四个预训练模型,无需重新训练或拟合集成权重,就能输出中位数与分位数预测。
它提供等权概率融合和按区间宽度调整权重两种方法。
这是一篇新教程,不代表四个基础模型都是今天发布。对销量、负载等预测任务,可以先用默认配方做回测;集成会增加时间和内存开销,也不保证每条序列都更准,当前配方还不利用不同通道间的信息,扩展成员时要另查许可。
来源:IBM Research|10月22日15:51教程发布
持续安全
10. Claude Security增加持续扫描与修复跟踪
摘要:Claude Security 在面向 Claude Enterprise 的公开测试中,增加持续扫描和修复跟踪。
系统先建立代码基线,再定期检查变更,并围绕跨仓库项目组织问题、威胁模型和相关知识。
修复上线后,系统可以把问题标为已解决,问题复现时再重新打开。这让安全检查更接近日常开发流程,但目前的开放范围是 Enterprise 公开测试,扫描结果仍需要团队判断优先级和确认修复,不能视作安全保证。
来源:Anthropic|10月21日更新
今日观察
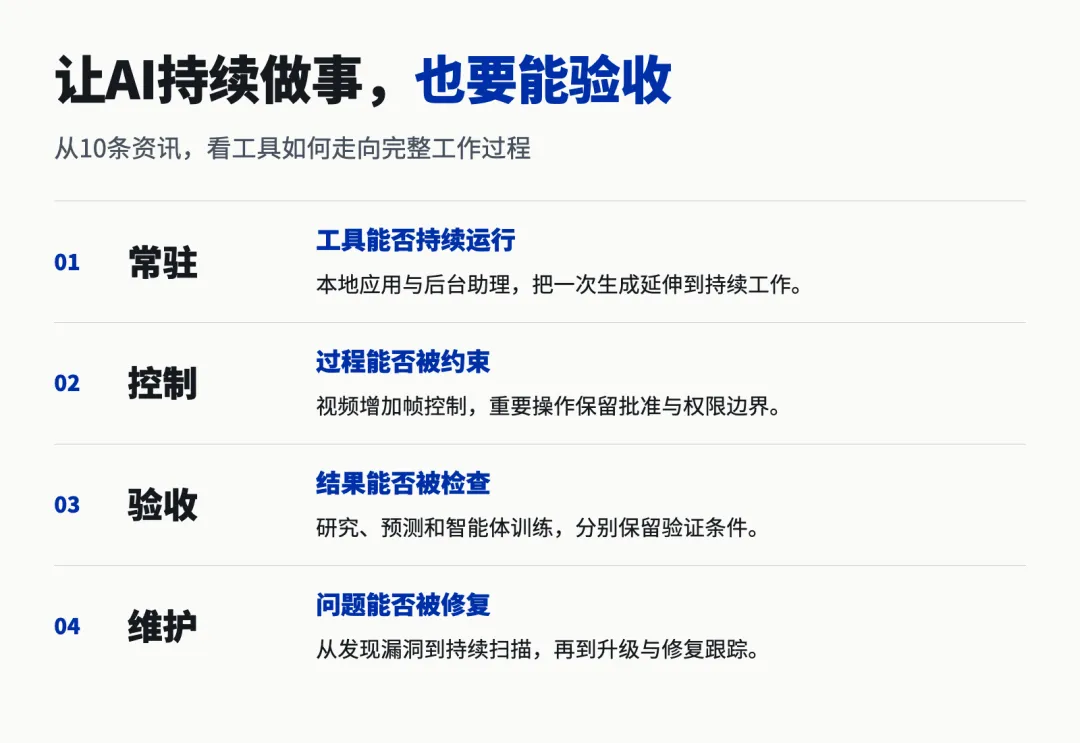
这些进展放在一起,指向的是更完整的工作过程:工具要能持续运行,结果要能检查,错误要能跟踪修复。
选择时可以先问三个问题:现在是否向自己开放,输出能否验收,持续运行的成本与权限是否可控。把这些确认清楚,再决定接入哪一个环节。