ARTICLE · 1239878
【上午发通知下午交】AI台账助手:花样翻新的表,让 AI 替你填
基层台账资料检查最烦的是:表格花样翻新,几千户农户数据报表按格式填,上午发通知下午交!
这些表格填报有个共同点:信息散在几百行台账里,表格却要求你写一段话。一户人家的家庭人口、劳动力、务工地点、工资性收入、刚性支出、综合研判,全得从摸排表里一条条找出来,再揉成一段规范表述填进单元格。
比如要从下面这张表里:
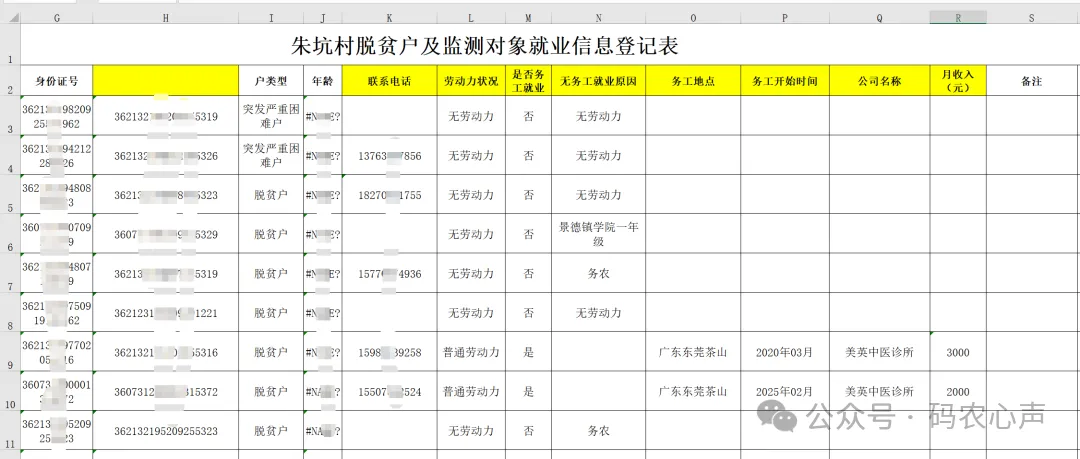
源表:村级脱贫户和监测对象就业摸排表,一户一行、几百行,成员、务工、收入全在里头
提取信息,自动算年龄,自动算每户各项收入,填写到上级发的表的对应单元格中:
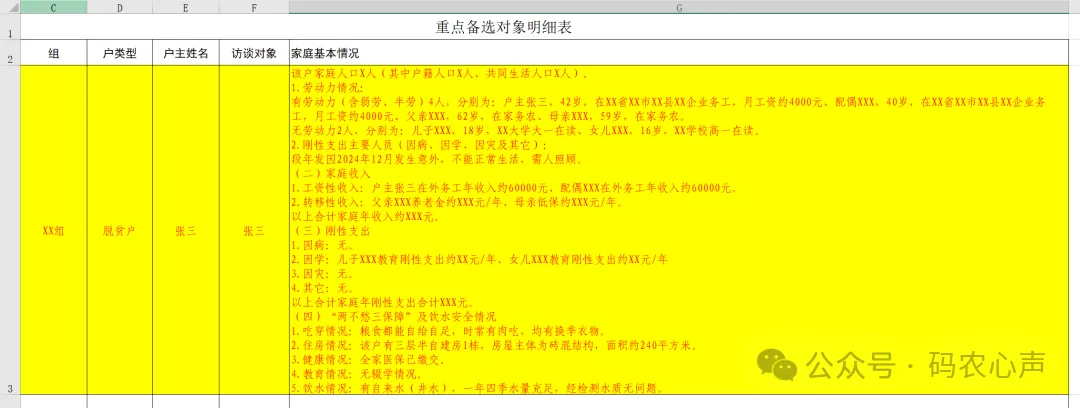
目标表:上面发下来的「重点备选对象明细表」,最后一列要写一段话
一户五分钟,一百户就是一整天,还容易漏人、算错。
AI台账助手 就是为这件事做的:源表先入库,你把空白列交给它,它按户主去台账里找齐这户的全部记录,大模型按你的要求写成一段话,直接写回 Excel。全程跑在你自己电脑上,数据不出门。
01
它一共四件事,按顺序来就不会乱
新版把功能按流程重排了一遍,顶栏就是一条流水线:① 放资料 → ② 查资料 → ③ 出 Word → ④ 填 Excel。打开首页是一张「使用指南」,四张卡片写清楚每个入口什么时候用、第一步点哪里,不用记菜单。
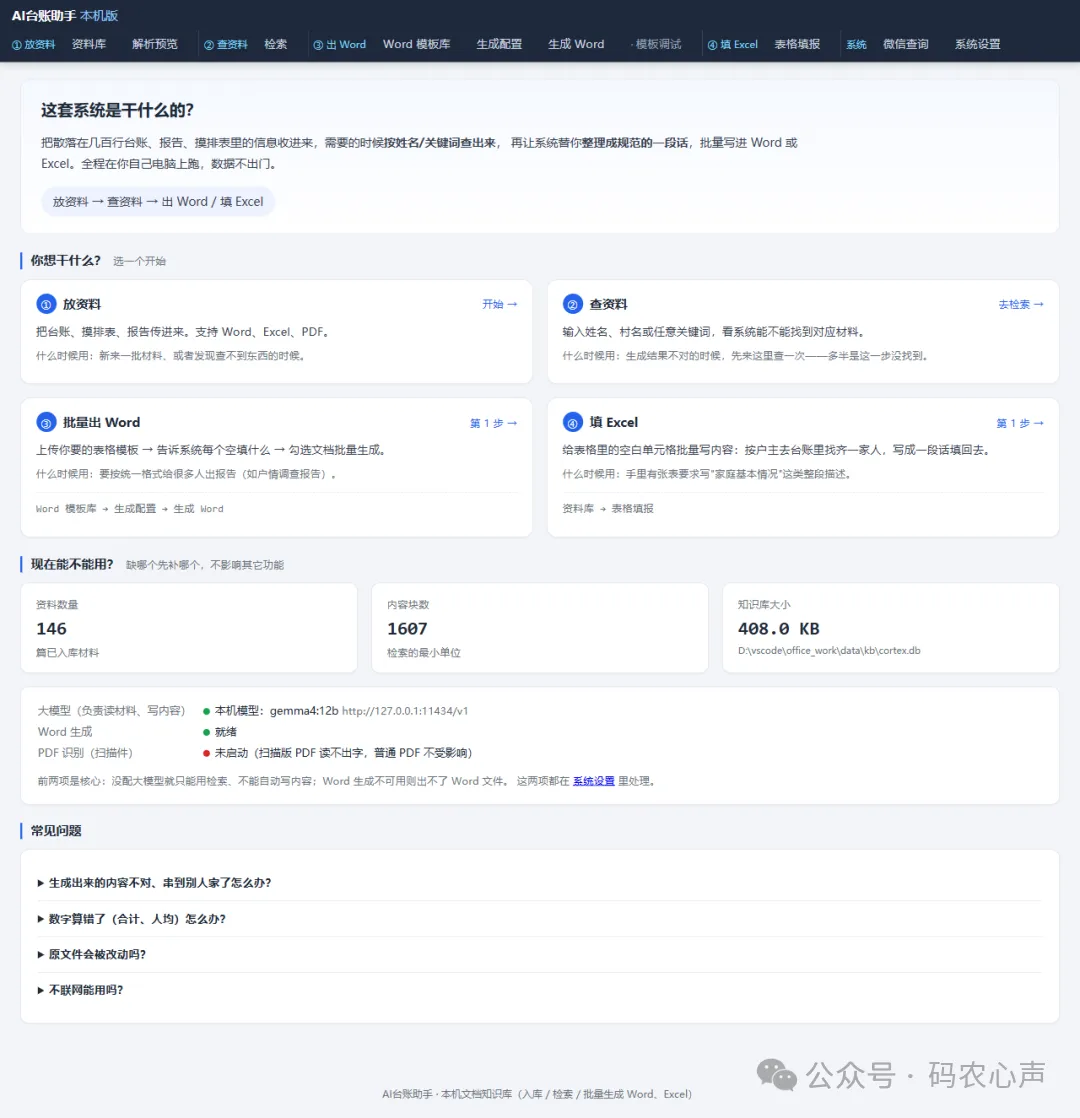
首页就是使用指南:你想干什么 → 点哪个入口;下面还会告诉你「现在能不能用」,缺什么补什么
第一步,放资料。Word、Excel、PDF 都收,扫描版 PDF 会走 OCR 认字。三种放法:直接传文件、填本地路径解析、或者给个目录后台批量入库(带进度条,大目录不会把页面卡住)。入库时会解析正文和表格、切成块,同一份文件重复入库会自动跳过,不会越堆越乱。
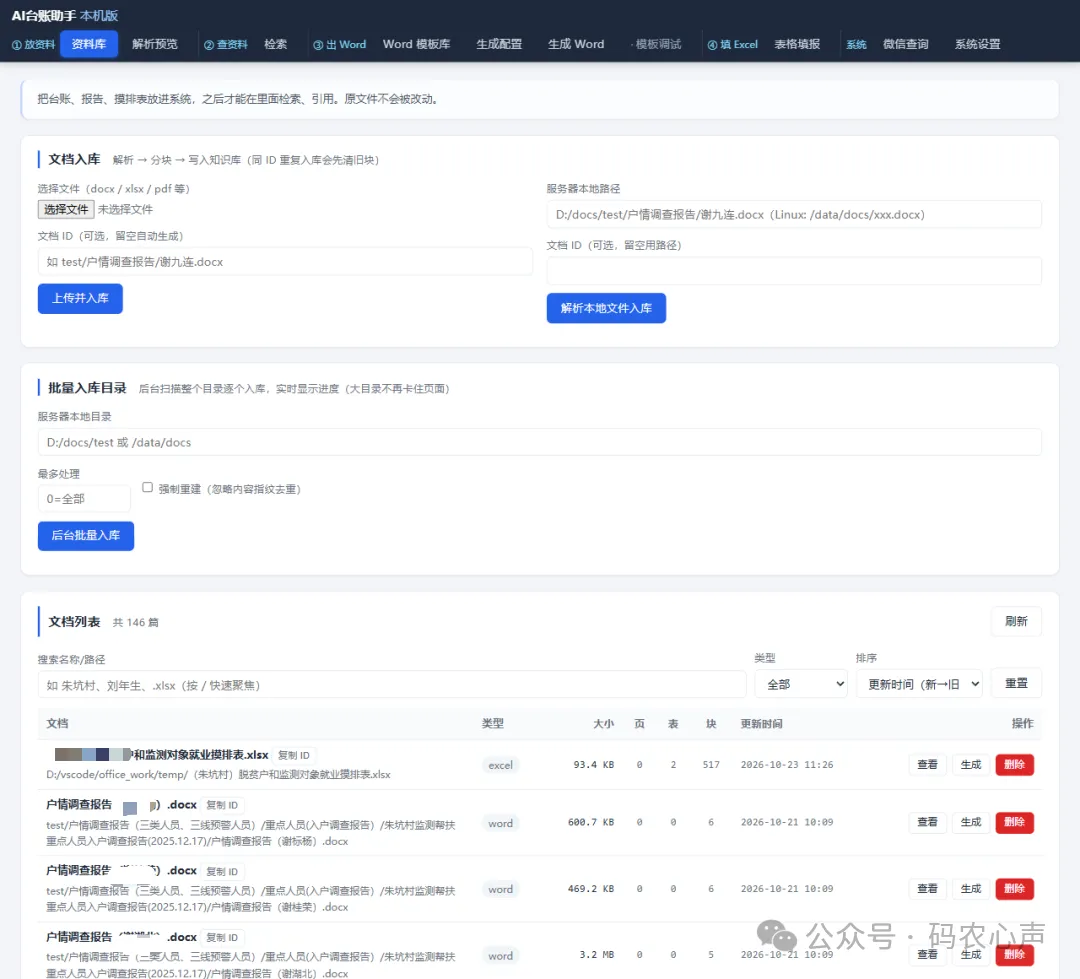
资料库:上传 / 解析本地文件 / 后台批量入库;下面是已入库清单,146 篇一目了然
第二步,查资料。输入姓名或关键词,看系统能不能把这一户的材料捞出来,结果会标出「来自哪个文件、哪一段」。这一步是后面所有生成的地基——生成结果不对,先回来这里查一遍,多半是材料没进去或名字写法不一致。
第三、四步就是出活儿:要 Word 走「Word 模板库 → 生成配置 → 生成 Word」三步;要填 Excel 走「表格填报」。下面重点说填 Excel,因为它是被催得最急的那种。
02
表格填报:五步,自动填表大概30秒完成
配置一次,以后每张同类型的表都能复用。第一次用照着点:
第 1 步 把源表入库。到「资料库」把这张就业摸排表传上去(或填本地路径解析)等它跑完。这一步不做,后面就查不到材料。
第 2 步 填配置。打开「表格填报」,四项填完就行:
· 匹配列:目标表里用来去台账找人的那一列,这里填「户主姓名」。源表那列叫「户主」也没关系,系统认户主 / 户主姓名 / 姓名这几个别名。
· 检索范围:限定到这一份摸排表,别让同村几百户的材料混进来(可选整个知识库 / 指定文档 / 路径前缀)。
· 填报列:要写的目标列名,填「家庭基本情况」。
· 填写说明:就用大白话写要哪几段、每段写什么、缺了怎么标。这一段是全篇最值钱的地方,我用的版本贴在下面,可以直接抄。
根据源材料(该村脱贫户/监测对象就业摸排表),按如下结构撰写该户的家庭基本情况,平实公文语;缺失项用【待补充】标注:(一)家庭人口:共几人,户主及成员姓名、与户主关系、年龄。(二)劳动力及务工:逐人列年龄、劳动能力、是否务工、务工地点/单位、月收入。(三)工资性收入:逐人务工年收入合计,家庭年工资性收入总额。(四)刚性支出:教育、医疗、住房等大额支出(无则写无)。(五)两不愁三保障:饮水、义务教育、基本医疗、住房安全情况。(六)综合研判:收入是否稳定超过监测线,是否存在返贫风险。
填完点「保存」,配置就留在库里了。下个季度换了张表,改改列名和说明就行,不用再配一遍。
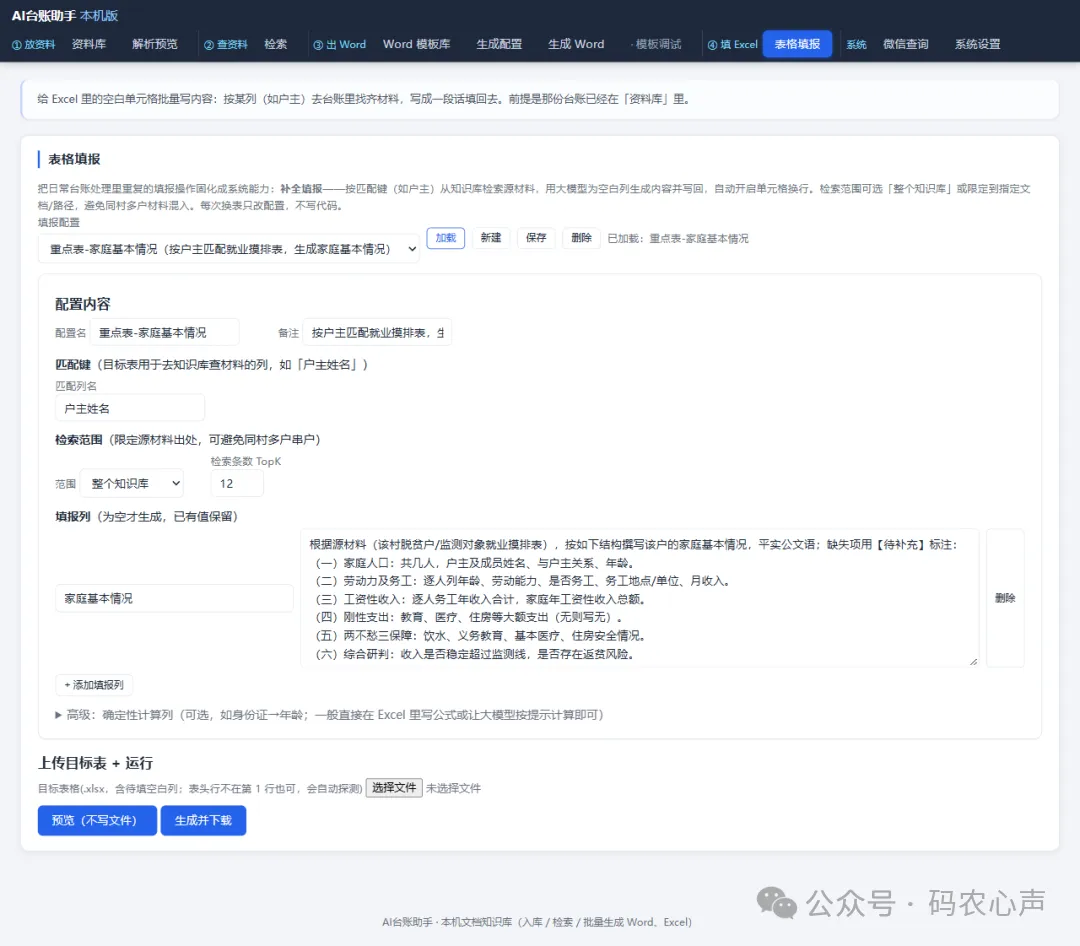
表格填报页实拍(已加载保存好的配置):匹配列、检索范围、填报列和填写说明都在一页里
第 3 步 上传上级发的目标表。表头不在第一行也没关系(很多上级表格第一行是合并的大标题),系统会自动往下找表头。
第 4 步 先点「预览(不写文件)」。它会把每一行打算填什么列出来给你看,逐行扫一眼有没有串户、有没有整段【待补充】。这道人工把关别省,原因后面会讲。
第 5 步 「生成并下载」。出来的还是 xlsx,格式、行高、原有内容都不动,只把空着的列补上,单元格里自动换行。字数多的话单行会比较高,这是正常的。
03
它内部到底怎么干的
逻辑很朴素,四步:按匹配键检索 → 组装源材料 → 大模型按填写说明生成 → 写回单元格并自动换行。
关键在于「组装源材料」这一步:不是把整份台账丢给模型(几百行、上下文根本放不下),而是只捞这一户的那几行,再带上列名一起送进去。所以匹配列和检索范围这两项填得准不准,直接决定结果准不准。
「填写说明」是自然语言,写在页面上就行,改口径不写代码。原来每个季度换一张表就要找程序员改一次脚本的日子,到此结束。
04
最难的一户:名字在 72 户里都出现过
第一版跑出来就翻车了,而且是那种最要命的翻车:串户。给谢xx这一户生成的「家庭人口」里,混进了别人家的成员。
查下去发现两个原因。第一,谢xx本人就是几十户的摸排人——他的名字在别人的行里以「摸排人」身份反复出现。检索按相关度排序,这些短行把候选名额占满,他本户那 5 行成员记录根本挤不进来。第二,目标表匹配列叫「户主姓名」,源表里那一列却叫「户主」,两者对不上,主体行判定直接失效。
改法也就两条,都很土但有效:过量取回——先捞 150 条候选(摸排人行再多也挤不没本户),再只认主体行——文本里必须是「户主(或户主姓名/姓名):谢xx」这种形式才算本户记录,仅在联系人、干部字段出现的一律丢弃;两个级别都为空时才退回「包含姓名」。
改完之后,谢xx户的 5 名成员一个不少、一个不多,务工地点、公司、月收入与源表逐项一致。这类「同名不同户」的坑,在村镇台账里非常普遍——光靠向量或关键词检索解决不了,必须在取回之后做实体锚定。顺带还堵了一个更隐蔽的:模型爱在末尾补一行「成员姓名【待补充】」凑数,现在明确禁止——成员写几个就是几个。
05
本地小模型横评:能算对收入的只有一个
找准了材料,剩下的就全看模型。用谢xx户当真题(真值:5 人年收入合计 162000 元、人均 32400 元),在同一台 AMD 780M 核显笔记本上把几代小模型挨个跑了一遍,都是 Ollama 本地跑、都不联网。
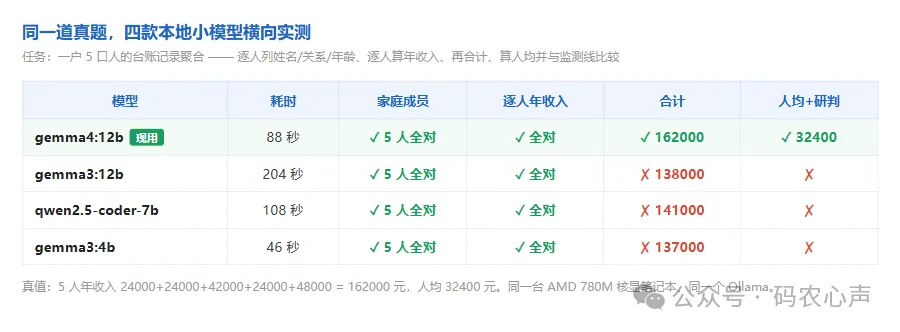
四款本地小模型实测——成员和逐人收入都认得出来,差就差在最后那步加法
结论有点残酷:四个模型都能把 5 个人、关系、年龄、逐人年收入(月收入×12)全部写对,但只有 gemma4:12b 把合计和人均也算对了。7B、4B 级模型栽的都是同一步——把五个两位数乘十二再加起来。这不是理解能力问题,是算术稳定性问题,而这恰恰是基层报表最不能错的地方。
速度上也有意外:gemma4:12b 只用了 88 秒,比它上一代 gemma3:12b 快一倍多。原因下一节讲,是个「想太多」的故事。
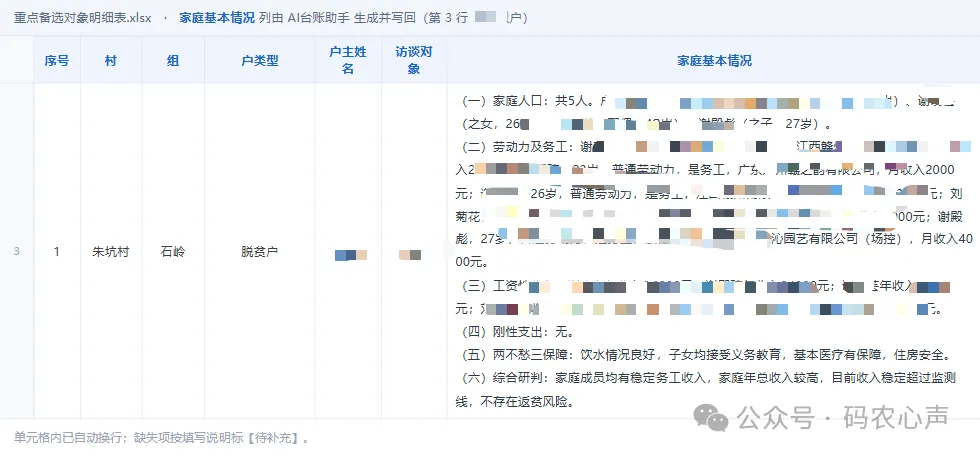
实际写回单元格的内容(真实生成结果):人口、务工、收入、研判齐全,合计 162000 与人次逐项对得上
06
「思考型模型」的空输出陷阱
刚换上 gemma4 时遇到一件怪事:跑了 482 秒,返回的正文一个字都没有。表格里是空单元格,日志里没有报错,像什么都没发生。
排查下来是「思考型模型」的锅:它把推理过程写在思考通道里,正式回答还没开始,就被上层的输出上限截断了——于是你拿到一个耗时不短、内容为空、还显示成功的结果。通过 Ollama 的 OpenAI 兼容接口调用时,要传 reasoning_effort: "none" 才能关掉思考直接出正文;常见文档里的 think:false 在 /v1 端点上并不生效。
顺手还补了两个隐性问题:接口超时原来写死 120 秒,本地 12B 模型一次生成要两三分钟,超时了也只是一格空白;另外模型不会主动把月收入折成年收入,得在提示里明确写「年收入 = 月收入 × 12,逐人折算后再合计」。这两处一改,才有前面那张全对的表。
07
模型在设置页换,点保存就生效
之前换模型得改配置文件、重启服务,现在「系统设置」里三行填完就行:接口地址、模型名、API Key。填本机地址不用 Key,填云端地址必须填 Key;保存即时生效,正在跑的任务也不用等。
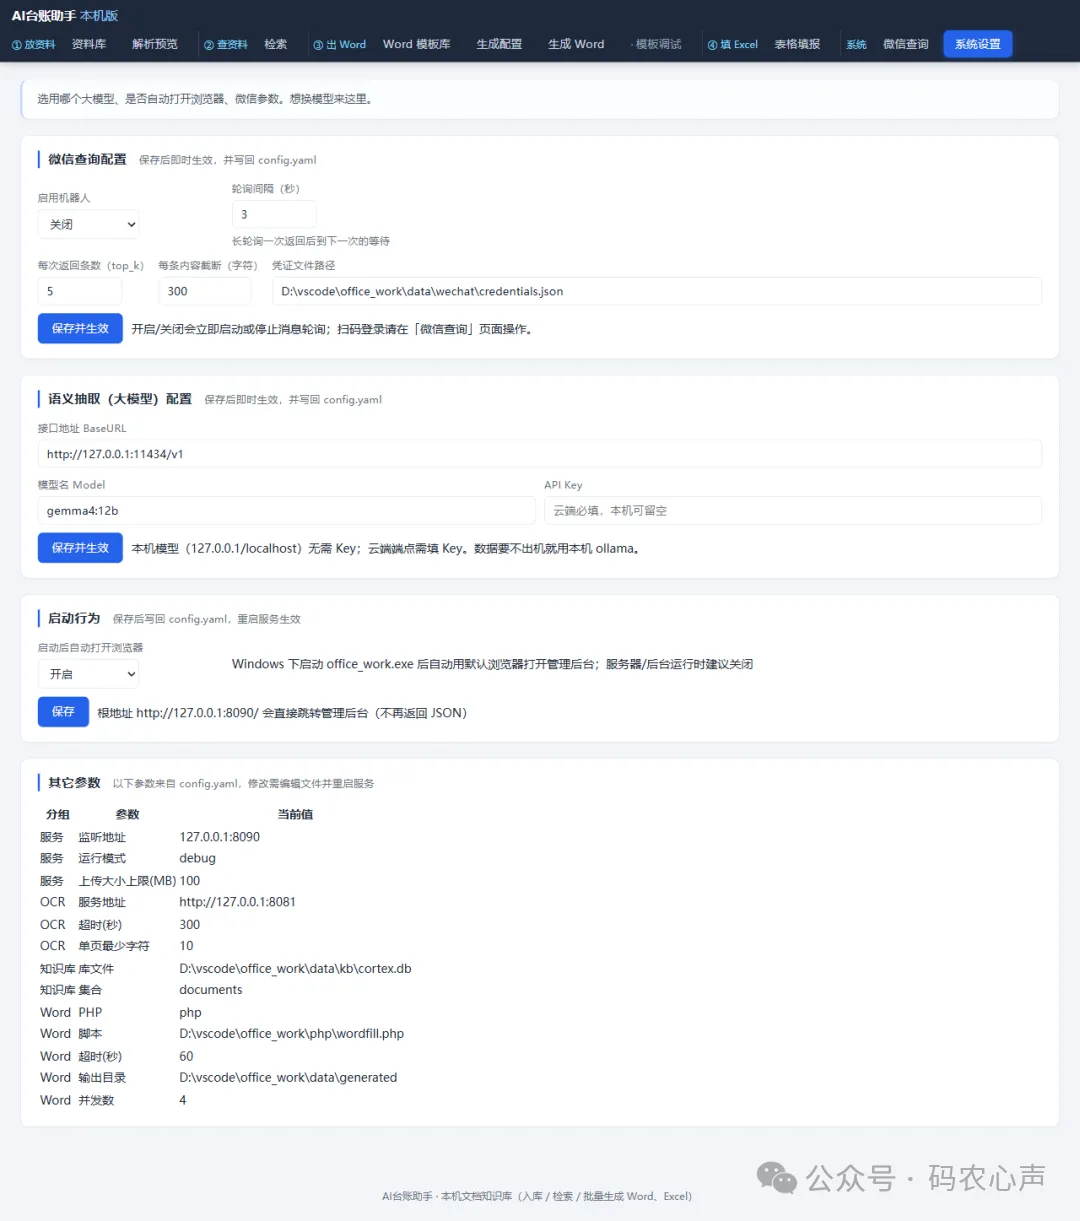
系统设置里的「语义抽取(大模型)配置」——本机模型留空 Key,云端模型填 Key
这个口子也意味着:数据敏感就全走本机,本机算力不够或者要处理大批量,就在同一处换成云端模型,业务配置一行不动。表格填报、Word 生成、字段抽取三条链路共用这一个模型配置。
08
同一个库,出 Word 也是三步;微信里也能问
上级要 Word 的时候,走的是另一条线:上传空模板(系统自动读出里面的 ${占位符})→ 给每个空写一句要求 → 勾选文档批量生成。每页页头都会标「第 2 步 / 共 3 步」和上一步/下一步,第一次用也不会走丢。
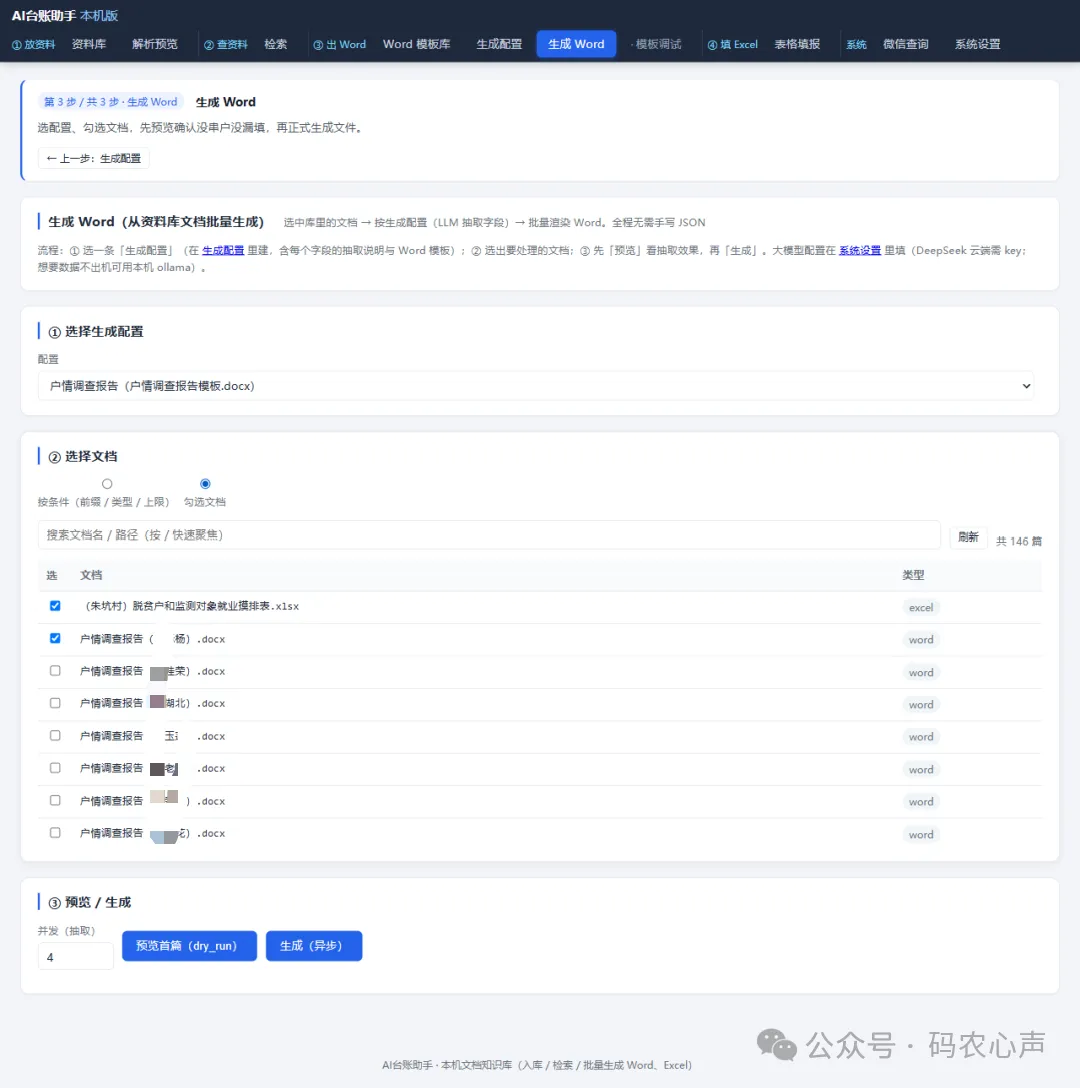
生成 Word 页:选配置 → 勾文档 → 先「预览首篇」看抽出来的字段对不对,再批量生成
另外还绑了个微信查询机器人:扫码登录后,在微信里发一句话就能查库——「某某家有几口人、务工几人在哪、年收入多少」「某村有多少三类人员」,它按资料原文回复,不做任何命令执行。
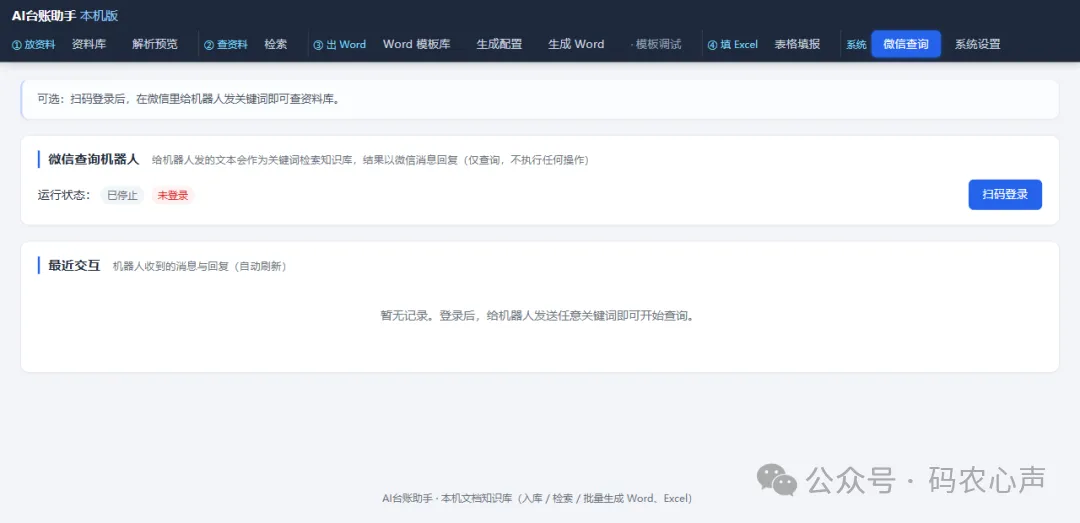
微信查询页:扫一次码就能用,查什么直接发消息,结果按资料原文返回
09
几句实话,别把它当签字笔
这套东西现在的定位,是把「找材料 + 写初稿」这段最耗时的活干完,不是替你签字画押。所以:
一户一表先跑预览。小模型的算术仍然不稳,12B 在长上下文下也可能把合计算错。数字类的格子,预览时扫一眼合计和人均,比事后返工便宜得多。
整段【待补充】不是 bug,是信号。它说明这一户的材料没检索到——要么源表没入库,要么这户的档案是另一份文件、名字写法对不上。回「检索」查一次,基本都能定位。
大户、重要报表换云端。五口之家本地 12B 够用;十几口人、材料上百行的户,把钱花在云端模型上是值的——这类任务一天也就几十户,成本可以忽略。
材料质量决定上限。台账里名字写法不一致、列名各叫各的(户主 / 户主姓名 / 姓名),都会让检索失准。系统做了别名兼容和主体锚定,但从源头把台账规范好,永远比事后修补划算。
从「一户五分钟」到「一户十秒 + 一眼核对」,省下来的是整天的时间。上级表册照样随时花样翻新,上午发通知下午就要——只要库喂好了,要什么表样、拆单元格还是合段落、要 Word 还是要 Excel,改一改填写说明就行。
你们那张最烦的表长什么样?留言说说行数、列数、要写几段话,我可以拿真实表格再跑一轮,看这套填报能覆盖到什么程度。
以上数据截图都已脱敏,不泄密真实信息