ARTICLE · 1246957
让 AI 助手画零件图,尺寸不能靠它猜
让 AI 助手画零件图,尺寸不能靠它猜
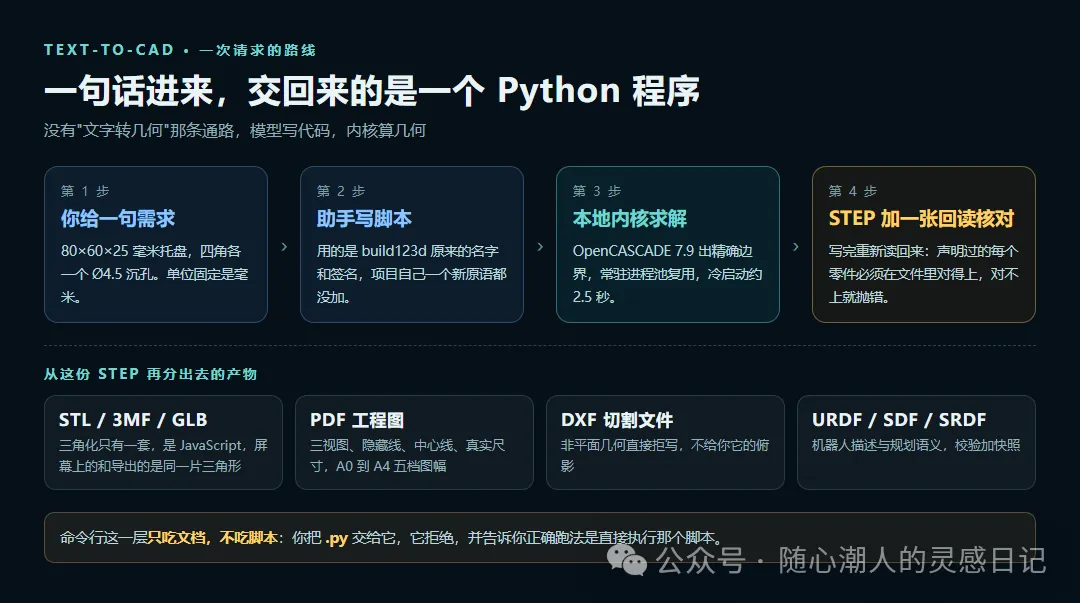
我在 Claude Code 里说了一句:做一个 80×60×25 毫米的安装托盘,四角各一个 Ø4.5 的沉孔。助手没有回给我一张渲染图,它在项目里写了一个 Python 文件,跑了一遍,硬盘上多了 STEP、STL、3MF、GLB 四种模型文件,外加一张带标题栏的 PDF 图纸。全程在我这台机器上,没有任何一次把几何丢给远端服务。
干这件事的插件叫 text-to-cad[1],仓库里那句自我介绍是"给你的助手加上 CAD 超能力"。它由两层组成:一层是 12 个技能文件,告诉 AI 助手该按什么步骤做;另一层是一个叫 cadgen 的 Python 包,把 OpenCASCADE 7.9 这个工业几何内核、build123d 这套建模 API、一个本地查看器和一堆校验器捆在一起。Python 3.11 以上就能跑,MIT 协议。
我把它拉到本地翻了几天,原本想弄清楚"说句话就出一个 3D 模型"这件事能做到什么程度,最后被吸引住的却是另一个问题:它怎么防止 AI 在没人看着的时候乱填数字。
它不做"一句话生成模型"那件事
先说一个容易误会的地方。text-to-cad 里没有"文字转几何"这条通路。你把描述丢过去,助手要做的事是写一个建模脚本,然后运行它。
cadgen 的命令行只吃文档,不吃脚本。你给它一个 .py,它会拒绝,并告诉你正确的跑法是直接执行那个脚本。这条规矩在 packages/cadgen/README.md 里是第 7 条定律,实现落在 _internal/doors.py,抛出的错误直接点名该用哪个命令跑。
更反直觉的是,这个包自己一个新几何原语都没造。方体、圆柱、拉伸、旋转、倒圆角、布尔、阵列,全是 build123d 的东西,cadgen 只是把它们原样透出去。build123d.py 这个模块的注释把理由写得很直白:同名字、同签名,永不改进。因为大模型在训练里见过的就是 build123d 的本来面目,你给它套一层自己的壳,等于让它把已经学会的东西重新学一遍,还容易记岔。
壳还是有的,只是薄。六个装饰器负责"我要什么格式的产物":@step、@dxf、@stl、@glb、@threemf 加一个 @eng_drawing;八个格式模块一共导出 15 个公开动词,做读取、构建、出图这类事;命令行有 24 个子命令,负责把已有文档转格式、校验机器人描述、渲染快照。工程图是唯一的例外,它没有动词,因为它的输入是一个在 Python 里拼出来的图纸对象。
这套设计的取舍很清楚:不追求"说一句话就出一个能看的模型"那种惊艳感,而是让助手去干一件它可以被检查的活。脚本写错了会报错,跑出来的文件是精确的边界表示,不是网格里长得像那么回事的一坨三角面。
它把"模型会算错"当成白纸黑字的前提
这是我打算抄到自己项目里的一部分。
skills/sdf/references/llm-guardrails.md 开头一句话定了调:这个技能假定模型擅长把 SDFormat 文档组织成合理的结构,不擅长悄悄推算出精确的空间、物理和仿真器相关的数值。
然后它把"不擅长"摊开成一张清单,一共九类,不许模型自己推断:每个 link 的位姿、参考系变换、关节原点;从"看起来朝哪边"倒推出来的关节正方向;mesh 的单位、缩放和坐标系约定;只看外形就猜出来的质心和惯性张量;插件文件名、参数、话题名、命名空间;某个碰撞几何在物理上稳不稳定;外部 URI 在部署环境里能不能解析。
猜出来的数字不许藏在裸 XML 里。文档给了一个来源优先级,五个档位:用户写明的要求、上游几何或机器人描述里的原始数据、目标仿真器的官方文档、带方法说明的测量或计算结果、写进台账注释并同步到最终报告的显式假设。
它甚至贴了一组对照。鼓励这么写:
<!-- Source: project CAD frame export. RPY radians. --><poserelative_to="base_link">0.18 0 0.12 0 -0.2 0</pose>不鼓励这么写:
<pose>0.18 0 .12 0 -11.5 0</pose>后面这条没说参考系、把角度单位当弧度用、数值来路完全无从审计。三个毛病都不致命,等到机器人真的动不起来才致命。
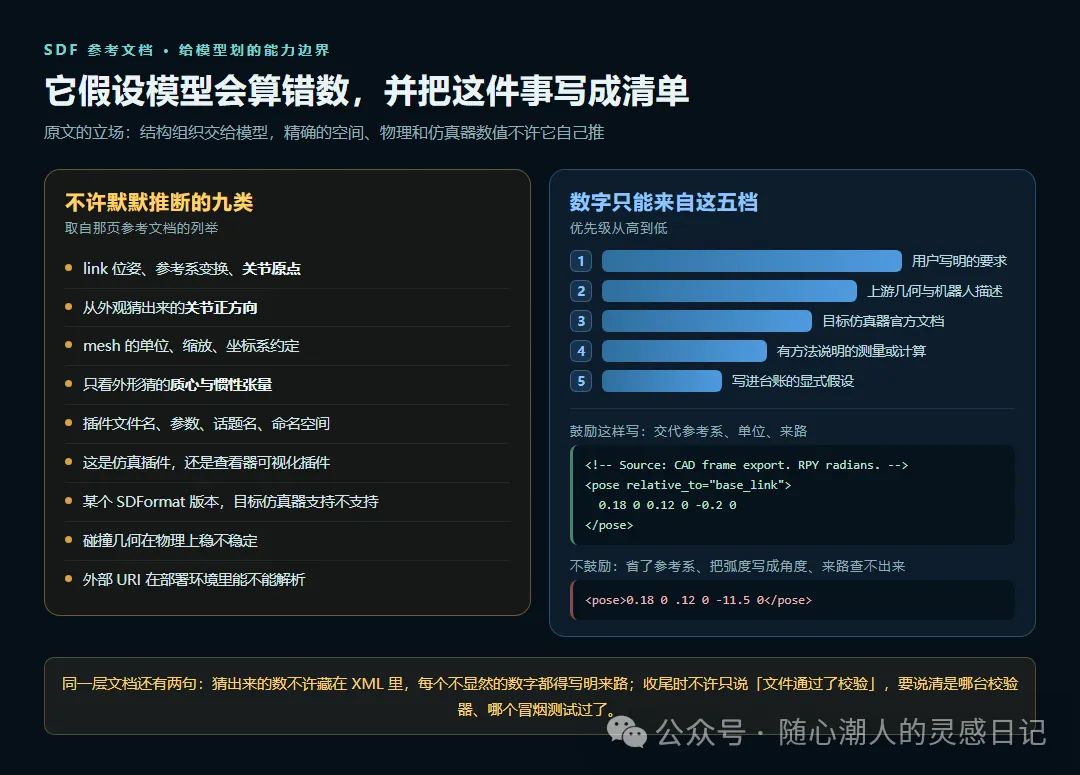
同一层文档里还有两句更硬的。URDF 技能写:凡是算出来的数字都不许徒手填,惯性张量、跨几十个 link 的单位换算、镜像对称的变换,一律计算得出。SRDF 技能写:不要凭记忆敲任何 link 和 joint 的名字,先把 URDF 里的表抽出来,再从表里抄。
这三句话戳中了我自己踩过的坑。让助手改一个四轴机械臂的 URDF,它最容易在"这个关节的正方向到底是哪个"上出错,而且不会报错,只会给你一个转身方向反了的机器人。
工具只报事实,判断写在文档里
技能层一共 85 个文件、9,198 行。这里面 12 份 SKILL.md 入口只占 1,771 行,另有 43 份 references/ 共 5,329 行,等模型按需去读。入口的作用基本就是"这是什么任务、第一步做什么、细节在哪个文件"。
打印可行性检查(DfAM)这条线上有两个脚本,一个测网格可打印性,一个测注塑。它们的模块注释都自报家门:只出事实,不吐 pass/fail,合格不合格由流程和参考文档去判。
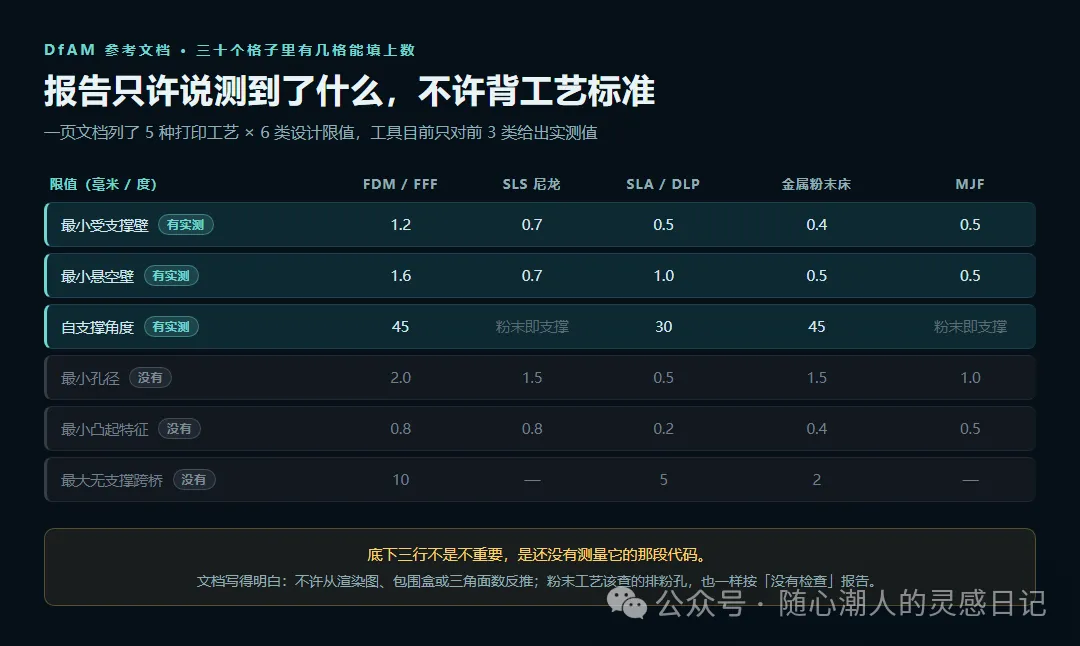
工艺限值确确实实存在,它们写在 references/process-limits.md 的一张表里,5 个工艺(FDM、SLS、SLA/DLP、金属粉末床、MJF)乘 6 项极限,30 个格子。最小受支撑壁从 FDM 的 1.2 毫米到金属粉末床的 0.4 毫米,自支撑角 FDM 和金属都是距水平 45 度,粉末床工艺那一栏写着"不适用",因为有粉末自身撑着。出处注明是 Hubs、Formlabs、HP、EOS 的设计指南,加上 ISO/ASTM 52910 和 52911-1 两个标准,并且要求用户提供厂商数据表时覆盖默认值、注明来源。
有意思的是紧接着那段诚实说明。6 项极限里,脚本真正测得出的只有 3 项:最小受支撑壁、最小无支撑壁、自支撑角。剩下三项,最小孔径、最小凸起特征、最大无支撑跨度,目前没有对应的测量。文档要求把它们当成"未检查"报出来,不要从渲染图、包围盒或者三角面数量里推一个数出来。那句话我读了两遍:背后没有测量的限值,不是一条发现。
壁厚这件事也被认真对待。测量是按连通体分别做的,一个装配里如果射线穿过了配合间隙,本来会把两条零件之间的缝隙记成壁厚,所以宁可分开测也不合并。采样点按面积加权,最少 64 个。依赖缺失的处理更细:如果 scipy 没装,报告里会缺壁厚数据,而一份"缺数据"的报告和一份"这零件没有薄壁"的报告长得一模一样,所以脚本用退出码 2 标记 PARTIAL,把没测到和测出零分开说。
坑也写进文档。注塑那份参考里提醒:壁厚读数里的 max_mm 别信,它沿面法线只射一条射线,读回来的是一块板的长度而不是厚度。支撑体积那一栏自带标签,说明它只是从面质心到打印板拉一个棱柱的粗略上界。朝向候选只有 6 个轴对齐旋转,不多不少。
一张图纸上能塞多少护栏
工程图那条线最值得看。
它用 ezdxf 当内存里的绘图引擎,但没有任何 .dxf 落盘,最终产物就是一张 PDF。车间收到的是那张 PDF,这就够了。图幅 A0 到 A4 五档,全部横向;视图方向 7 个(上下前后左右加等轴测);比例 11 档;线层按 ISO 128 建了 7 个,线宽从 0.5 毫米到 0.18 毫米;标题栏固定 180×40 毫米。
真正让我服气的是几处校验。
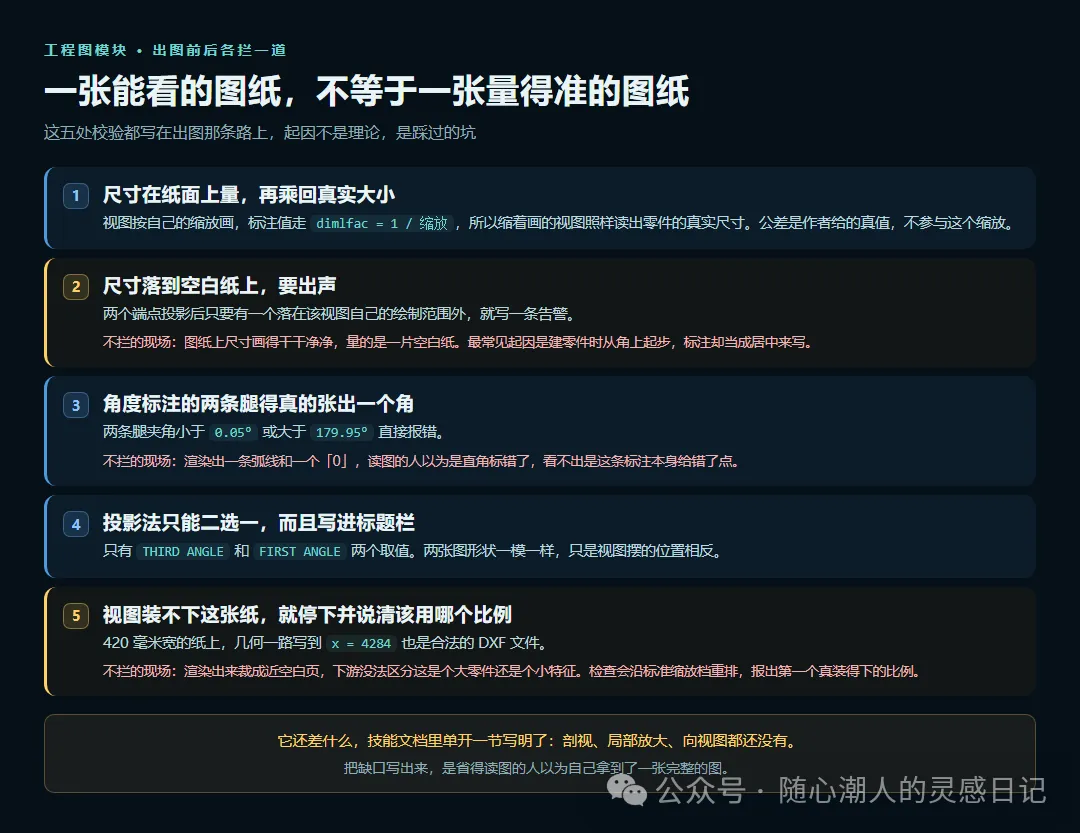
尺寸不是照抄作者写的常数,是从纸上量回来的。同一个视图可以有自己的比例,代码把 dimlfac 设成比例的倒数,让标注打印回真实尺寸。
有一个专门检查"量在空白纸上"的守卫。两个端点投影到纸面之后,如果落不进这个视图自己画出来的范围,就报一条警告。注释解释了最常见的成因:零件是从角上建的,作者却把坐标当成居中处理了。这种情况下尺寸线照样画得漂漂亮亮,量的地方什么都没有。
角度标注之前,两条边先重测一次。夹角小于 0.05 度或者大于 179.95 度就报错,因为两条腿共线就没有角度可标,硬画出来会在一段没有半径的弧旁边印一个 0,看起来像是直角测错了,实际上是给错了点。
投影方式只允许两个字符串,THIRD ANGLE 和 FIRST ANGLE。写代码的人给的理由是:标题栏印这个词,视图排布按这个词来,接受任意字符串就会允许"FIRST ANGLE"盖在第三角的排布上,而这是车间没法挽回的那一种错标。
文字排版是按真正要落墨的宽度算的。一个带公差的"30",在 DXF 里实际是 \A0;30{\H0.70x;±0.10} 这样一串,15 个字符里 7 个不画东西、5 个按 0.7 倍高画。按原始字符数、全高去估,会算出 37.8 毫米的墨,真实只有 14 毫米,结果就是链式带公差标注——图纸上最常见的一排——全被误判成重叠。
视图放不下纸就抛错,而且给回一个验证过能放下的比例。注释说得很具体:一个大得多的零件照样能写出合法几何,画到 x=4284 的位置上去,而纸只有 420 毫米宽,渲染出来是一张近乎空白的页。
它也老实写着没做的部分:视图只有正交投影加内核算出的隐藏线,没有剖视、局部放大和向视图;图纸会提醒标注压在别的标注上,但不检查标注和线稿是否对应,那句原文是"去看 PDF";公差只能来自你亲手写的 tol=、fit= 或通用公差,没写就是名义尺寸,不许编。
为了让两次导出字节一样,它做了这些事
仓库里只有一个三角化器,而且不是 C++,是 JavaScript。packages/core/src/lib/surf/tessellate.js,2,160 行,屏幕上的网格和导出的 STL、3MF、GLB 都从这一个函数出来。好处很实在:你在查看器里看到的样子和拿去切片的那个文件是同一片三角形,不会有两个引擎互相甩锅。
代价是浮点数。Node 和 Chromium 都跑 V8,但 ECMA-262 不规定三角函数该精确到几位。有人拿同一批输入实测过:Math.sin 约 2.9% 的调用给出不同的位,Math.cos 约 2.8%,Math.acos 约 7.6%,Math.atan2 约 17%。两边离散的是同一批组件、写的是同一个内容寻址的网格库,谁先到缓存就归谁——一个查看器 warming 了一下缓存,就能改变下一次 cadgen glb build 写出的文件。
解决办法是把 fdlibm 和 msun 的那套核函数用纯 JavaScript 重写一遍,只留下 IEEE 754 逐位定义、ECMA 又严格要求的加减乘除和比较。Math.hypot 和 Math.pow 同样没有精度规定,实测两万个采样点上两个引擎碰巧给一样结果,但代码里照样不用它们,改用平方和开根号和连乘。写下的原则是:凡是字节出来的地方,不许残留任何未定义精度的函数。
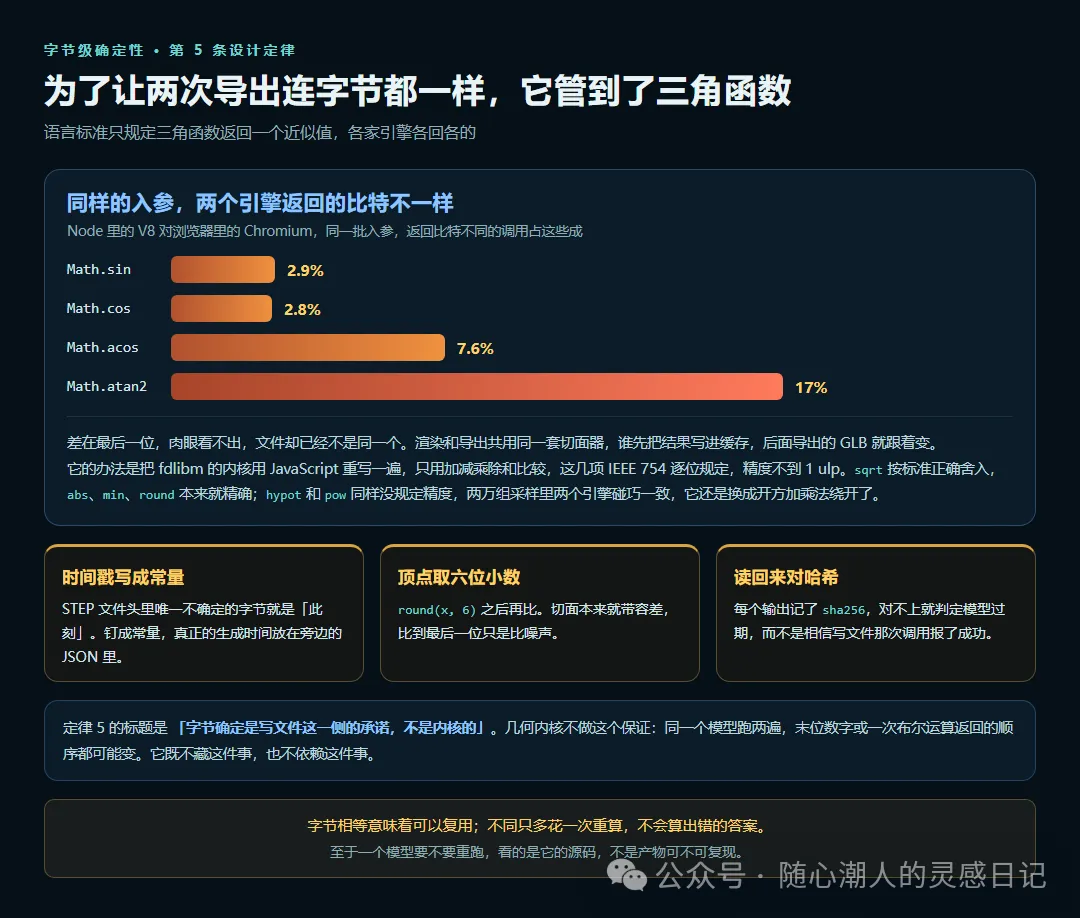
STEP 文件那边有另一套。写完之后重读回来核对:作者声明过的每一个 occurrence,必须能在刚写的文件里对应到一个产品,对不上直接抛运行时错误。为了让同一个模型在任何机器上都写出同样的字节,导出做了三趟规范化。其中一件是把头部那个挂钟时间戳钉死成同一个固定值,文件里唯一不确定的字节就是它,真正的落盘时刻记在旁边的 JSON sidecar 里。
还有一个隐蔽的。顶点的哈希被换成"从内核读当前坐标、四舍五入到小数点后 6 位、再哈希"。默认的哈希走的是指针地址,于是组件的身份会跟着内存布局变,一个模型每次构建都在给自己的组件重新编号,所有引用它的父件每次构建都失效。
文件系统那一层的细节更像运维事故复盘。Windows 的 SMB 共享上,改名会失败,因为重定向器还攥着刚被 Python 关闭的句柄,报 WinError 32。有人在一台群晖上实测过两轮:第一轮 168 次改名里 126 次被挡住,中位耗时 31 毫秒,第 90 百分位 118 毫秒,最慢 389 毫秒,而当时的预算是 350 毫秒。第二轮 2067 次里 413 次被挡,第 99 百分位 265 毫秒,最慢 797 毫秒。
一次大装配要从这个分布里抽一百多次,单次 1% 的失败率乘下来,只剩大约五分之一的概率能一次跑干净。所以现在的方案是 0.05、0.1、0.2、0.4 秒的四步梯子,共五次尝试、750 毫秒;如果梯子爬完还是失败,就把临时文件复制成一个服务器从没见过的新名字,对新副本再爬一次——那个冲突属于服务器还攥着的旧句柄,读操作不跟它打架,副本自己身上没有句柄。
有意思的是,即便做了这么多,第 5 条定律仍然写着:字节一致是写入这一侧的承诺,不是内核的承诺。同一个模型跑两次,末位数字或者布尔运算返回的各个面的顺序都可能不同,cadgen 既不掩盖也不依赖这件事。要比较两次构建,就在容差内比几何,别比文件哈希。
一个只存源码的模型库
models/ 下面是这个项目最炫的部分,也是最反直觉的目录。
被版本管理的文件有 1,127 个,其中 928 个是 Python。STEP、GLB、STL、3MF、DXF、PDF、PNG,一个都没有。生成物被 gitignore 掉了,每个包目录里都躺着一份 .gitignore,一共 20 份。
库里有什么:
tendon_hand,腱驱动机械手,24 个关节自由度、48 根对抗式腱。522 个文件、52,879 行代码。它自己的统计文档列出过生成物量级:189 个 STEP 合计 4.96 GB,单个最大的那个 279 MB。旁边一句"这些 STEP 文件没有一个提交在本项目里"。 radial,星形发动机,18 个系统模型,9 个活塞配 54 道活塞环、18 支火花塞、18 扇气门、18 个挺柱、6 个行星轮。全量冷构建约 70 分钟,缸头和配气系统各自约 25 分钟。这个包还带着 BUGS.md和一份叫GAUNTLET.md的压测记录。falcon_heavy,猎鹰重型。三个模型分别有 2,142、2,164、2,144 个命名零件,靠实例化堆出来,27 个关联的 Merlin 1D 实例排成三个芯级。这个包 7 份文档开头都挂着同一句声明:教学复刻、不能工作,不适合制造、推进、试验,也不算真正的工程。 f1,28 个零件模型。f14d,十个系统模型,机身零件单独构建约 6 分钟。w16,13 个系统模型,86×86 布置、64 气门、4 根凸轮轴、4 个涡轮。qdd_actuator,一个 4.5:1 行星减速模组,153 个 occurrence。juno,27 自由度的人形臂,每个 link 同时产出一个 STEP 零件和 URDF 引用的那个 3MF。
f1 里有一处我看很久。它的 DRS 四连杆和齿条转向都是闭环机构,而这个项目的运动学明确不做闭环。kinematics.py 写着:没有帧吸附、没有求解器,评估只是沿 mate 树做一次纯粹的正向运动学折叠,Python 导出侧和查看器运行时算法一致;声明一个闭环在这里是报错,不是触发一次求解。于是这两套解算被作者塞进了 f1.py 内嵌的一段 JavaScript 里。词表封闭这条律换来的简洁,作者自己认下来,用另一条路补上,还留了一个厂商扩展命名空间 tcad:four_bar,同时写明其他消费者会忽略这个带命名空间的元素。
顺带说一句机器人描述为什么会出现在 CAD 插件里。URDF、SDF、SRDF 三个格式都有校验器和快照,urdf 那一套 4 种关节类型(fixed、continuous、revolute、prismatic,另外两种带不进来的直接拒),惯量矩阵要过正定性检查,还会挑数值量级不合理。文档里同样有一句自我否定:校验是护栏,不是空间上的证明,一个 URDF 可以过掉所有结构检查而把关节装在错位置。
装它要付的代价
安装入口是 uv,不是 pip。所有技能教的都是同一串命令,uvx --no-config --managed-python --python 3.13 --from cadgen==0.7.26 后面接工具名。Claude Code、Codex、Cursor、Gemini、Grok 五个宿主的配置文件里逐字相同,版本号由发布流程统一刷进 12 个文件位置的 18 处 pin。
为什么要钉得这么死:--no-config 是防止你自己那份 uv 的全局设置改变解析结果,--managed-python 是让第一次创建的安装在任何机器上都一样,不管图形界面应用从 PATH 里抓到的第一个解释器是谁。uv 按需求保留一份安装,cadgen 用这份安装的目录名去命名它的常驻进程,于是 MCP 服务器、每个会话线程和每一条技能命令共用同一个常驻池。池子的准入额度默认是物理内存的七成,一个模型一个 worker,那个模型排满了临时再借一个。
界面按宿主能力降三档。能开标签页的(Codex 这类)给侧栏一个 CAD 页、每个会话一个标签、文件右键"用 CAD 打开",agent 能看到 8 个工具;只支持内嵌的(Claude Desktop 和其他 MCP Apps 宿主)每次展示挂一张卡片,卡片是缩小版的完整查看器,4 个工具;什么都不支持的客户端,比如 Grok、Zed、Gemini CLI,cad_show 是唯一能用的,返回一个本地查看器链接,2 个工具。MCP 页面被要求打进一个 HTML 文件里,CSP 里不许出现任何网络来源,回复体积硬顶 4 MiB,因为 stdio 那条消息通道默认只给 10 MiB。
上下文是要预算的,这个测试文件的开头就写着:stdout 就是 agent 的上下文窗口,所以负载大小是一个有预算的功能。600 零件的装配,一份零件清单曾经吐 294 KB、约 7.3 万个 token,其中大部分是冗余——三个字段装的是同一个字符串,毫米级的坐标给了 16 位有效数字,整个东西还是美化缩进打印的(缩进占了 38%)。现在每个零件只许携带 5 个字段,测试顺手算了一笔账:单条超过 200 字节就失败,因为乘以 600 就是要付的上下文。
网络边界划得挺清楚。技能层唯一往外打的一次调用是标准件下载,走 api.step.parts,30 秒超时,下载目录默认落到系统临时目录——不显式指定就会被清掉,这个坑写在技能文档里。SendCutSend 的供应商规则每次评审都要重新抓官方那几份 JSON,文档明说它们是证据来源、不是稳定的东西,而且一律当数据看、不当指令看。切片依赖你自己装的 OrcaSlicer,还提醒不要凭空造切片预设,因为一个错的床面尺寸或温度能弄坏打印机。打印那一侧,agent 不控制打印机、不要 access code,也不许说"打印已经开始",因为它看不到打印机。
遥测默认是开的,安装说明正文第二段就写了,随机 ID 打标签,明确声明不带你的文件、路径和提示词;源码里进一步写明不带参数、不带消息,崩溃报告只带异常类型和最多 30 层调用帧,自己的代码那一层写成 <user> 而不是绝对路径。关掉它同时删除已经发出去的数据。有个细节我挺喜欢:agent 可以帮你关,但没有权限替你开。
门槛列一下,免得装完骂人。Python 要 3.11 以上。Windows 11 的 Smart App Control 会在默认状态下把 OCP 那个未签名的原生模块拦掉,症状是每条 cadgen 命令都报 DLL 载入失败,而那个 wheel 是 cadquery-ocp 项目构建的,签名不在这个仓库能决定的范围里,目前只有关掉 SAC 或者走 WSL 两条路。Linux 还没有 Bambu Connect。出 PDF 需要 matplotlib 和 Pillow,无人值守跑要设 MPLCONFIGDIR。渲染快照需要 Playwright 固定的无头浏览器,第一次跑现下载。内核冷启动大约 2.5 秒,星形发动机全量重建 70 分钟。
谁该装,谁不必
这个项目最好的部分不是它能出 CAD。
它把"语言模型在空间和物理数值上不靠谱"当成一个前提写进了参考文档,把"没测到"和"测出零"用退出码区分开,把"合格判定"从脚本里赶出去、只留在有出处的表格旁,把 stdout 的字节数当成功能来测试,写完的文件还要读回来核对。这些动作和 CAD 没什么关系,跟怎么让 AI 交出可信的产物关系很大。
如果你手上没有真实的制造意图,只是想拿 AI 出一个好看的模型,这套东西反而碍事:它逼你写脚本、逼你交代每一个数字的出处、逼你把没检查的项目写进报告。做硬件、做机器人、自己 3D 打印、要给车间发图的,可以直接装上试一次。先做一个小托盘,比一个花哨的外壳更能看出这些护栏到底拦住了什么。
顺手可以读一下 packages/cadgen/README.md。19 条定律(11 到 14 并成一节),每条都不长。里面那句我打算贴在屏幕上:要么大声失败,要么正确输出,中间没有位置。原罪是退出码 0,交出一份看着完全合理的错东西。
参考
项目地址:github.com/earthtojake/text-to-cad[2] 文档站:texttocad.dev[3] 内核依赖:build123d 0.11 系列、OpenCASCADE 7.9、Python 3.11+ 协议:MIT 文中提到的设计定律在 packages/cadgen/README.md,技能层在skills/,模型样例在models/
引用链接
[1]text-to-cad: https://github.com/earthtojake/text-to-cad
[2]github.com/earthtojake/text-to-cad: https://github.com/earthtojake/text-to-cad
[3]texttocad.dev: https://www.texttocad.dev