ARTICLE · 1249766
嵌入式AI编程工具怎么选?代码会被AI复现吗?
周日晴天,这周末跟很久没见的前同事聚了一下,围绕1.嵌入式AI编程用哪个工具最好2.代码安全性怎么保证
复盘一下,分享一下我平时用AI的经验和看法。
首先,很多同学研究各种新工具优势和用途,我觉得其实刚开始直接就选最强,最屌的一款来直接用就好了,你用了世界最强的模型工具以及先进的AI辅助开发方式,就算后面你会因为环境或token而不得已更换时你也能向下兼容的。我直接说我的答案:
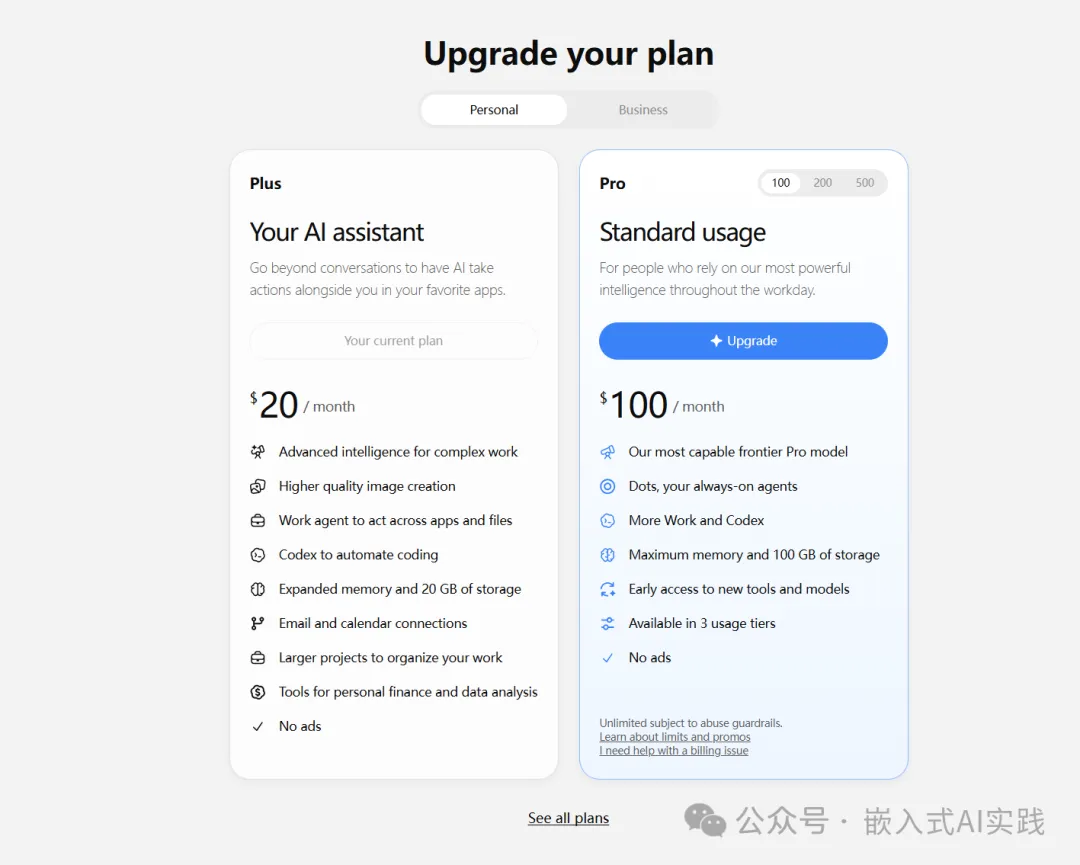
第一选择codex ,性价比最高,模型能力与claude code 不分上下我认为。
第二选择claude code ,如果预算够。
这两款可以说是世界最强的两个模型吧。关键在于将重复的开发任务沉淀成可复用的工作流,在这方面,他们都很强。
这里你需要解决魔法问题以及账号问题,这是我们目前国内主要卡点。
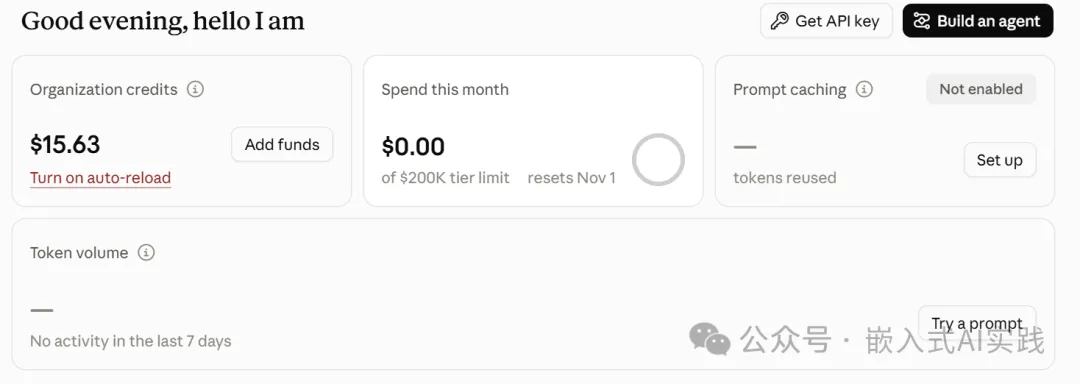
我目前来说codex是pro月供20刀,claude code是按token扣,用多少,花多少(顺便一提,claude code 账号用容易封号,但是直接用 key 绑定不会封号,我用一年了,非常稳定,但是就是比较贵吧。)
一、主流工具分类和对应特点
除此之外呢我也总结了其他的包括国产的一些工具,我相信后面国产慢慢能跟上,所以还是需要关注国内顶尖的模式是哪些,优势在哪里。目前的 AI 编程工具主要有两种形态:
- AI IDE
:以 Cursor 为代表,在编辑器中集成 AI,注重图形化交互与代码编辑体验。 - Coding Agent
:以 Claude Code、Codex 为代表,能够自主读取工程、修改代码、执行命令和运行测试。
两者的功能正在逐渐融合,区别更多体现在交互方式和工程集成体验。
7 款主流工具对比
工具 | 核心优势 | 适合人群 |
Codex | 自主编程、Skills、自动化 | 工程开发、工作流构建 |
Claude Code | 终端开发、复杂工程、Skills | C/C++、Linux 开发 |
Cursor | AI 原生 IDE、代码理解 | 偏好图形化开发 |
OpenCode | 开源、多模型、可定制 | 模型自由度要求高 |
Trae | 中文体验、AI IDE | 国内新手开发者 |
Qoder | 多 Agent、项目知识管理 | 团队协作 |
CodeBuddy | IDE/CLI、腾讯云生态 | 国内企业开发 |
为什么推荐 Claude Code + Codex?
嵌入式开发与普通 Web 开发有所不同。
我们的项目经常涉及 C/C++、Ubuntu、交叉编译、驱动开发、通信协议及硬件调试。
Claude Code 和 Codex的优势在于能够直接参与工程流程:
读取源码 → 分析问题 → 修改代码 → 编译测试 → 输出结果
不夸张的说,大部分朋友开发还只是停留在与大模型交互聊天中。
二、代码交给 AI,会不会泄密?
老板们或者核心工程师都会担心的问题。
公司代码被 AI 拿去训练,甚至被其他人复现出来。
说一句得罪人的话:
大多数普通业务代码,技术壁垒其实没有想象中那么高,核心时间都在造轮子。
做一款嵌入式产品,从芯片选型、PCB 设计、BOM 成本、EMC 整改,到量产、供应链和渠道销售,代码只是其中一环。
很多时候,真正难以复制的不是代码,而是:
行业经验、业务理解、供应链资源以及客户渠道。
一套常规通信程序,有经验的工程师可能几个月就能重新实现。
但一个行业积累多年的经验、人脉和商业资源,并不是拿到源码就能复制的。
不过,技术壁垒低不代表可以随意泄露。
有些团队确实拥有高价值的控制算法、协议栈、关键工艺参数和未公开的产品方案。
这些核心资产必须认真保护。
三、需要兼顾 AI 效率与代码安全吗,我管你这那,能跑起来就是好猫?
现在当然很多的重复性工作我觉得可以直接交给AI,但是还是有些核心东西还是得有所措施,我估计以后的企业都会在这方面开始实行,比如私有化部署,比如AI边界协议,很多大厂已经开始这样做了。
下面是AI归纳的:
方案 | 具体做法 | 适用场景 |
普通 AI 工具 | 确认隐私设置和数据政策 | 个人及授权的普通项目 |
核心代码隔离 | 封装核心算法,只提供接口说明 | 存在商业机密的项目 |
企业 API | 使用商业数据保护条款及权限管理 | 企业研发团队 |
本地部署 | 使用受控环境与本地模型 | 高保密项目 |
我觉得就目前比较现实可用的:
① 核心代码封装
例如,将核心控制算法编译为静态库,只提供头文件和接口说明。
AI 仍然可以帮助编写上层业务代码、优化接口和设计测试,而不必接触算法实现。
② 本地部署
本地部署目前来说非常吃硬件,成本较高,肯定是没有云端直接用那么强的,但是用于一些安全性的企业知识库管理以及协同开发系统等还是很有搞头的。
总的来说企业使用 AI,首先要明确数据边界,而不是只看工具宣传。
OK,今天就到这里了,后续我会研究一下标准的工作流辅助开发问题,欢迎关注交流。