ARTICLE · 1250286
给掩模版一个数字替身
MASK DEFECT INSPECTION · 上篇
die-to-database:掩模缺陷检测里最难走的那条路
凌晨两点,掩模厂的检测间里,一台检测机刚刚扫完一块 6 英寸的石英板。
屏幕上跳出一个候选缺陷:坐标 (52.3 mm, 17.8 mm),尺寸约 40 nm。值班工程师没有立刻按下“判废”,也没有随手把它划进“噪声”。他知道,这个亮点可能是真的断线,也可能是模型算错了那么一点点——而这两种判断,指向的结局完全不同。
在掩模行业,这样的判断每天要重复上千次。支撑它的那条技术路线,叫 die-to-database。
它解决的问题很朴素:如果一块掩模上真的有一个不该有的东西,我们怎么知道?
一、一块被放大四倍的“母版”
先说清楚掩模版是什么。
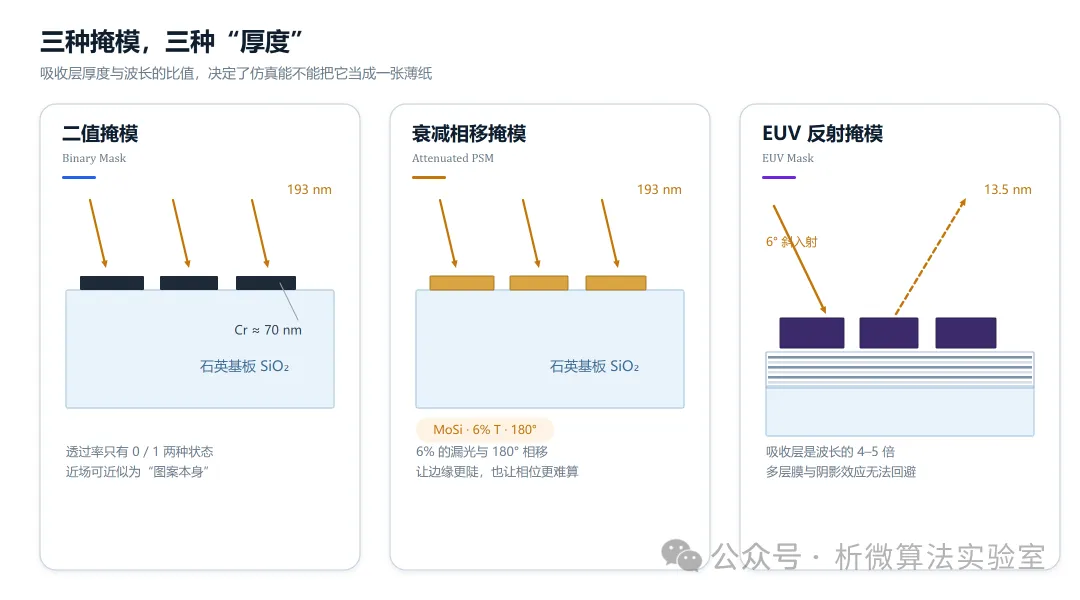
它是一块 6 英寸见方、约 6.35 mm 厚的石英玻璃(fused silica),一面镀着吸收紫外光的薄膜——传统是铬(Cr),先进工艺里更多是 MoSi 这类相移材料。图形用电子束或激光直写上去,经过显影、刻蚀、去胶、修复,最后盖上一层薄膜防尘罩(pellicle),送进晶圆厂。
它不直接参与芯片的电学结构,却决定了芯片长什么样。光刻机把掩模上的图形用一束光投影到晶圆上,镜头把这个图形缩小四倍。所以晶圆上 30 nm 的线,在掩模上是 120 nm;晶圆上 100 nm 的间距,在掩模上是 400 nm。
这个 4 倍,是光刻工程里少见的“宽容”。它让掩模的加工精度不必和晶圆一样苛刻,也让掩模厂有了几纳米的容错空间。但随着晶圆上的图形越做越小,这个容错空间正在被一点点吃掉。
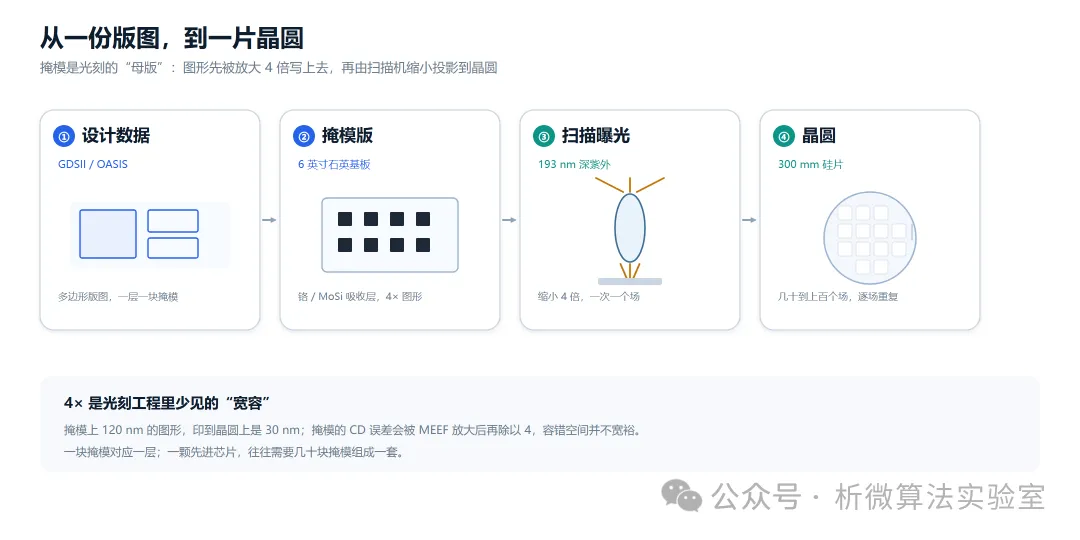
一块掩模只管一层。一颗先进逻辑芯片,动辄需要几十块掩模组成一套“mask set”。一块 300 mm 晶圆上要曝光几十到上百个场(field),每个场都完整地复刻一次掩模的图形。一片晶圆几百亿个晶体管,全部由这些“母版”一层层叠出来。
这就是掩模的地位:它不是耗材,它是源头。
二、一个缺陷,会被复制多少次
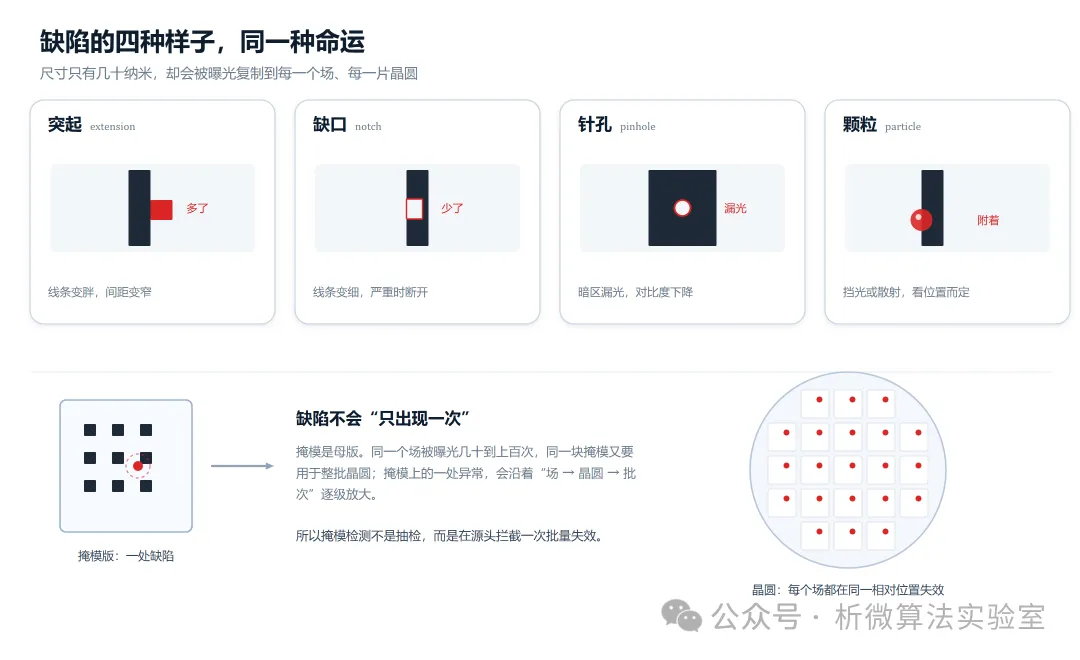
掩模上的缺陷,大致有几类:该有图形的地方多了东西(extension),该连续的地方断了(notch),该挡光的地方漏了光(pinhole),表面落了颗粒(particle),或者修复时留下了痕迹。
它们的尺寸往往只有几十纳米。放在日常生活里,这个尺度什么都不是;放在掩模上,却可能是致命的。
原因在于“复印”。掩模上的一个缺陷,不会被投影一次就消失,它会被复制到这片晶圆的每一个曝光场,再复制到这一批次的每一片晶圆。如果这个缺陷落在关键尺寸上,一片晶圆上可能有几十个甚至上百个芯片因此报废;如果这批晶圆已经流到后续工序,损失还要再乘上几倍。
但“有缺陷”和“会打印”是两件事。
掩模上有些图形,本来就不打算在晶圆上成像——比如光学邻近效应修正(OPC)加出来的亚分辨率辅助图形(SRAF)。落在这些辅助图形上的小缺陷,可能对晶圆毫无影响;而落在主线条边缘上的同样大小的缺陷,却可能让整条线断开。
所以掩模检测真正要回答的,不是“这里有没有不一样”,而是“这里的不一样,会不会被印到晶圆上”。这个判断,叫可打印性(printability)。
它把检测从一道“找不同”的题,变成了一道“预测”的题。
三、三条路:看邻居、看设计、看空间像
要找出“不一样”,先得有一个“应该是什么样”的参照。参照从哪里来,决定了检测路线的分野。
第一条路,看邻居:die-to-die(D2D)。一块掩模上如果排着几个完全相同的图形(die),那就把 A 和 B 逐像素比一比。A 有而 B 没有的,就是缺陷。这个方法直观、可靠,不需要任何物理模型,从上世纪七十年代的自动掩模检测系统(AMIS)开始,一直是主力。
但它有两个天生的盲区。
其一,它要求掩模上有至少两个相同的图形。先进逻辑掩模常常只有一个主 die,EUV 掩模更是如此,D2D 直接失效。
其二,它看不见“共模”缺陷。两个 die 由同一台写入机、同一套工艺做出来,如果某个缺陷在两边同时出现——比如写入机的某次扫描错误、或者落在 pellicle 上的一颗颗粒——比较时它会完美抵消。越是系统性的问题,越容易被 D2D 放过。
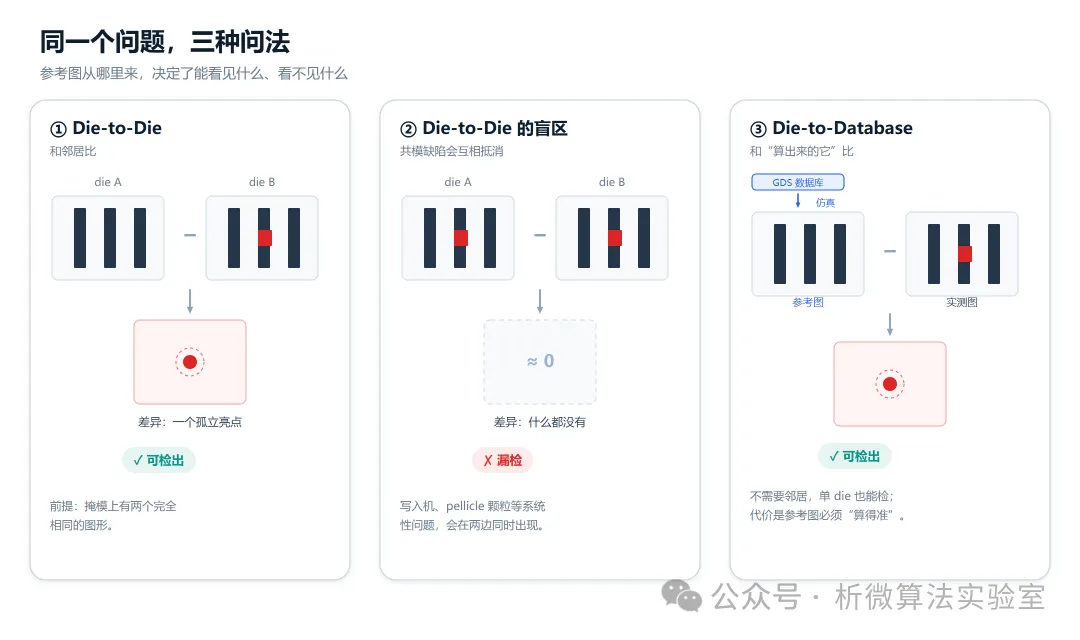
第二条路,看设计:die-to-database(D2DB)。既然版图数据(GDSII / OASIS)里写着“应该是什么样”,那就把它“渲染”成检测机应该看到的样子,再和实测图像比。不需要邻居,不依赖重复图形,单 die 也能检。
第三条路,看空间像:AIMS。用一台模拟光刻机光学的显微镜,直接看缺陷在晶圆上会印成什么样。它更像是“复查”和“量刑”的工具,而不是全片普查的工具——速度慢,覆盖小,但判断可打印性很准。
三条路各有各的位置。真正撑起先进掩模全片检测的,是第二条。
四、D2DB 的核心:参考图不是拍出来的,是算出来的
这句话值得单独说一遍。
D2D 的参考图是“拍”出来的——另一颗 die 的图像,有噪声、有工艺误差,但它和被测图像来自同一台机器、同一套物理过程,所以“像”是天然的。
D2DB 的参考图是“算”出来的——从一堆多边形出发,经过栅格化、光学仿真、探测器建模、参数标定,最后生成一张灰度图。这张图上没有噪声,也没有工艺误差,但它必须和实测图像“像”到足以让缺陷显形。
像到什么程度?
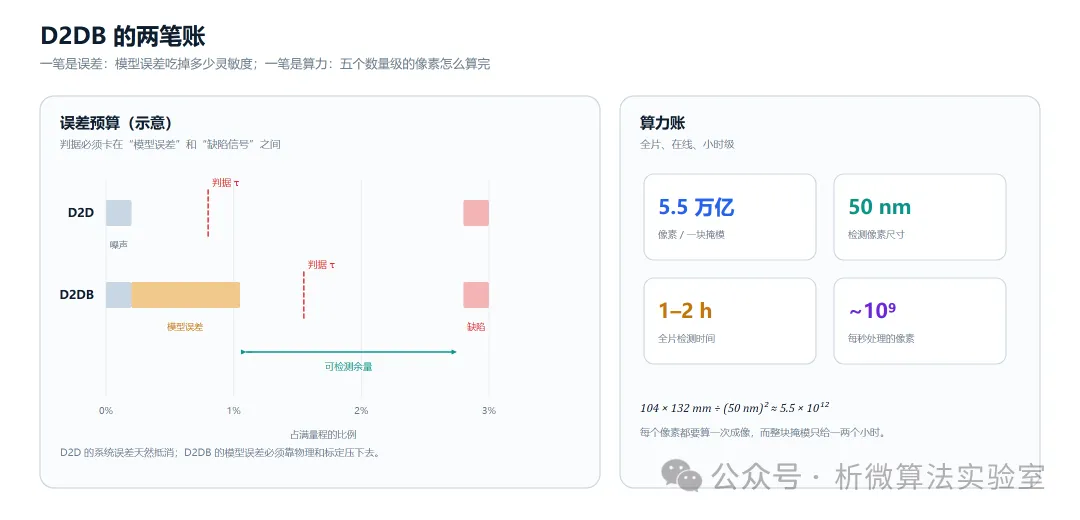
假设一个要命的缺陷,在图像上只造成 3% 的灰度变化。那么参考图本身的误差,必须显著小于 3%。换句话说,仿真精度要进入百分之一量级。这就是 D2DB 全部难度的来源。
五、九步:把设计“拍”成照片
工业界成熟的 D2DB 流程,大致可以拆成九步。不同厂商的实现各有差异,但骨架是相通的。
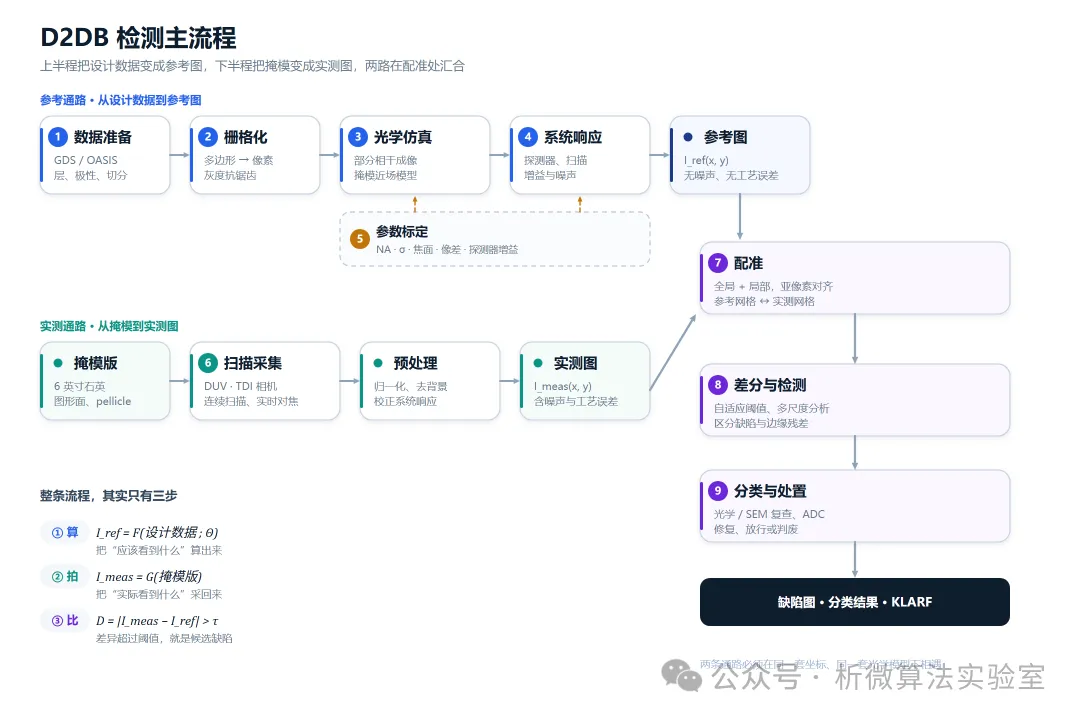
第一步,数据准备。
从掩模厂的数据服务器上取回 GDSII 或 OASIS,选出要检测的层,处理正负性(clear / dark tone),做数据切分(fracture),必要时还要做数据与掩模之间的一致性检查(MRC)。
这里有一个容易被忽略的细节:D2DB 用的“数据库”,不是设计工程师画的那版版图,而是经过 OPC、加过辅助图形、做过 bias 的“掩模数据”。也就是说,参考图对应的是“掩模应该长成什么样”,而不是“晶圆最终应该长成什么样”。两者之间还隔着一层光刻成像。
第二步,栅格化。
把多边形画到检测机的像素网格上。多边形的边很少正好落在像素边界上,所以要按面积做灰度抗锯齿:一个像素被图形覆盖了多少比例,就给它多少灰度。
像素尺寸是一笔账。像素越小,能分辨的缺陷越小,但数据量和计算量按平方增长。先进检测机的像素通常在几十纳米量级——这已经接近 193 nm 光在 0.9 数值孔径下的采样极限,再小也换不来更多信息。
第三步,光学仿真。
这是整条流程的心脏:把栅格化后的掩模,送进一个“虚拟的检测显微镜”,算出它应该呈现的光强分布。
需要建模的东西包括:照明波长与带宽、数值孔径(NA)、照明光瞳的形状与部分相干因子(σ)、像差、离焦、偏振,以及掩模本身的近场。部分相干成像不能用一次简单卷积糊弄过去,必须老老实实做阿贝(Abbe)或霍普金斯(Hopkins)那一套。
这一步有多难,下一篇文章会专门拆开讲。这里先记住一句话:参考图的全部物理,都压在这一步。
第四步,系统响应建模。
光学会聚到探测器上,还要经过一层“非光学”的转换:探测器的点扩散函数、像素的积分窗口、扫描过程中的运动模糊、pellicle 的透过率、电子学的增益与非线性、以及噪声。
只仿光学、不仿相机,参考图和实测图之间会差出一层“系统味”。真正成熟的 D2DB,是连着探测器一起仿的。
第五步,标定。
仿真模型里有一堆参数,厂商不会全部告诉你:NA 的等效值、σ 的实际填充、焦面的位置、残余像差、掩模的侧壁角、探测器的响应曲线。
这些参数不能靠猜。常规做法是拿一组已知结构的测试图形(test pattern),让实测图像和仿真图像去拟合,把参数反解出来。标定不是一次性的:换一台机器、换一批掩模、甚至机器开了几个小时之后,都要重新校。
有一类专利把这件事做得更彻底:连配准参数(x/y 平移)、焦面、像差、波长、像素尺寸都放进模型里,一起优化。这就是“基于模型的配准”——不是先对齐再比较,而是在比较中同时完成对齐。
第六步,实测图像采集。
掩模在平台上连续移动,一束 DUV 光透过掩模,经高 NA 物镜成像到 TDI 相机上。相机逐行读出,平台匀速扫描,焦点实时跟踪,光强逐段归一化。
这一步的工程难度在于“稳”:平台的速度波动、掩模的厚度不均、环境的振动与温漂,都会变成图像里的低频起伏。而这些起伏,恰好和某些缺陷的信号在同一个频段。
第七步,配准。
参考图和实测图,来自两个不同的坐标系:一个是设计数据的坐标,一个是平台运动与相机像素的坐标。两者之间隔着平移、旋转、缩放,还有局部的畸变。
配准要先把“大”的对齐(全局),再把“小”的对齐(局部)。局部对齐必须做到亚像素:不是“对齐到一个像素”,而是“对齐到像素的十分之一”。
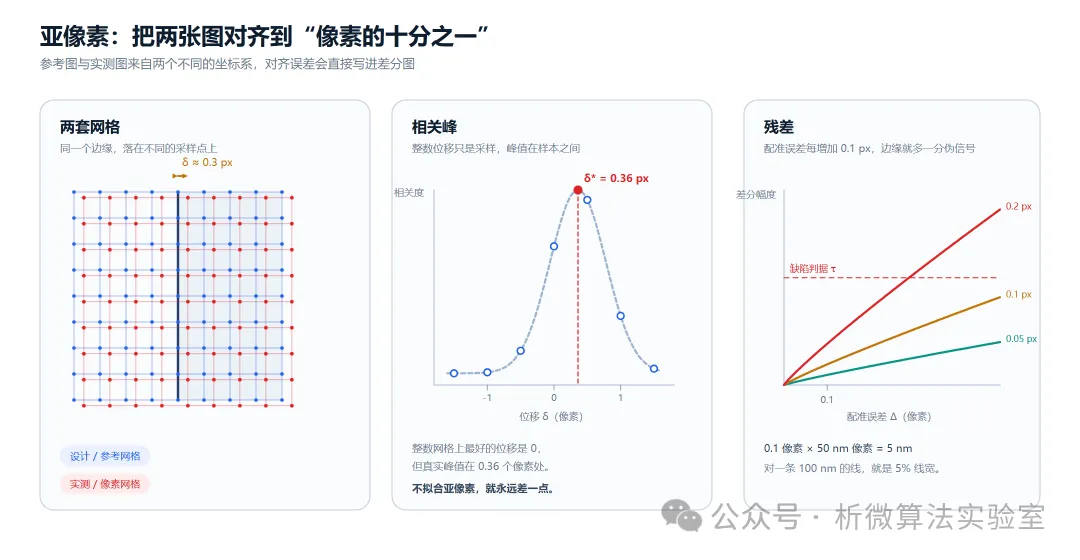
为什么这么苛刻?因为缺陷的信号常常就藏在边缘上。一个 50 nm 的像素,偏 0.1 个像素就是 5 nm 的位移;对于一条 100 nm 的线,这已经是 5% 的线宽误差。配准没做好,边缘会先“假报警”,真正的缺陷反而被淹没。
第八步,比对与检测。
两张图对齐之后,逐像素相减,得到差分图。差分图上超过阈值的区域,就是候选缺陷。
但阈值不能是一个固定的数。图形的疏密、边缘的走向、局部的对比度,都会影响差分信号的分布。所以实际系统用的是自适应阈值、多尺度分析、边缘容忍带,以及基于局部图形上下文的一整套判别逻辑。
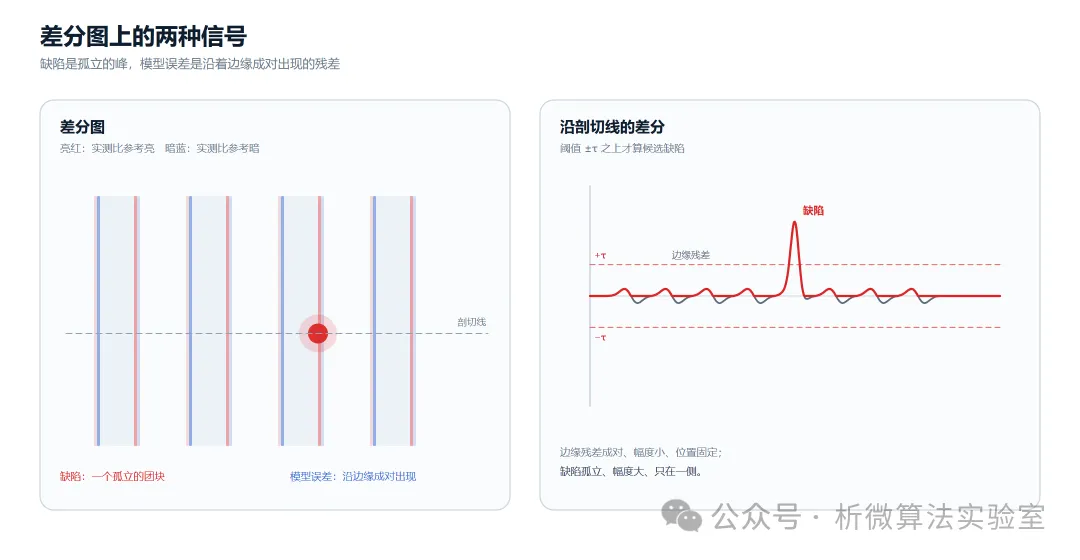
这里有一条经验:缺陷是“孤立的”,模型误差是“成对的”。仿真在边缘算错了一点,差分图上会出现一正一负两条平行的细线;而一颗真实的颗粒或一个缺口,通常是一个孤立的、有明确形状的团块。检测算法的大量智慧,就花在区分这两者上。
第九步,复查、分类与处置。
候选缺陷送到复查环节:先用更高分辨的光学图像看一遍,必要时上 SEM 量尺寸、看形貌,再由自动缺陷分类(ADC)打上标签,最后由工程师决定修复、放行,还是判废。
整条流程跑完,一块先进掩模的检测时间通常在小时量级。这个数字,后面还会再提到。
六、为什么说 D2DB 是技术含量最高的那一个
把 D2D 和 D2DB 放在一起看,差别一目了然。
D2D 的本质是比较。它不需要知道光怎么传播、掩模怎么散射、相机怎么响应。两个相同的图形放在那里,减法就是全部的物理。
D2DB 的本质是预测。它必须先造出一台“虚拟的检测机”,让这台机器在计算机里把设计数据“拍”成一张照片,然后才谈得上比较。预测得准,才比得准;预测不准,比较就变成了制造伪缺陷。
具体来说,有五个坎。
第一,模型误差会直接变成伪缺陷。D2D 里,参考图和实测图来自同一套物理,系统误差天然抵消;D2DB 里,参考图是另一套物理(模型)的产物,任何没建准的地方,都会在差分图上留下信号。误差预算必须压到缺陷信号以下,这是一个非常硬的约束。
第二,掩模不是一张薄纸。吸收层有几十纳米的厚度,和 193 nm 的波长相比不可忽略;到了 EUV,70 nm 的吸收层对着 13.5 nm 的波长,厚度是波长的五倍。光在侧壁上散射、在吸收层里波导、在多层膜里干涉——这些都不是“把图形当成 0/1 透射率”能描述的。
第三,大 NA 与小 CD 把标量近似逼到墙角。NA 越大,光的传播方向越斜,偏振效应越明显;CD 越小,近场耦合越强,衍射级越少、越敏感。两者叠加,仿真必须从标量走向矢量,从薄掩模走向严格电磁场。
第四,算力。一块 6 英寸掩模,图形区约 104 mm × 132 mm。按 50 nm 像素算,是 5.5 万亿个像素。每一个像素都要经过一次成像计算,而整块掩模的检测时间只有一到两个小时。这意味着仿真必须快到“每像素微秒级”,同时又准到“百分之一”。
第五,标定是一个闭环。模型不是买来就能用的,它要在每一台机器、每一块掩模上被“调”出来。调什么、怎么调、调完之后怎么验证,本身就是一门手艺。
所以,D2DB 的门槛从来不在“能不能比”,而在“算得准不准、算得快不快、标得住标不住”。它把一项检测任务,硬生生做成了一套计算成像系统。
七、尾声:胜负手在“算”的那一端
回到凌晨两点的那块掩模。
工程师最终要相信的,不是屏幕上那个 40 nm 的亮点,而是产生这张参考图的那套模型。模型可信,亮点就是缺陷;模型不可信,亮点就是噪声。检测机的灵敏度指标写得再漂亮,最后都要落到“参考图有多真”这一件事上。
而参考图的真,来自于对一束光的计算。
这束光从光源出发,穿过掩模上几十纳米厚的吸收层,在侧壁上散射,被光瞳截断,在像面上干涉,最后落在探测器的像素里。要把这一路算准,需要衍射理论、部分相干成像、严格电磁场、数值方法和工程标定——每一层都有每一层的坑。
下一篇文章,我们就把这台“虚拟检测机”拆开,从最薄的近似讲起,一直讲到最硬的电磁场。
(未完,见下篇《一张算出来的照片,凭什么抓出 40 nm 的缺陷?》。)