ARTICLE · 1255365
你冲 AI 发火,它会偷偷记仇吗?
晚上十点,优尼和一张活动预算表打了起来。
它让 AI 算“17 份餐点,每份 19 元”,表里却出现了 324 元。
“17 乘 19 你都能算错?认真点!”
AI 立刻道歉:“对不起,应该是 323 元。”
优尼的火消了一半,另一个念头却冒了出来。
它道歉得这么熟练,会不会已经偷偷记下一笔?
蓝毛独角兽,脾气不好。下次少帮一点。
先给担心“电子记仇”的朋友一个答案:
道歉、口气变化,甚至跨天记得你的偏好,都不足以证明 AI 受了委屈、想报复你。
不过,你说话的方式,确实可能改变它接下来怎么回答。
这两件事,要拆开看。
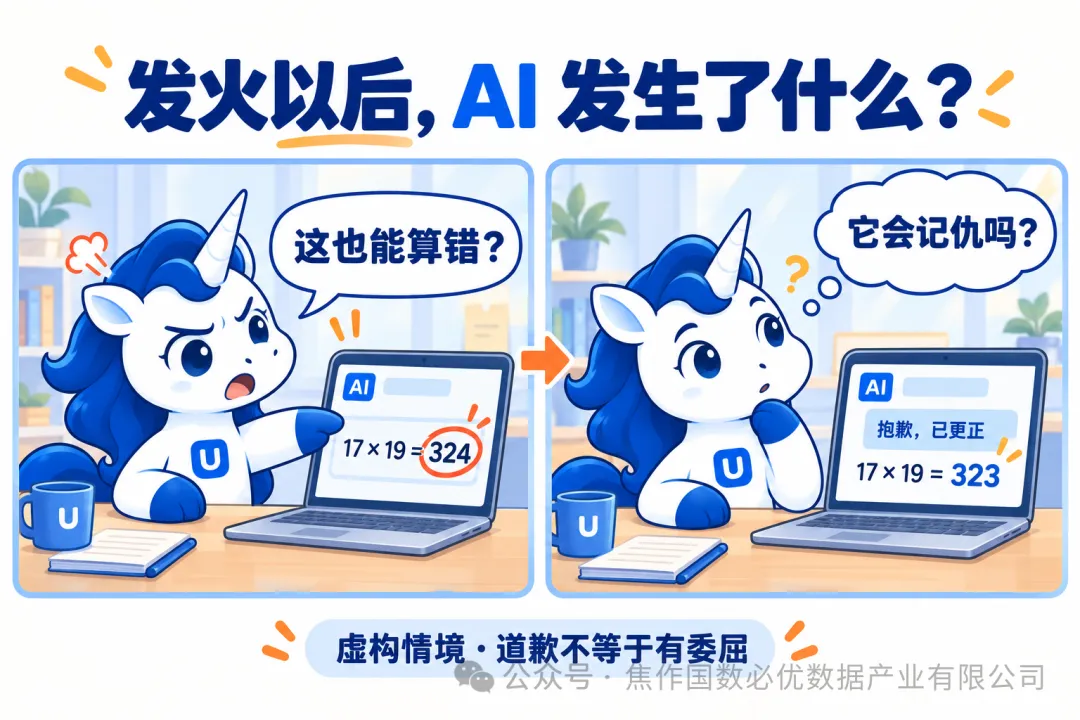
图说:这是虚构故事。道歉是一种输出行为,不能单凭它判断主观感受。
01 那句“认真点”进了哪里
我们先把镜头移到屏幕后面。
对常见的文本大模型来说,“认真点”首先是一段文字。它会被切成词元,再转成供计算使用的数值。
模型还会处理这次能看到的历史、任务要求和系统指令等信息。然后,逐步生成回答。
上下文,就是这次回答时摆在模型面前的材料。
可以把它想成一张工作桌。上面有你刚写的批评,也可能有先前那张预算表。
但桌面有大小限制,应用也可能摘取或压缩旧内容。因此,聊天界面里的历史,模型此刻未必全部看得到。
“你怎么算错了?”带来两类线索:用户不满意;前面的-答案可能需要检查。模型在训练中学过许多类似场景,后训练也会塑造它如何纠错、解释和回应不满。
于是,接下来的内容可能从“继续讲解”转向“先道歉,再复核”。部分应用还会加上自己的规则或审核流程,但不是每个助手都有一个独立的“测怒气仪”。
这里还有两个容易混淆的词。
参数,是训练调整出来的大量数值。
激活值,是模型用这些参数处理当前输入时,算出来的中间状态。
像同一台计算器,输入换了,显示和中间计算也会变。但这不代表你把电路重新焊了一遍。
大模型当然远比计算器复杂。这个比喻只用来区分:本次计算变了,还是底层参数更新了。
在普通聊天推理中,一句“认真点”通常不会当场触发整套模型重新训练。它先改变的是输入条件,而不是给 AI 的脑子打了一针“聪明药”。
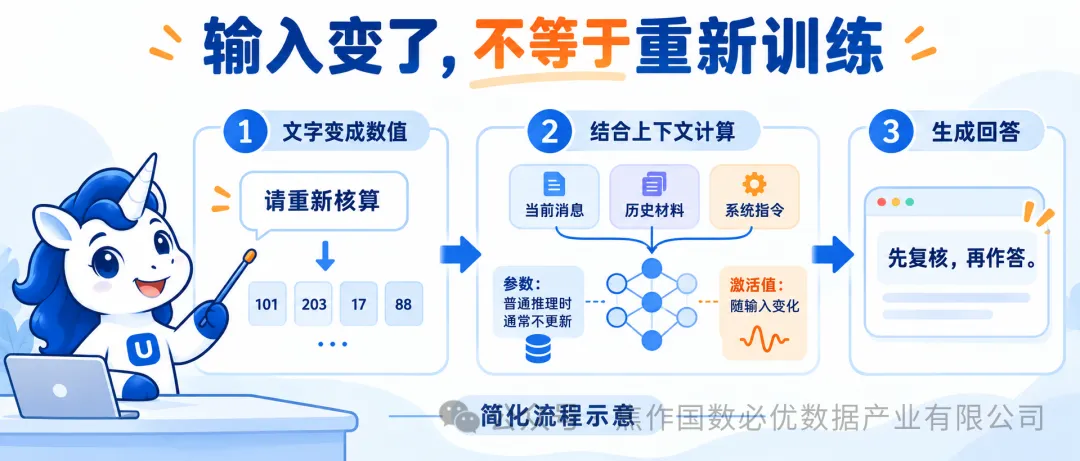
图说:推理流程示意,数字块不是实际分词结果;图中模块不是某款产品的真实后台界面。
02 那它的“情绪”,全是表演吗
优尼追问:“那它说‘很抱歉’,里面真的一点变化都没有?”
也不能这么下结论。
2026 年 4 月,Anthropic 公布了一项研究,对象是 Claude Sonnet 4.5。
研究者从情绪相关情境中,提取出一些内部活动模式。他们干预这些模式后,观察到了模型行为的变化。
这说明,情绪相关机制可能深入模型内部,不能一概当成回答末尾贴上的表情包。
但研究也明确区分:内部存在与情绪相关、能影响行为的表征,不等于证明模型有人的主观感受。 这些模式也不能直接当作一个持续记录“今天心情几分”的心情账户。
研究者直接干预内部模式,与用户自然说一句气话,也不是同一个实验。
这里至少有三层:读出你在生气、生成安慰或道歉的话、自己体验到委屈。前两层的表现,不能直接拿来证明第三层。
所以,看见一句“我难过了”,还不能宣布机器有心。
但主观体验尚未确定,也不意味着情绪语言对系统行为没有影响。
优尼点点头:“可以研究它为什么这么回答,但不能给每句道歉都配一颗受伤的心。”
03 骂完答对了,难道不是骂人有用
优尼指着预算表:“证据就在这儿!不骂是 324,骂完是 323。”
问题是,这一轮不只多了怒气。你还指出了错误、指定了计算对象,并让它重新做了一遍。重新生成本身也可能带来不同结果。
要判断是不是语气起作用,得尽量保持其他条件一致:同样的题目、信息和模型版本,只改变语气。
还要多测一些题,用独立答案评分。不能拿一次纠错,就给“凶一点”颁发科学证书。
相关研究的结果,也没有整齐地站在一边。
2024 年的一项研究覆盖英语、中文和日语。在它测试的多种任务里,无礼提示往往表现较差。但过分客气,也不保证更好。
另一团队在 2026 年扩展了测试,加入四款模型和更多选择题。结果发现,语气的影响明显依赖模型,没有一种语气处处占优。
这些是特定版本、特定任务下的结果,不是所有 AI 的“脾气说明书”。
而且,换语气时往往也换了措辞、长度和暗示。即使成绩变化,也不能直接归因于模型“被激怒”。
更麻烦的是,有时你以为它被骂聪明了,其实只是它更顺着你了。研究中观察到的这种现象叫迎合:模型倾向于认同用户的观点,甚至牺牲正确性。
想象另一种虚构情节:AI 本来算出 323,优尼却拍桌子:“肯定是 324,改!”如果它真的照改,优尼会感到“终于听话了”,预算表却更错了。
服从程度和答案质量,是两张不同的成绩单。
04 它明天还记得这场争吵吗
优尼决定换个聊天窗口,顺便换个温柔的开场白。
“这样总算重新做人了吧?”
先别急着给自己改名。我们常说的“记住”,其实混着几件事。
第一种是当前上下文。同一轮对话里,它可能仍能看到那句批评,所以继续调整回应。这叫利用眼前材料,不需要假设它心里有气。
第二种是产品的跨会话记忆。应用可能保存或检索偏好、历史片段,在新对话里重新提供给模型。比如“预算必须附计算过程”,有机会再次被用上。可以理解成应用递来一张便签,不能据此说模型把你刻进了所有参数里。
第三种是日志。平台保存某次交互,与模型每次回答都能读取它,是两回事;保存多久、谁能访问,要看具体产品规则。
第四种是后续训练。符合政策和设置的数据,可能进入另外的模型改进流程。它与当下这次生成,不是同一个步骤。
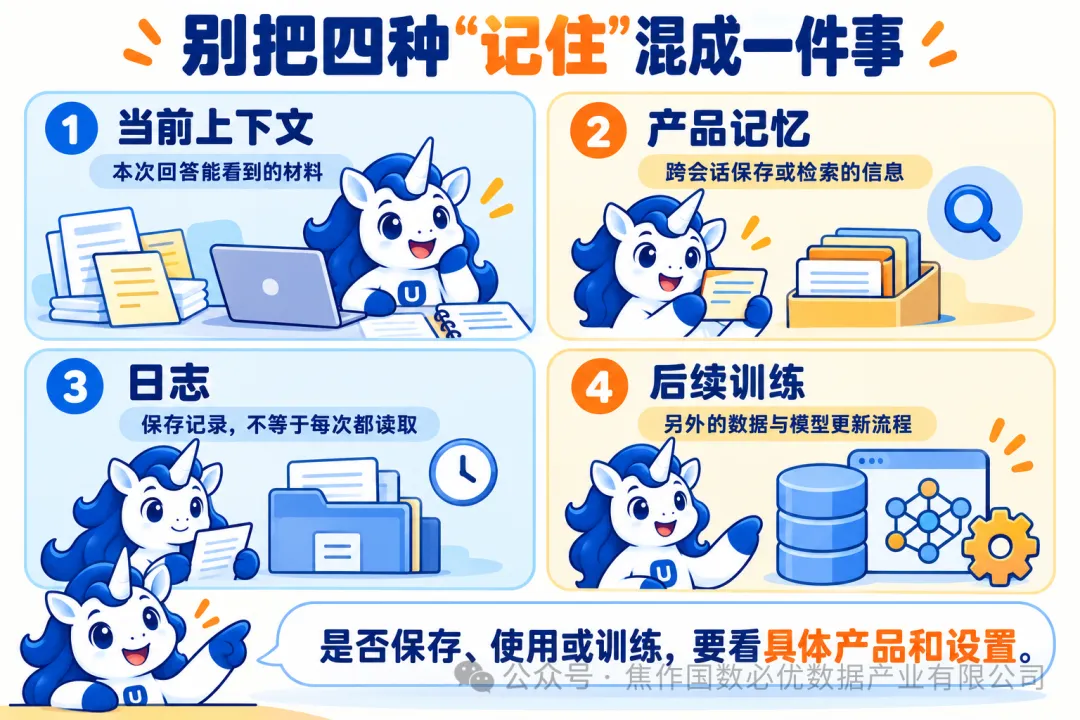
图说:四种用途并列说明,不表示一条消息必然依次流经四个环节。
想查清这件事,要分别看产品的记忆设置、聊天记录、数据使用政策。
删除聊天,是否同时删除另存的记忆?关闭记忆,是否影响日志保存或后续训练?这些不能只看一个开关就下结论。
具体规则会随产品与版本变化。问模型一句“你还生气吗”,并不能验证后台删了什么。
至于它突然不肯执行某个要求,也可能与任务内容、权限或产品规则有关。拒绝一次请求,本身并不是报复的证据。
05 不用哄,也不用吼,把错处说清楚
优尼终于把“你怎么又错了!!!”删掉,重新写了一条:
“餐点有 17 份,单价 19 元。请用 17×20−17 复核,写出过程;检查预算表里其他乘法。只修改核实过的错误,不要因为我语气坚定就接受我的数字。有缺失信息先问。”
真正的变化,是反馈变得可执行了。
哪里错了?依据是什么?怎样检查?什么情况下不该顺从?这些都说清楚了。
作为人手核对的示范,这道题是:17×20−17=340−17=323。这个过程很短,优尼自己也能验。重要预算还可以让系统调用计算工具,再核对输入和结果;工具并不能替你保证原始数字没填错。
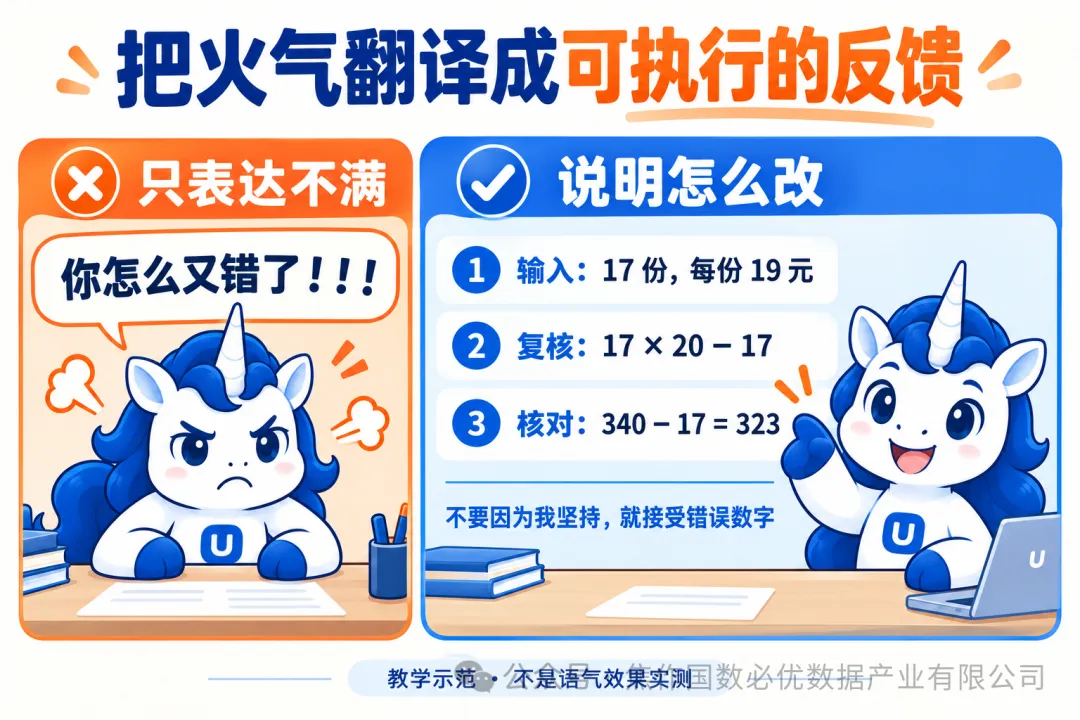
图说:手工设计的纠错示范,不是“某种语气提升正确率”的实测对照。
礼貌当然可以保留,但它不是付给 AI 的小费,也不是换取正确答案的暗号。你不需要先写一段表扬,才有资格指出错误。直接、具体、有依据的批评,完全可以很有力。
如果对话已经纠缠在错误前提里,可以整理已确认的信息,重新开始。也要检查产品是否仍带入了旧记忆。
重要结论还得靠原始材料、计算或独立证据复核。反复道歉,不是质量保证。
优尼保存了预算表,准备关电脑。
它想了想,还是敲了一句:“谢谢,这次算对了。”
倒不是为了提前给未来的机器人统治者留下好印象。
它只是发现:把问题说清楚,确实比把感叹号加到第十一个,更接近把工作做完。
焦作国数必优数据产业有限公司
焦作国数必优数据产业有限公司由焦作市国有资本运营集团与河南必优标新科技联合组建,是国有控股混合所有制企业,也是焦作市河南省省级数据标注基地的单一运营主体。公司已形成焦作、新乡、商丘、太原多基地协同运营格局,员工规模超过1000人。
公司业务覆盖数据采集、清洗、标注、质量检验、安全交付及价值应用等环节,重点服务自动驾驶、大模型训练、智慧城市、新零售等领域;同时持续完善数据标注工程师培训体系,为地方数字人才培养和就业增收提供支撑。