ARTICLE · 1258677
大多数 AI 运维助手只能“聊聊天”,Reslove AI 凭什么敢碰生产?
★ 点击名片,关注我们不迷路 ★
凌晨 3 点那通电话,我现在都不太想接。
不是因为懒,是因为心里太清楚接下来半小时要干什么——爬起来开电脑,登三个系统(指标在 Prometheus、日志在 Loki、链路在 Tempo),一条条翻告警,顺着依赖关系往上摸,拼出一个大概率不完整的根因。修是后面才有的事,前面 80% 的时间都花在「拼」上。
干过 SRE 的同行基本都熟悉这套流程。市面上号称能「替 on-call」的 AI 工具也不少,但大部分止步于 demo:跑一个公开数据集,生成一份漂亮的报告,然后告诉你「看,AI 已经找到根因了」。问题是真到生产环境,这些工具没有读写权限、没有上下文的连续性、也没有决策闸门,只能干看着告警响。
Resolve AI 是少数几个我愿意认真看的。原因不是它融资多(虽然 A 轮融资 1.25 亿美元、估值 10 亿美元💨),而是它把「在生产环境替人干活」这件事拆得比较细,而且已经跑通了一批大厂客户。
它是怎么拆的:三个 Agent,而不是一个全能 agent
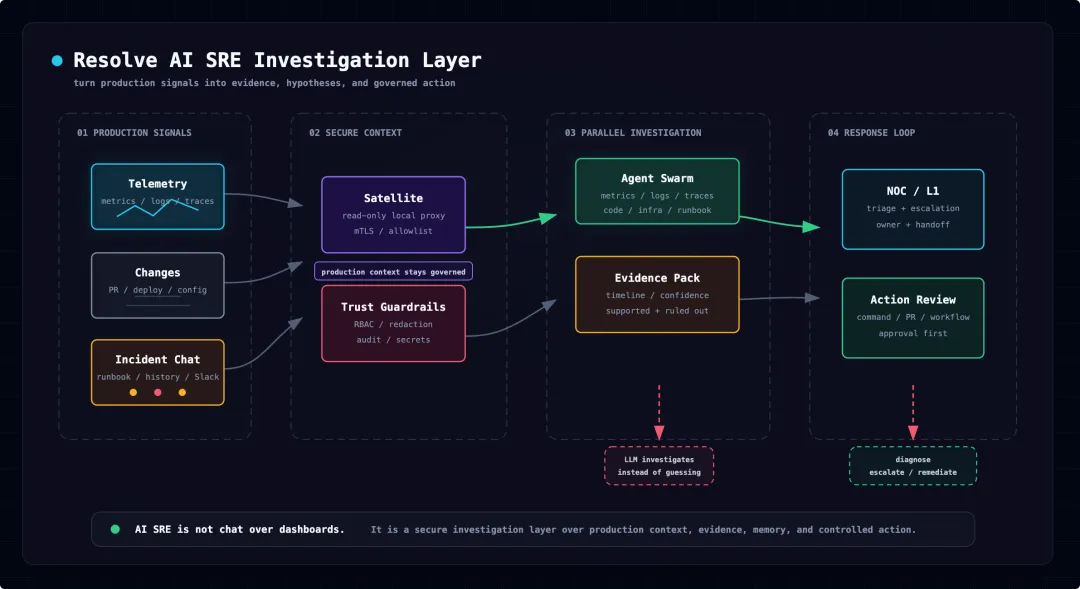
Resolve AI 没押宝在「一个超强大模型 + 一个 prompt」这种结构上,而是把生产环境里的角色拆成三个专门的 agent,各自守一段:
On-Call Agent:告警一响,它把同一时间窗口的多条告警归并,识别噪声、评估严重程度和业务影响,把结论写回 Slack/Teams。你看到的不是 50 条孤立告警,而是「同一根因、影响订单服务、P2」这种带上下文的摘要。
Incidents Agent 是核心。告警进入调查,它会拉起多个 agent「并行假设」,各自顺着假设查日志、指标、近期部署、代码变更,然后 Verifier 把所有假设的证据反过来核一遍,只把能在生产数据里复现的那条根因推给工程师。整套过程对工程师可见(Workbench 视图)。
Background Agent是 2026 年 5 月新加的,平时不响。部署上线、配置漂移时,它自动跑预调查——把可疑点先摆出来。这个角色以前 AIOps 都不太做。
三个 agent 共享一份「知识图谱」:服务、依赖、近期部署、团队历史 postmortem。Agent 查的是这份图,人看到的也是这份图,不会出现「AI 和人对着两份数据吵架」的尴尬。
与可观测怎么接:60+ 集成,以及三种「外部用法」
SRE 工具能不能用,第一关永远是「能不能接入我现有的栈」。Resolve AI 在这块走的是广覆盖路线:
Datadog、Splunk、Grafana、New Relic、Honeycomb、Sentry、PagerDuty、ServiceNow、Snowflake、GitHub、Atlassian、Slack 都在它的集成列表里,总数 60+。
监控侧主流的几乎都接了,运维协作侧主流的也都接了——这意味着你不需要为了试用它而重做一遍监控。
更值得关注的是它的「开放性」。Resolve AI 不只是把自己当 SaaS 卖,它把自己的能力通过三种接口暴露出来:
- MCP server:让任何外部 agent(比如你自己的 Claude Code、Cursor)能直接调用 Resolve AI 的「查生产上下文」原语
- REST API:经典集成方式
- Skills:给 AI 助手插件用的封装
这个设计的意思是:你不需要把 Resolve AI 当成「唯一入口」,它可以是你基础设施里的一个生产上下文服务,被你自己的 agent 调用。这对已经在自建 agent 的团队是个关键加分项。
部署方式上,它给了三档:SaaS 多租户、单租户独享(拿自己的密钥)、Satellite 本地代理(跑在你自己的 K8s 或 ECS 里,对接那些不允许出网的内网工具)。合规覆盖 SOC 2 Type II、GDPR、HIPAA,对受监管行业够用。
它已经跑通在谁那里
客户名单是 Resolve AI 最硬的一张牌:Coinbase、DoorDash、Zscaler、Salesforce、MongoDB、MSCI、Autodesk、Blueground、DataStax、Toast、Pinecone。
这些不是「我们正在 POC」的名单,而是「公开 case study + 数字背书」。DoorDash 自报 87% 的 MTTR 缩短,Coinbase 自报 73% 的根因定位加速、war room 里少 30% 的工程师。
不过得打个预防针:这些数字全是 vendor-published,没有独立基准。如果你在评估,这些数字只能告诉你「它确实在跑、确实有产出」,不能告诉你「它在你这里也能产出这个数」。
所以,什么团队适合引入
把上面这些拢到一起,我自己的判断标准是这样:
团队规模 25+ 工程师、告警量已经到每天数百条以上 已有标准化的可观测栈(Datadog/Splunk/Prometheus 任一为主) 接受闭源 SaaS + 企业采购流程,不需要立刻看到精确报价 on-call 痛苦是真实痛点,不是「我们考虑一下 AI」的口号
满足这四条,Resolve AI 是值得认真做 POC 的对象——它的多 agent 推理 + Verifier + 人类审批这个组合,在「替人排查」这件事上是当下少见的、能跑通的结构。
最后一句不太好听的话:旗舰级的运维 AI 产品一定会出现,但 Resolve AI 现在是「已经在跑、还没到旗舰」的位置。它对 on-call 的实际价值,要你自己跑 3 周才知道。
你们团队敢让 Agent 读生产、跑预调查、推变更建议吗?先给读权限还是先给执行权限?期待与您聊聊~
近期好文:
星光璀璨!2026 AI 驱动的IT技术领导力年度颁奖盛典圆满举行
“高效运维”公众号诚邀广大技术人员投稿
投稿邮箱:jiachen@huayou-tech.com,或添加联系人微信:greatops1118。