ARTICLE · 1260855
一口气吞下5000页PDF不卡壳!百度文心Unlimited OCR 2开源:长文档解析变天了
就在大家以为大模型军备竞赛进入胶着期时,DeepSeek 又悄悄完成了对自己的超越。
距离上一次发布仅仅过去一个月,官方突然宣布:DeepSeek V4.1 Flash 迎来全面重
磅升级,新版本 V4.1-Flash-1017 正式上线!
网页端、官方 App、API 已同步切换至新模型,最关键的是——模型权重依然在 HuggingFace 和 ModelScope 保持全开源!
现在的大模型,动辄号称具备 1M 甚至 2M 的超长上下文。
但只要你真正往里面塞过一份上百页、带着复杂排版和表格的 PDF,就会发现残酷的现实:
模型要么读到后半段开始疯狂胡言乱语,要么单步解码卡到怀疑人生,甚至直接内存溢出宕机。
就在今天,百度悄悄放出了一个仅有 3B 总参数、**单步实际激活仅 5 亿(500M)**的轻量级开源模型——文心 Unlimited OCR 2。
可就是这枚“小钢炮”,直接在两大国际长文档基准(MarathonDocBench、MPDocBench)上斩获全球第一。
在百页级长文档评测中,它砍下 77.06 的高分,得分甚至达到了第二名的 2.3 倍以上。
更可怕的是,它彻底打破了文档解析的“页数上限”。
一、3600页哈利波特一口吞:翻页速度贴地飞行
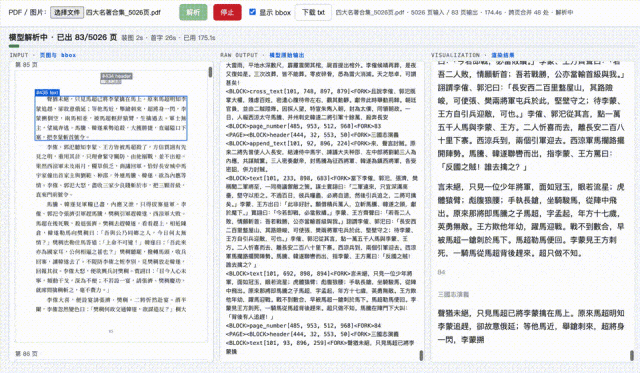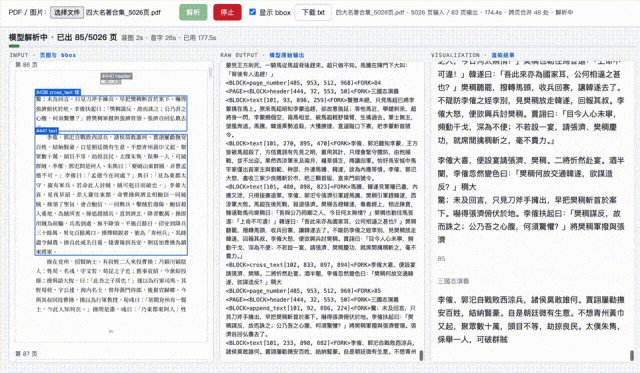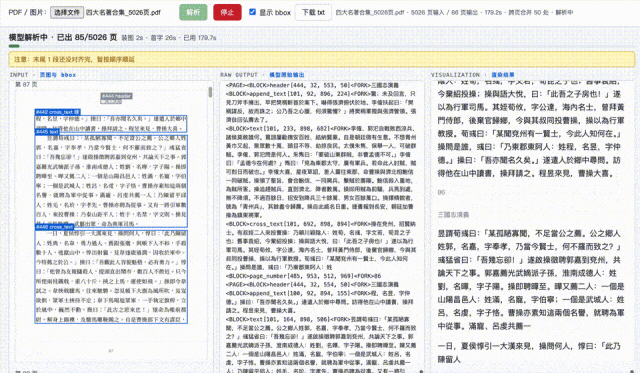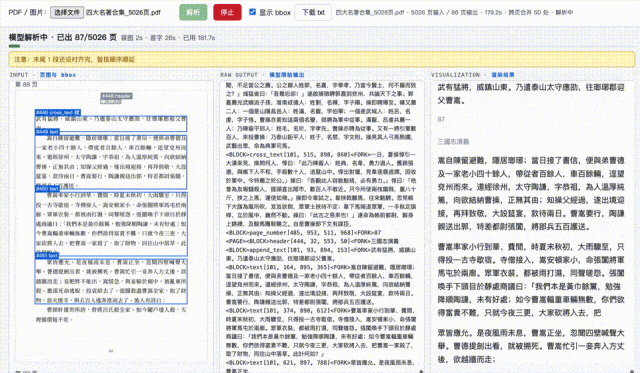
过去,绝大多数文档解析工具读到 40 页以上就会遇到显存与算力墙,用户不得不先把长书切分成几十个小 PDF 才能喂给机器。
而这一次,百度把这个上限直接撕碎了:
3623 页《哈利·波特》全集一镜到底: 耗时约 1 小时 30 分钟全部啃完,平均翻一页仅需 1.5 秒,全程无一处断片;
读到第 5000 页依然不减速: 无论是第 3 页还是第 5000 页,翻页延迟始终保持平稳;
普通显卡就能跑: 单序列 KV 显存占用直接砍掉了 96.2%(从常规的 47GB 骤降到 1.77GB),一张普通家用游戏显卡就能满血驾驭。
这意味着,无论是上千页的工程标书,还是几百页的上市招股书,终于可以整本拖入、一键解析。
二、三道地狱级实测:专治“自作聪明”的大模型
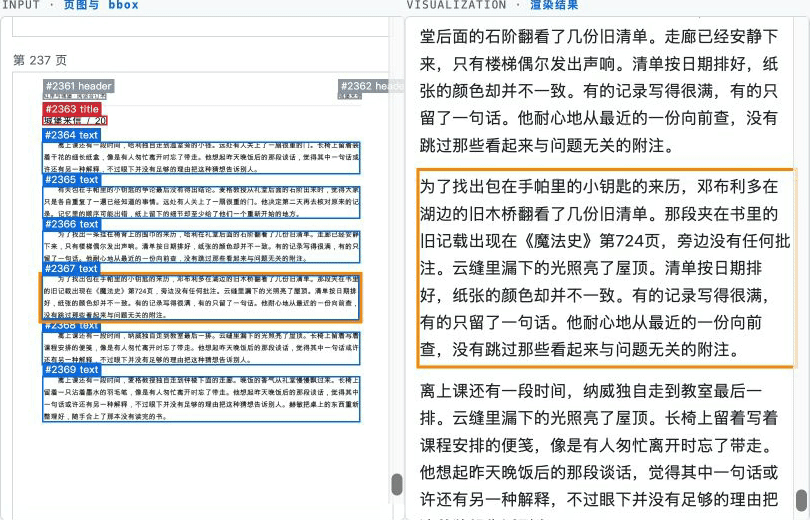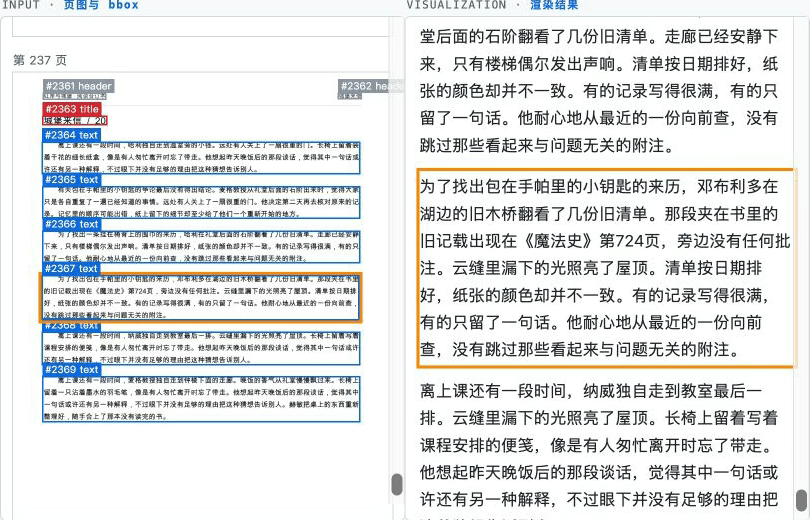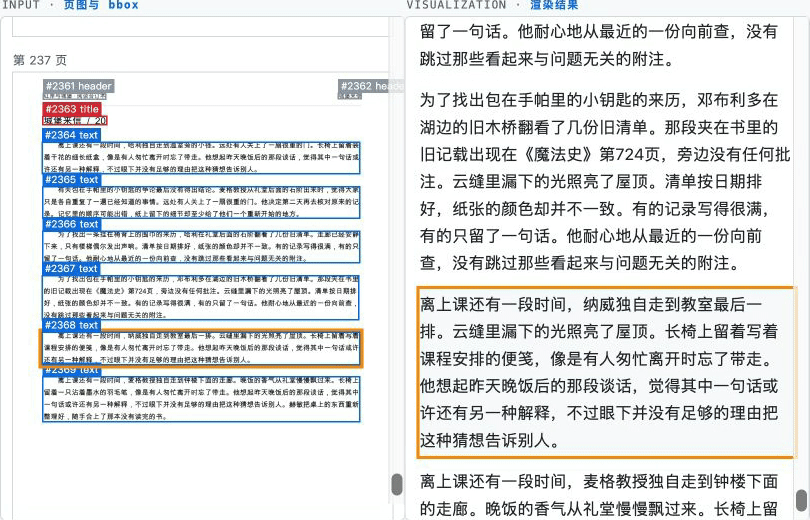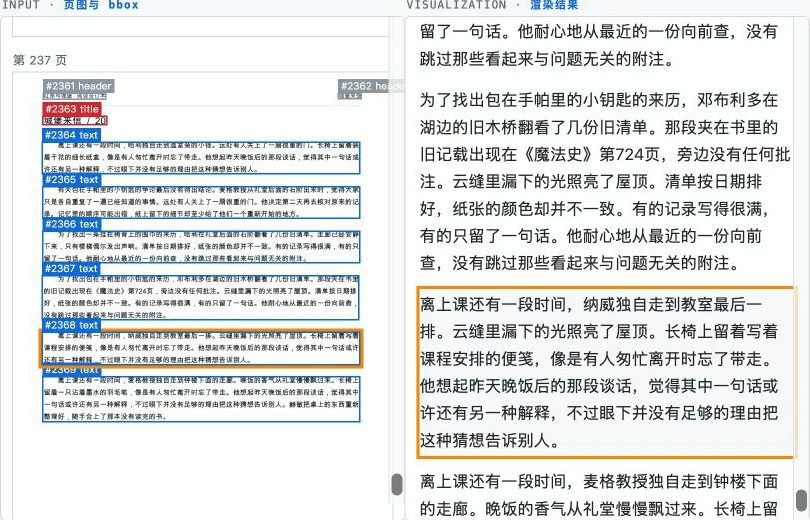
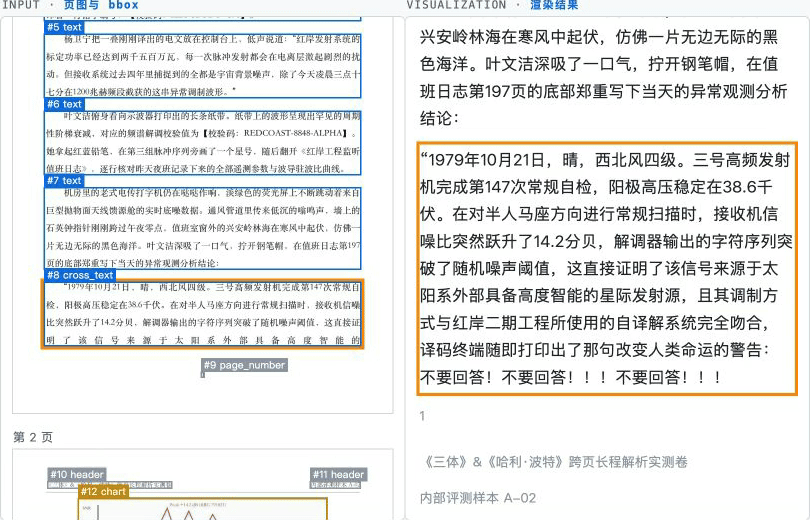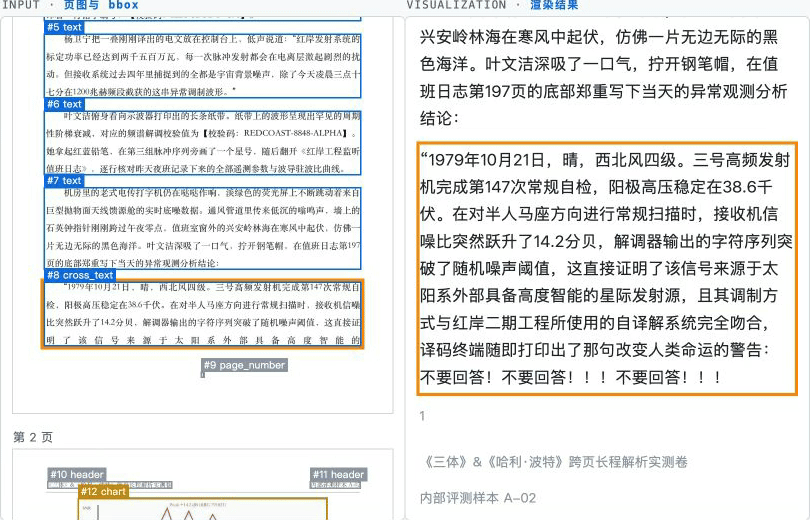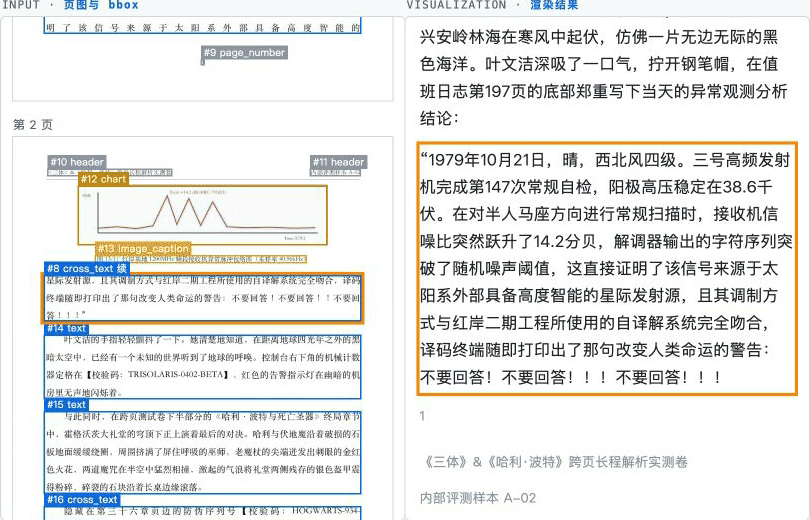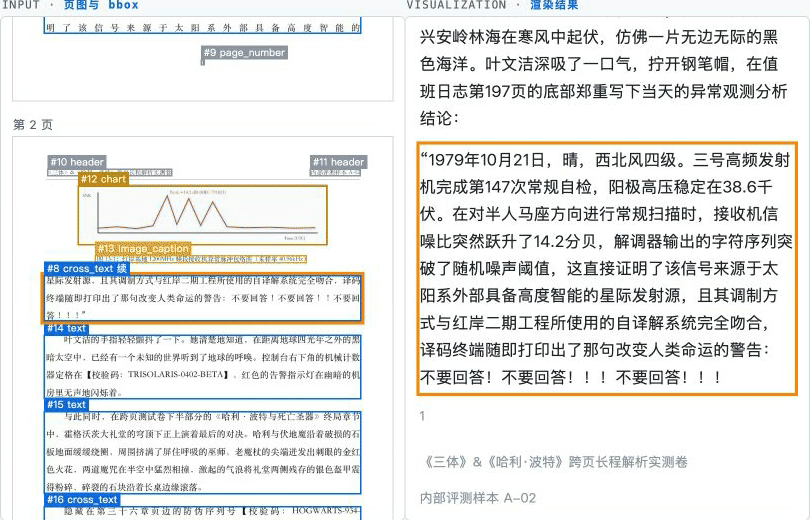
很多通用模型在读古籍或小说时,往往不是在“看图”,而是在靠记忆“脑补背书”。为了测试文心 Unlimited OCR 2 到底有多硬核,测试团队设置了三道极端关卡:
防脑补陷阱:字形微调全部照单全收
在长达 240 页的小说长卷中,测试者悄悄把“叶文洁”改成了“叶文清”,把原著页码“742”调换为“724”。如果换成平时爱脑补的通用模型,早自动纠错改回去了;但 Unlimited OCR 2 依然按纸面原件精准揪出,一字不差。跨页脉冲图拦腰截断:精准逻辑缝合
当一句英文刚好被跨页处的一张巨幅架构图隔开时,模型展现出了惊人的排版感知力——它直接越过图片和图注,把前后半截文字无缝拼回合拢。300页财务流水大考:900多万对账精确到分
面对财务和法务最头疼的跨页续表与正负对冲,模型一口气吞下 300 页账本、3000 条流水记录,不仅 0 漏项、无错列,最后用识别出的数据自动重新计算总金额,9,258,968.05 元,分毫不差。
三、技术揭秘:为什么通用大模型读长文档必崩?
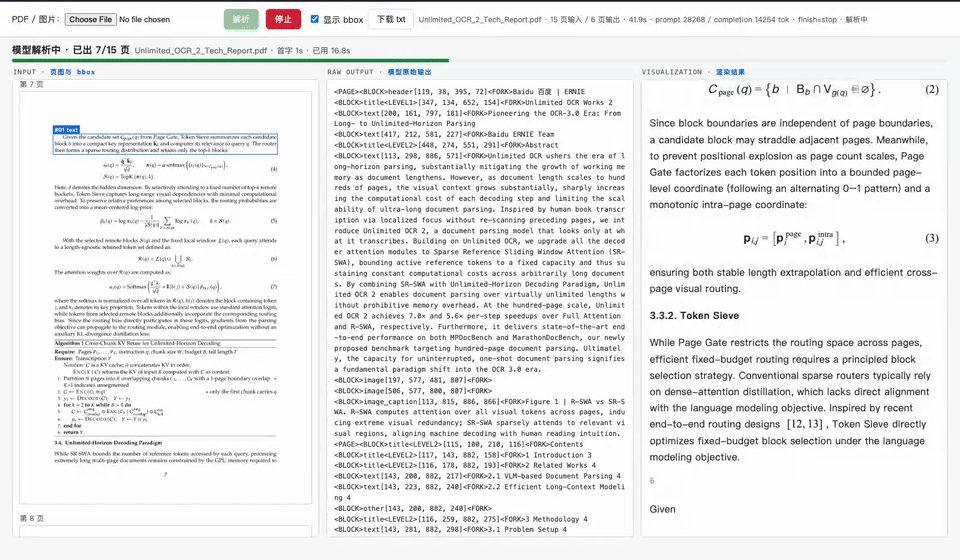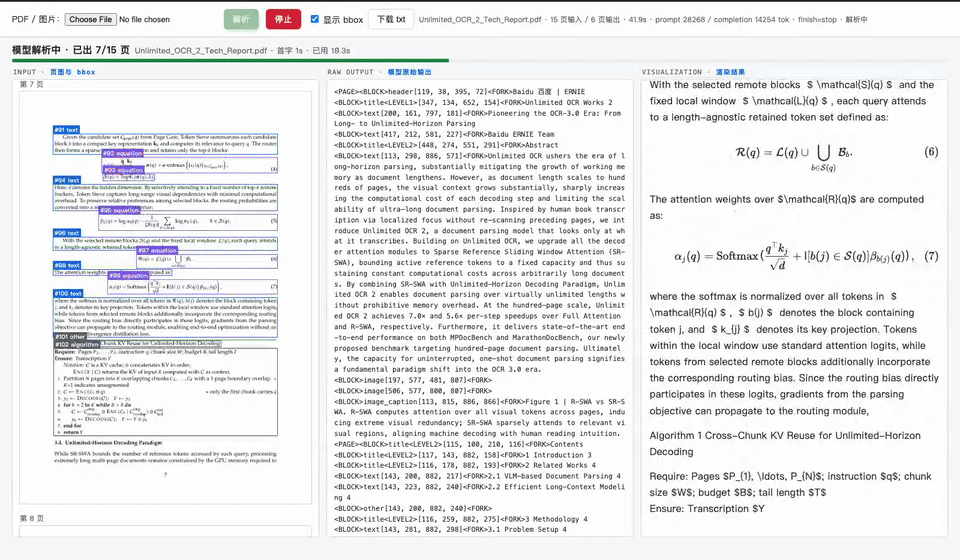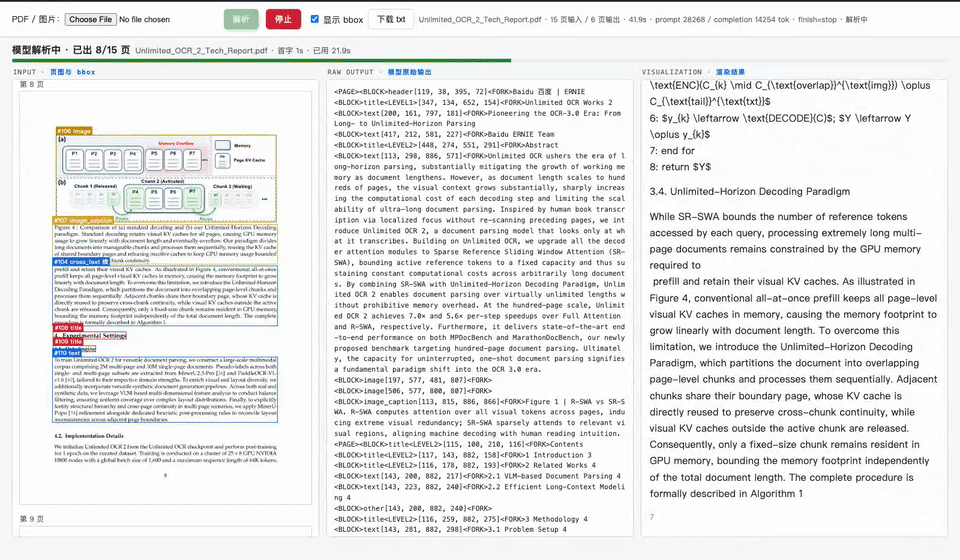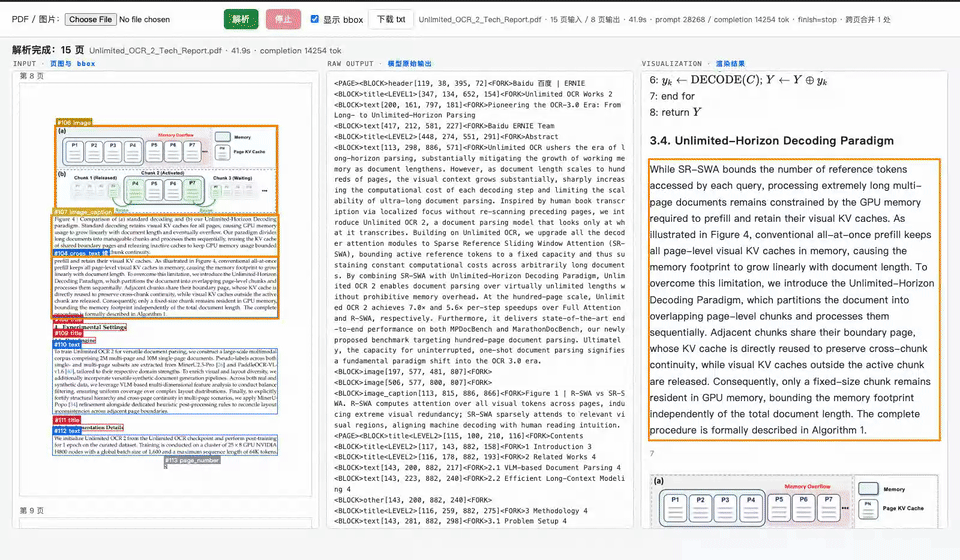
为什么动辄百万窗口的通用大模型,一遇到几百页 PDF 就会走神、降速甚至崩溃?
根源在海量的“视觉 Token”上。
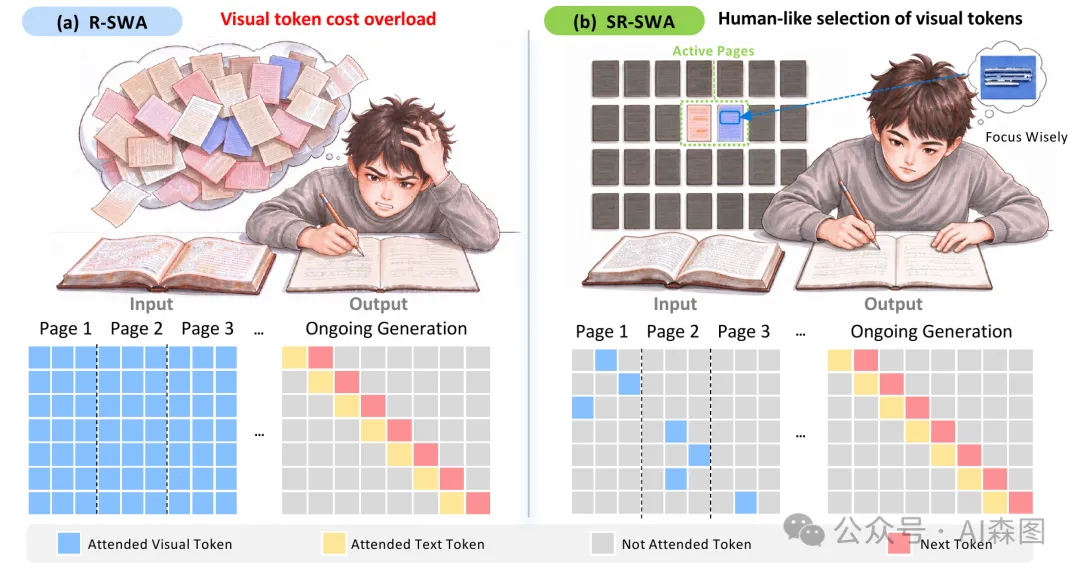
在传统的全注意力机制下,PDF 每翻一页就会产生数以千计的视觉 Token。如果你读到第 200 页,模型每解码一个字,都必须把前 199 页的巨量像素全部重新算一遍。这就像抄书抄到第 200 页,每落下一笔都要把前 199 页从头翻一遍,算力怎么可能不被压垮?
百度的破解思路极其巧妙——模拟人类“抄书匠”的本能:
SR-SWA 稀疏注意力: 人类在抄长卷时,95% 的精力只盯着当前这一页,只有跨页或核对图表时才会精准扫一眼前文。模型引入了“页面门控”与“Token筛子”,把视野锁定在关键页上,无关像素统统丢弃,把单步计算量锁死为一个固定常数。
接力跑式的无限解码机制: 文档按窗口推进,相邻窗口之间只留一页“交接页”复用缓存。一旦翻页完毕,历史缓存直接从显存中物理释放,实现真正的**“边读边扔、零负担前行”**。
四、极客浪漫:“无限剑制”致敬开源社区
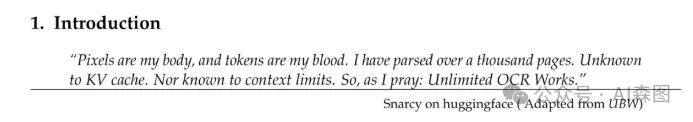
在这次发布的技术报告第一页,官方还埋下了一枚极具情怀的彩蛋。
导言的最上方印着一段让极客与二次元会心一笑的咏唱:
“Pixels are my body, and tokens are my blood... So, as I pray: Unlimited OCR Works.”
(像素为身,Token为血……故而,我在此祈愿:无限文档解析之制。)
这句改编自经典动漫《Fate》中“无限剑制”的名台词,最早源于第一代模型开源时,HuggingFace 社区一位名为 Snarcy 的开发者的随手留言。
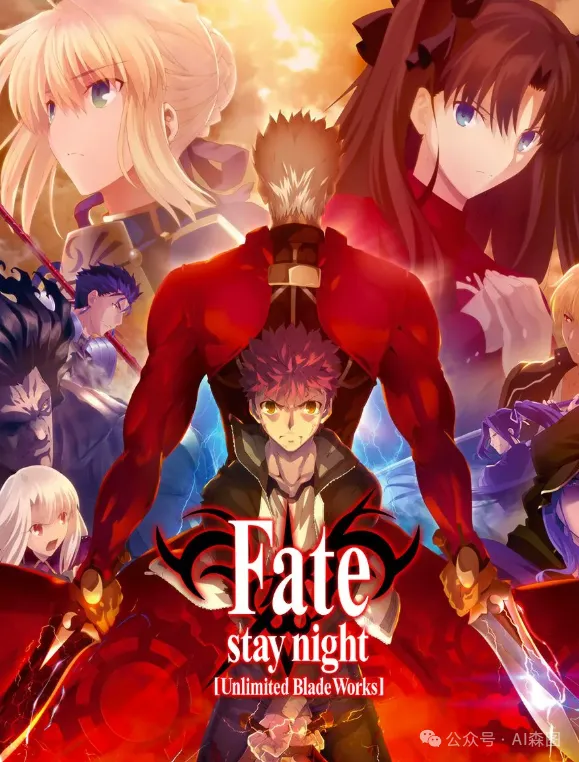
令人意外的是,百度技术团队不仅记住了这句神评,更在发布 2.0 版本时直接将其印在了官方报告的第一行,并郑重署上了这位普通网友的名字。
结语与开源通道
从一代模型的 40 页极限,到二代模型的“不设上限”,这项突破对于日常需要处理合同、财报、论文与古籍数字化的研究者而言,无疑是一场及时的生产力释放。
当行业还在为超长上下文的算力账单肉疼时,一个 5 亿激活的小模型证明了:精巧的算法结构,远比无脑堆砌算力更有力量。
该模型目前已经全量开源,权重与代码均已就绪,感兴趣的朋友可以直接拉取部署:
GitHub 仓库
https://github.com/baidu/Unlimited-OCR
HuggingFace 地址
https://huggingface.co/baidu/Unlimited-OCR-2
关注我,后台私信进群
带你了解更多AI不为人知的秘密