ARTICLE · 1262255
被AI抢发之后,科学家开始不敢用AI了
据科技日报 10 月 19 日转引《自然》网站的报道,最近一个多月,科研圈里至少发生了两起"AI 撞上未发表成果"的事。
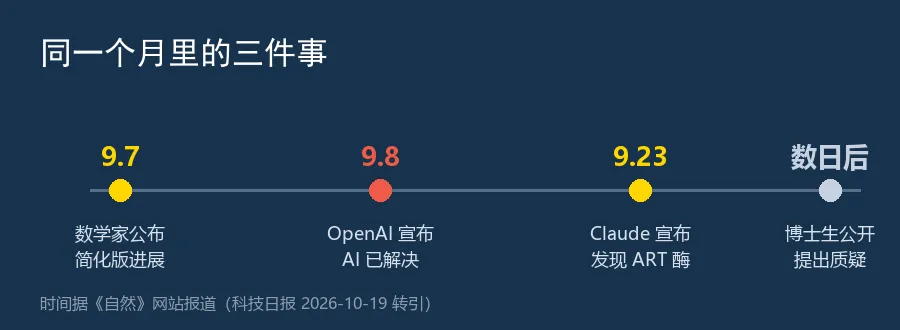
第一起在数学。9 月 7 日,纽约大学数学家巴克马斯特公布了一项研究进展——他和 Anthropic 的数学家莱文特·阿尔波格合作研究纳维-斯托克斯问题已经一年,这次附上了简化版论文。差一天,9 月 8 日,OpenAI 宣布它的 AI 智能体解决了这个著名数学难题。
巴克马斯特随后提出了一个很正常的疑问:他们此前输入 OpenAI 工具的信息,有没有可能被用于训练模型?OpenAI 否认,表示在成果公开前,其研究人员和智能体没有接触过这些成果。
第二起在生物学。9 月 23 日,Anthropic 宣布 Claude 发现了一种新型酶系统,命名为"阵列相关逆转录酶"(ART)——通过分析大量 DNA 序列,发现某些逆转录酶附近存在类似 CRISPR 的重复序列。
几天后,丹麦哥本哈根大学计算生物学博士生马里奥·罗德里格斯·梅斯特提出质疑:他和同事从 2022 年起就在研究相关酶,而且过去几年一直用 Claude 处理科研任务,向它分享过尚未发表的研究材料。他认为 Claude 公布的系统与此前研究存在明显重合。
他自己也说,无法确定 Anthropic 的发现是否受影响,也没有证据。Anthropic 回应称此前并不知道有研究描述过相同发现,并强调 Claude 没有使用用户对话记录进行训练。
这两件事被放在一起讲,最顺手的结论是:AI 的能力正在逼近甚至超过一线科学家,抢发只是时间问题。
但我觉得这个结论跑偏了。它让人把注意力放在"AI 有多强"上,而真正该看的是另一件事——这两起里,未发表的材料都是科学家自己送进去的。
梅斯特团队过去几年用 Claude 处理科研任务,向它分享尚未发表的研究材料。巴克马斯特与合作者也长期把研究过程输入 AI 工具。这不是 AI 主动去偷,是人主动给。所以我们不该把这件事讲成"AI 抢跑",更准确的描述是:我们把草稿交给了工具,然后惊讶地发现工具也会产出东西。
比"太强"更让人不安的,是举证这件事本身。
梅斯特那句话里有最扎心的一层:他怀疑,但他"没有证据"。这就是问题的结构。你要指控 AI 用了你的想法,就得拿到它的训练数据、中间过程、内部时间线——你拿不到。它要证明自己没用,只需要说一句"我们不知道有这项研究"——这句话几乎无法被反驳。两方都拿不出硬证据,但代价完全不对等:怀疑的人背上了举证责任,被怀疑的一方只需要否认。
而且这个局面会一直持续下去,因为训练数据的可追溯性本来就是行业难题,不是哪一家公司能单独解决的。
所以"减少使用这类工具"是个理性的反应,但我认为它反应过度了。把 AI 整个从工作流里拿掉,代价太大,也不现实。真正要做的,是给自己划一条清楚的线。
不该进对话框的:未发表的原始数据、还没成型的假设、正在写的稿件全文、合作方未公开的材料。
可以进的:已发表文献的梳理、语言润色、代码调试、格式检查、图表排版这类不涉及原创内核的活。
边界在哪,每个方向不一样,得自己定。但有一条通用判断标准很好用:如果这段内容泄露出去,我能不能承受?答案是"不能"的,就别进去。
还有一层:把 AI 当成"一个不会说话的助手",是一种错觉。它连接着一家会发布成果的公司。你跟助手说的话,助手的老板听得见——这句话不是指控,是结构事实。
最后说一句可能被打脸的。我认为未来两年这类争议只会更多,而且大部分会像这两起一样——有怀疑,没结论,然后不了了之。在那个局面里,唯一能保护你的不是"不用 AI",是你手里有没有能证明自己工作时序的东西:带时间戳的本地记录、版本管理、组会纪要、预印本。这些东西平时没用,出事的时候是唯一的凭据。