ARTICLE · 1268315
思特威落子物理AI,子公司首推AI训推一体机与工作站
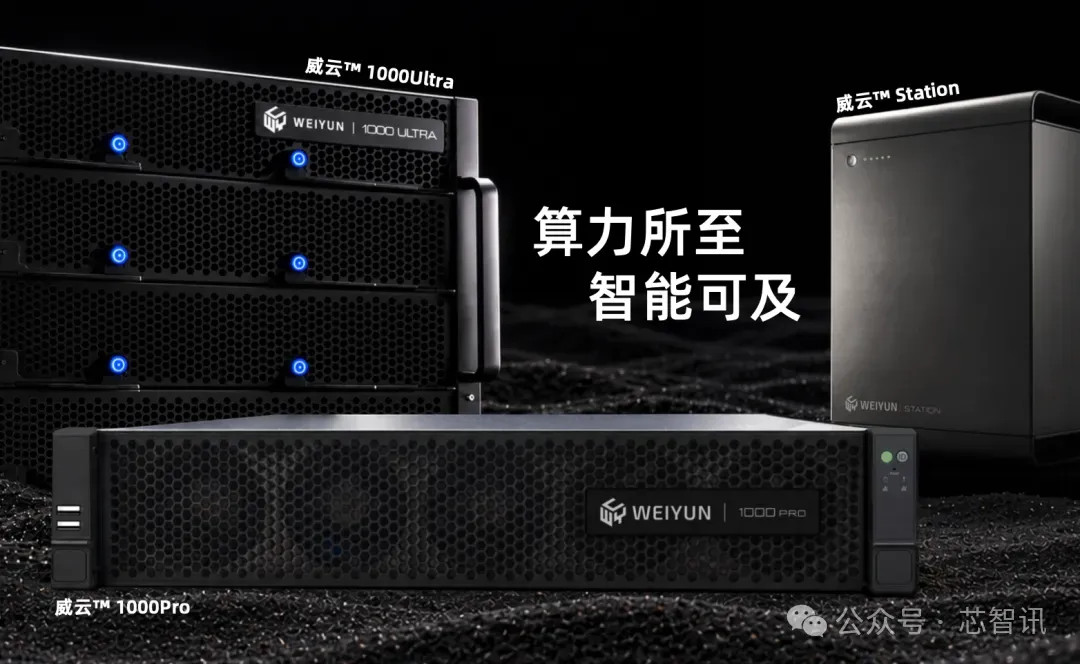
10月28日,国产CMOS图像传感器(CIS芯片)大厂思特威宣布,旗下全资子公司——威云创达(上海)人工智能科技有限公司(以下简称“威云创达”)官网(https://weiyuncreation.com/)正式上线,并发布了威云™ 1000Pro、威云™ 1000Ultra 两款训推一体机,以及威云™ Station物理AI智能体工作站,形成覆盖企业级本地AI计算、高性能大模型推理与专业桌面AI应用的产品矩阵。
这标志着思特威在物理AI领域的布局迈出实质性一步,也意味着这家以图像传感器见长的芯片企业,正试图将能力边界从芯片级向系统级、方案级延伸。
结合其技术架构与思特威近两年的战略轨迹来看,威云创达的登场,补上了思特威从 CIS 感知芯片走向物理 AI 全栈布局的关键一环。思特威正在以“感知—端侧算力—集群训推—高速互连”为链路,构建面向物理 AI 的完整算力与感知底座。
新公司定位:提供AI系统级解决方案
根据工商资料显示,威云创达成立于2026年9月3日,注册资本3000万元,由思特威100%全资持股,法定代表人为赵颂恩。其经营范围涵盖集成电路芯片设计及服务、人工智能行业应用系统集成服务、人工智能应用软件开发、云计算设备制造与销售等。
官网信息显示,威云创达定位为一家专注于人工智能技术研发与应用的科技创新企业,聚焦物理AI与智能计算领域,提供软硬件一体化的产品与解决方案。公司将依托自研创新物理AI智能体和AI-ASIC集群互联等核心技术,持续布局AI训推一体机、AI影视创作工具、定制化AI智能体及垂直领域应用,逐步覆盖从本地算力基础设施到软件产品及行业应用的AI产品生态。
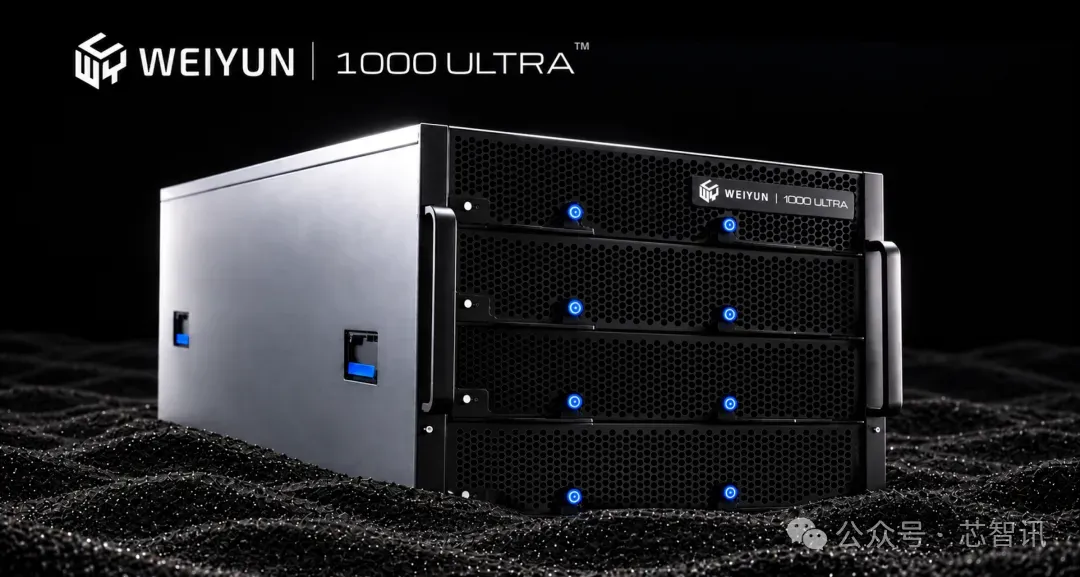
目前,威云创达已公布三款产品包括:威云1000Pro、威云1000Ultra和威云Station。
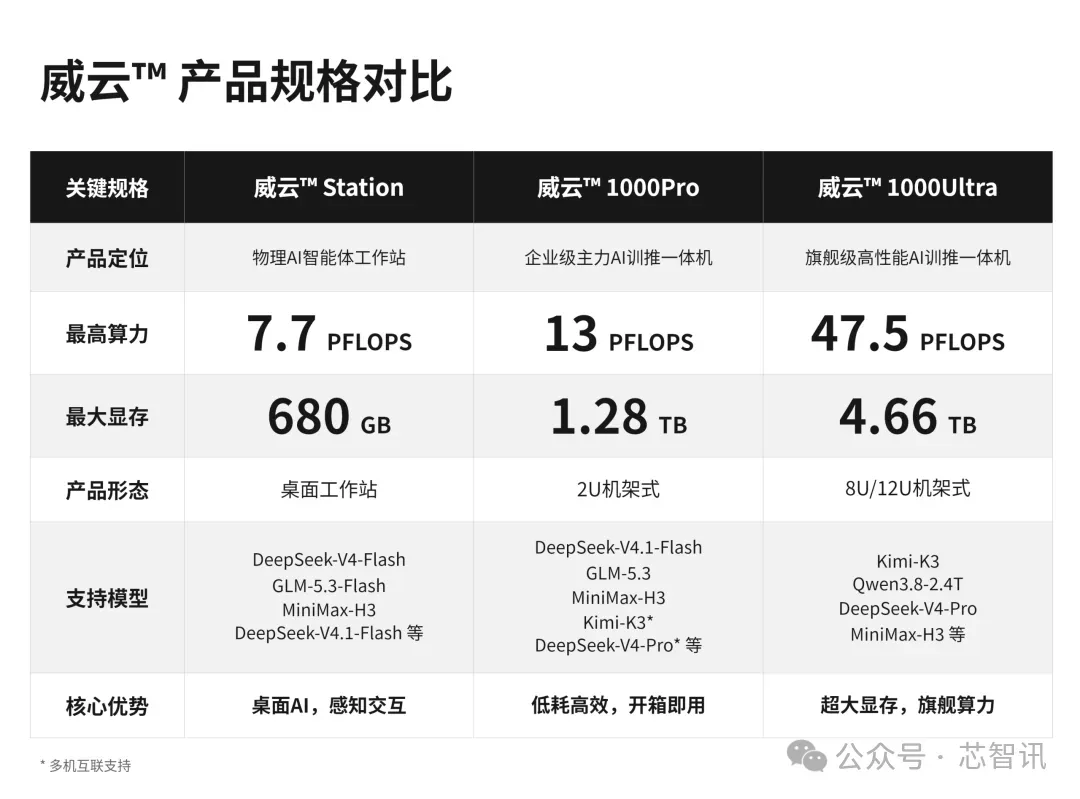
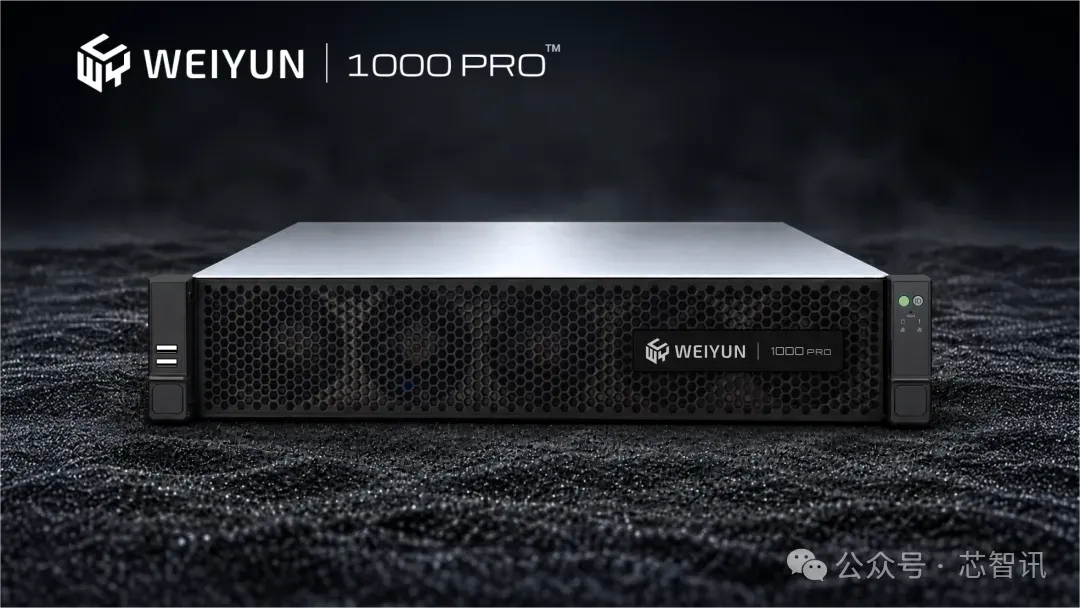
其中,威云1000Pro是企业级主力AI训推一体机,算力最高可达13 PFLOPS,最高1.28 TB显存,推理功耗低至1 kW,采用2U机架式设计,支持DeepSeek-V4.1-Flash、GLM-5.3、MiniMax-H3等主流大模型单机全参数本地部署,并可通过横向扩展实现Kimi K3、Qwen3.8-2.4T等更大规模模型的多机分布式全参数部署,面向企业本地AI数据中心需求,提供从本地算力到业务应用的一体化支撑。
威云1000Ultra是旗舰级高性能AI训推一体机,具备最高47.5 PFLOPS FP4算力以及最高4.66 TB显存,面向超大规模模型全参数部署与复杂计算任务。该产品支持Kimi K3、Qwen3.8-2.4T、DeepSeek-V4-Pro、GLM-5.3以及MiniMax-H3等大模型的单机本地全参数部署,采用8U/12U机箱方案,支持配置升级与多机互联,并可选配GPU及FPGA加速卡,满足大型企业及行业AI平台的高性能计算需求。
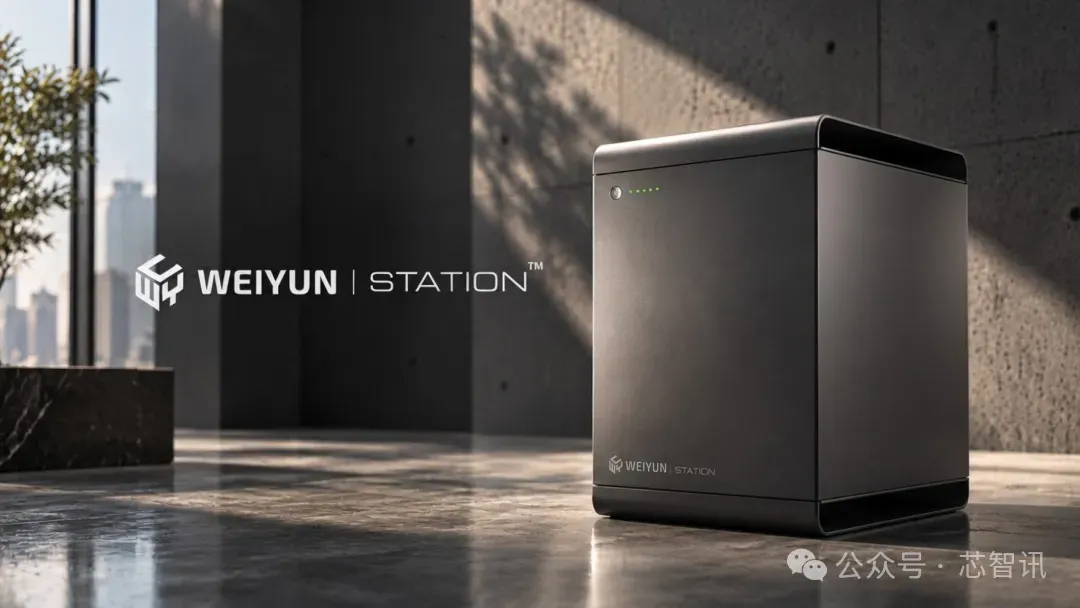
威云Station则是一款物理AI智能体工作站,算力最高可达7.7 PFLOPS,显存达680 GB,面向开发者、行业用户、专业创作者及OPC(一人公司),将本地模型运行、AI应用开发与辅助创作融入桌面工作环境。该产品支持DeepSeek-V4.1-Flash、GLM-5.3-Flash、MiniMax-M3.1-Flash、Qwen 3.5-397B-A17B及MiniMax-H3等模型单机全参数本地部署,并可通过横向扩展实现更大规模模型的多机分布式部署。威云Station支持选配GPU以提升Token吞吐量与视频处理性能,可选配高速网卡,最高支持接入12路高性能、低延迟环境感知摄像头,并结合自研空间感知智能体技术,支持AI对真实环境进行感知、理解与交互。
官网同时披露了WAAG™(Weiyun AI-ASIC Grid)异构AI-ASIC集群互联技术,该架构将算力、存力与运力高密度集成于单台服务器,通过高速光互连实现多集群算力协同与低延迟互联,结合KV Cache动态卸载技术降低存储负载,专为全参数大模型提供高效推理与本地化部署。
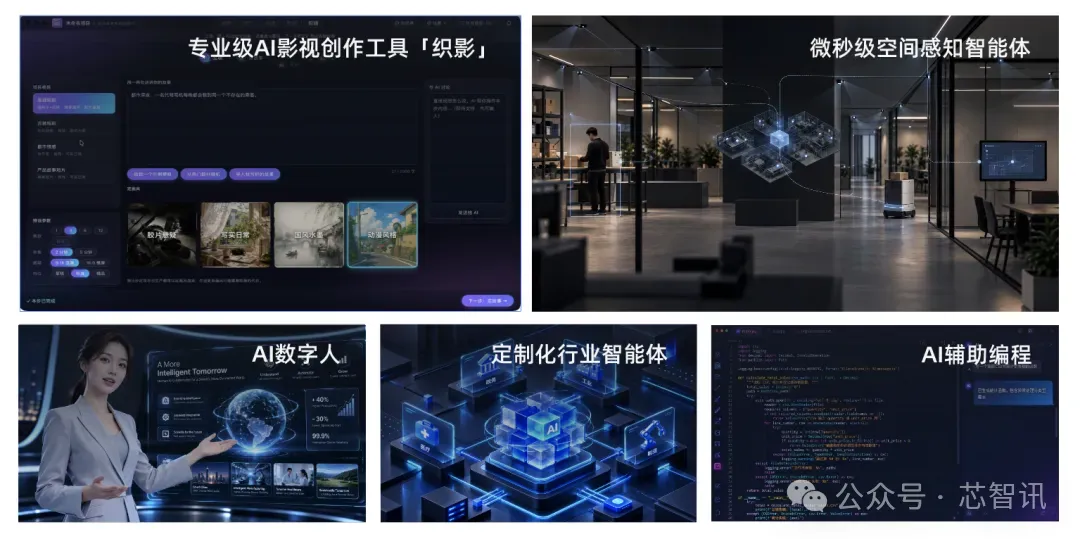
此外,威云创达还围绕内容创作、企业生产与AI数字人等方向提供开箱即用的创新AI应用,包括自研专业AI影视创作工具“织影”、AI数字人、AI辅助编程及定制化行业智能体等。
从“感算一体”到“集群训推”
此前市场对思特威 AI 布局的认知,多停留在“CIS芯片供应商”的层面。在今年 9 月完成的约 32 亿元定增中,第三项募投方向“面向视觉 AI 的 CIS 与端侧 AI ASIC 方案”由思特威与全资子公司飞凌微共同实施,目标是打造“AI ASIC+Sensor”的感算一体架构。飞凌微此前已推出的 M2、A2 芯片,分别覆盖车载视觉与机器人/工业视觉的端侧 AI 处理需求。这构成了思特威 AI 战略的端侧算力基座。
但端侧算力天然受功耗、成本与场景约束。在物理 AI 场景中,无论是具身智能机器人、高阶智能驾驶还是工业检测,单靠端侧芯片无法完成大模型的训练与全参数推理。
威云创达的 WAAG™ 异构 AI-ASIC 集群互联技术,正是瞄准这一缺口:通过高速光互连实现多集群算力协同,结合 KV Cache 动态卸载降低存储负载,支撑最高级别大模型的全参数本地部署。端侧感算一体则负责“就地感知与实时响应”,集群训推负责“重载训练与复杂推理”,两者通过高速互连打通,才构成物理 AI 真正可落地的算力闭环。
思特威在这条链路上的技术储备并非临时拼凑。其 HOC 高速光互联事业群已构建覆盖光器件、高速电路、信号处理与系统集成的全栈研发能力,核心成员拥有十年以上相关经验。此前的定增募投说明书中亦明确提出构建“视觉 AI—AI 互连—端侧 AI ASIC”全链路生态,并将 MicroLED 光互连列为持续布局方向。威云创达的 WAAG™ 架构,正是这一技术积累在系统级产品上的首次公开落地。
CIS仍是物理AI感知的第一入口
需要强调的是,思特威向AI算力与系统层延伸,并不意味着 CIS 主业被边缘化。恰恰相反,感知是思特威切入物理 AI 的独有入口优势。
物理 AI 的核心在于让智能体理解并与真实世界交互,而视觉感知是这一交互的起点。思特威在全局快门 CIS 领域的技术积累——SmartGS 系列在机器人避障、空间定位、工业检测中的表现,使其成为物理 AI 数据采集环节的关键供应商。与奥比中光在具身智能 3D 视觉上的战略合作,进一步强化了“深度引擎+CIS”的双芯协同,覆盖从 EGO 第一视角数据采集到 WristCam 腕部交互的多模态数据平台。
2026 年上半年,思特威 AI 智视生态板块贡献营收 4.95 亿元,无人机、机器人、AI 眼镜等新兴场景的机器视觉需求正在成为明确的增量来源。这些场景正是物理 AI 的典型落地场域。感知芯片积累的客户关系、场景理解与数据接口经验,构成了思特威向系统级方案延伸时区别于纯算力厂商的差异化壁垒。
不止 CIS,思特威的物理 AI 全栈布局
思特威正在落下面向物理 AI 的一盘大棋,棋盘之上,CIS 感知芯片、端侧 ASIC、MicroLED光互连,以及威云创达本次全新发布的 AI 算力产品,共同构成完整底座拼图。当然,从单点 “芯片级能力”,走向一体化 “系统级方案竞争力”,中间仍存在不容忽视的组织与能力落差。系统集成与 AI 软件能力,需要一套不同于芯片研发的人才结构与运营逻辑。WAAG™架构主打算力、存力、运力高密度集成,为端侧物理 AI 场景提供差异化的技术路径。
但思特威的战略主线已经十分明确:当 CIS 行业告别单纯的像素竞赛,转向性能、场景、算力一体化的综合竞争时代,思特威没有局限在传感器芯片赛道,而是以视觉感知为根基向上延伸,打通互连、端侧算力与集群训推链路,攫取全链路附加值。
威云创达本次三款 AI 算力产品正式发布,正是思特威这盘物理 AI 感知算力底座大棋,从芯片层面的前瞻布局,迈入系统级产品落地验证阶段的标志性一步。棋局成败的核心,在于威云创达能否把思特威长期沉淀的芯片硬件工程优势,沉淀转化为系统产品在真实场景里稳定可靠的交付能力。
对此,我们拭目以待。
编辑:芯智讯-浪客剑