ARTICLE · 1269102
百度Unlimited OCR 2:长文档进知识库,先验收跨页结构
2026-10-28 整理 · 文档解析 / 知识库实操
识别出每个字,并不等于还原了一份文档。页序、表格和段落接续,决定了后面的检索是否可信。
这次新增的能力怎样理解
百度于10月27日在模型卡中宣布Unlimited OCR 2,并公开超长文档解析评测MarathonDocBench。它用SR-SWA处理长序列中的文本与视觉关联,目标是让长文档解析的解码开销更可控。名称里的“Unlimited”不代表没有输入、输出、硬件或运行时间限制。
本篇以新版本为切入,讲清从分页图片到知识库前处理的路径。没有运行模型推理;官方后处理脚本的合成样例检查已执行,验证范围见下文。不要把转换成功当成OCR识别准确率的证明。
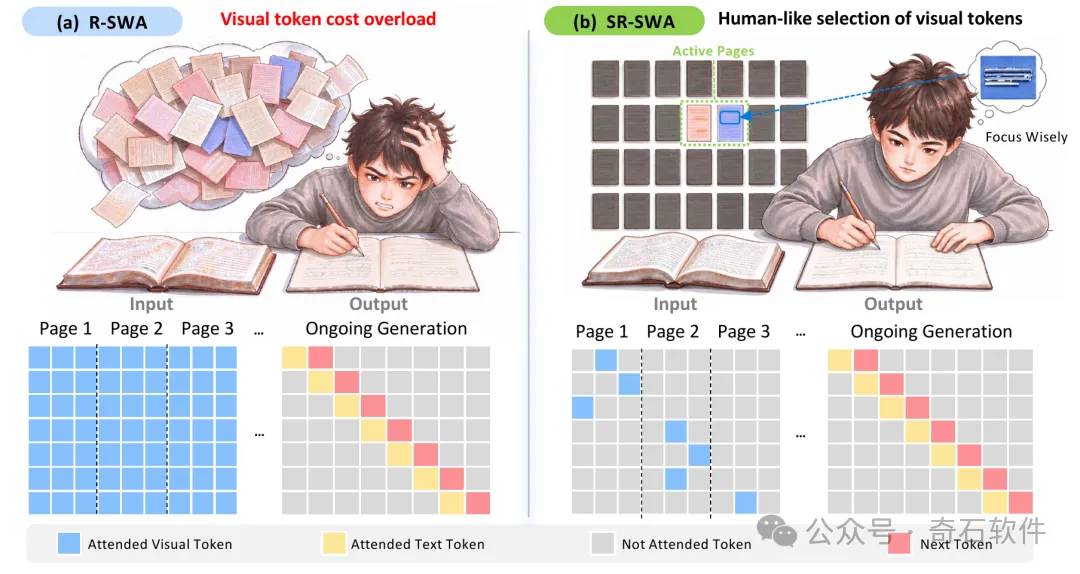
图:百度Unlimited OCR 2官方架构示意,来源为模型卡与官方仓库;用于解释SR-SWA结构,不是本次识别或性能实测结果。
先做一份三页测试材料
选取有权处理、没有个人敏感信息的三页材料:第一页有标题和正文,第二页开始一张表,第三页接续表格。保留原PDF和页码,另外人工记录标题层级、表头、合计值和跨页关系,作为验收答案。
官方Transformers多页入口为infer_multi,要求按顺序传入页面图片。下面片段仅适用于已经按模型卡装好环境并载入model、tokenizer之后,不是完整安装脚本:
Python
pages = [f"your_doc/page_{i}.jpg" for i in range(1, 4)]
text, num_tokens = model.infer_multi(
    tokenizer,
    image_files=pages,
    output_path="output/multi",
    save_results=True,
)
模型卡列出的测试环境包含Python 3.10、特定torch和Transformers版本及A800-80GB。这个记录不等于最低显存要求,也不能反向推断普通显卡一定可用。首次加载涉及自定义代码,应先审阅仓库并固定可信修订。
原始输出还需要一次转换
Unlimited OCR 2原始输出含PAGE、BLOCK等版面标记,并非直接生成Markdown。官方utils目录的process_unlimitedOCR2.py负责转换标题、正文与表格,并处理跨页接续;表格可能保留HTML,不能假设都是竖线表格。
Shell / 仓库根目录,raw中放原始输出
python utils/process_unlimitedOCR2.py \
    --infer-dir raw \
    --out-dir pred
本次用官方convert函数处理一份合成两页输入,确认示例标题与两段正文保留、BLOCK标记被去除。未测试图片识别、跨页表格合并正确率或百页性能,也没有把合成材料冒称真实业务文档。
知识库入库前检查四件事
先核对页序,再检查跨页表头是否重复或丢失、金额与单位是否正确、章节是否被错误拼接。最后为切分后的片段保留文档ID、原始页码和版本,使回答能回到原页面。转换后的文字顺序正确,也不保证引用定位已经做好。
长文档服务使用SGLang时,官方给出定制wheel及页面窗口参数。窗口变小可能降低内存峰值,也可能影响跨窗口接续,不能只追求不报显存错误。先验收小文档,再逐步增加页数与并发。
这类更新能改善RAG的资料入口,但它不负责检索排序、权限控制和回答事实核查。文档解析、检索与生成应分别评估,才能知道错误究竟发生在哪一步。
资料来源
官方新模型卡
https://huggingface.co/baidu/Unlimited-OCR-2
官方代码仓库
https://github.com/baidu/Unlimited-OCR
后处理说明
https://github.com/baidu/Unlimited-OCR/blob/main/utils/README.md
本文由AI辅助整理;实测状态已在正文注明。封面为AI生成概念图,正文图示与官方原图分别标注。