ARTICLE · 1271700
AI 用中文真的更费 token 吗?我用 20 万条平行文本测了一遍
数字折腾 · 实测
我看到一篇报道,说同一个 AI 模型处理不同语言,token 数量最多能差 17 倍。按 token 收费时,非英语用户可能要多花钱。
这件事是真的。但“17 倍”不是中文与英文的差距,也不是每个模型都这样。它是特定分词器在约 200 种语言文字组合中,最贵与最便宜两端的极值。
我把报道引用的研究代码、原始结果和 FLORES-200 平行语料找了出来,又用 OpenAI 新旧两代分词器重跑了一遍。
先说结果:
—新版 OpenAI 分词器处理简体中文,token 总量是英语的 1.27 倍。
—旧版分词器中,中文是英语的 1.89 倍。
—新版分词器的 203 种语言文字组合,最大差距为 13.77 倍,与研究公布的 GPT-5 结果 13.8 倍一致。
—藏语和老挝语仍超过英语的 8 倍。部分低资源文字承担的负担,远高于中文。
所以,“语言税”确实存在。中文也确实要多交一点,但不能把极端的 17 倍扣到中文头上。
语言不同,tokens 数不同
01AI 为什么要先切 token
大模型不直接读取字和单词。文字进入模型前,要先经过 tokenizer,也就是分词器。
它会把文本切成一串 token。一个 token 可能是一个英文单词、半个单词、一个汉字、常见词组,也可能只是某个字符的一部分。
API 通常按 token 计费。上下文窗口也按 token 计算。因此,同样的信息如果被切得更碎,会带来三个直接影响:
—输入价格更高;
—同一上下文窗口能装下的内容更少;
—模型读取输入时需要处理更多位置。
问题不在于某种语言“天生低效”。分词器的词表来自训练数据。某类文字出现得多,常见片段就容易被收进词表;出现得少,文字就容易被拆成字符、组合符号,甚至字节。
0217 倍到底是怎么来的
报道引用的是 CLEAR 发布的 The Tokenizer Tax 研究。研究者使用 FLORES-200 数据集,把同一批内容的专业翻译交给不同分词器统计。
他们采用的主要指标是:
token 最多的语言总量 ÷ token 最少的语言总量
研究公布的部分结果如下:
这张表有两个容易被忽略的条件。
第一,17 倍来自最极端的模型和语言文字组合。它不是所有模型的平均值。
第二,这个指标比较的是最贵与最便宜两端,不是统一与英语比较。不同模型的两端语言也可能变化。
前 20 种网络常用语言的差距,大多在 1.5 到 3.1 倍之间。扩大到约 200 种语言后,差距才明显拉开。真正吃亏的往往是数字资料少、文字系统又少见的语言。
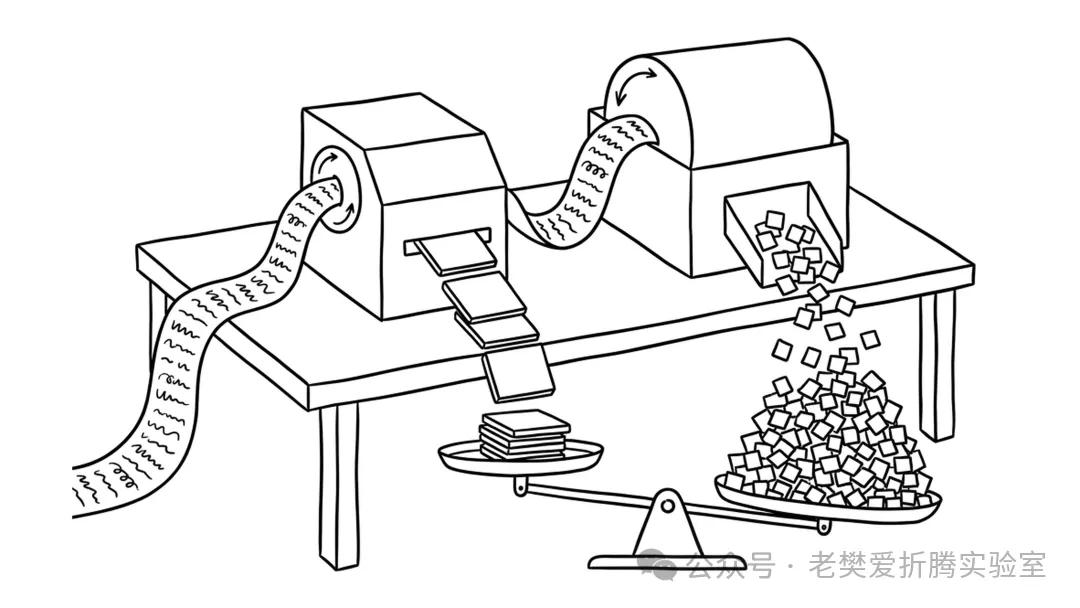
图 1:同样的内容带,两台机器切出的大小和数量完全不同
03我怎么复测
为了避免翻译质量影响结果,我没有临时用机器翻译拼一批句子,而是直接使用 FLORES-200。
这套数据包含 997 组内容。每一组都有人类专业翻译版本。我选择了 203 种语言文字组合,总计统计 202391 条平行文本。
测试方法与 CLEAR 的公开代码保持一致:
01读取 FLORES-200 的 dev 数据;
02将每种语言的 997 条文本连在一起;
03不添加聊天模板和特殊 token;
04分别用 cl100k_base 和 o200k_base 编码;
05统计每种语言的 token 总数;
06计算相对英语的倍数,以及全体最大值与最小值之比。
cl100k_base 可代表 GPT-4 这一代分词方式。o200k_base 用于 GPT-4o、GPT-5 等较新的模型。GPT-5 与 gpt-oss 在这批文本上的公开结果也相同。
04先复现研究中的单句
CLEAR 用了这样一句英文:
People should benefit from AI, regardless of the language they speak.
使用新版 OpenAI 分词器,我得到:
英语 13、马拉雅拉姆语 26、阿姆哈拉语 78,逐项复现了研究页公布的数据。
中文虽然只有 24 个字符,仍用了 16 个 token。字符少,不代表 token 一定少;字符数与 token 数不是同一个计量单位。
0520 万条平行文本的结果
单句容易偶然命中高频词。长语料更接近日常文档处理。我把每种语言的 997 条文本全部统计后,得到下面的结果。
新版分词器的最低值是英语,共 25543 个 token。最高值是用 Ol Chiki 文字书写的桑塔利语,共 351837 个 token。
两者相除:
351837 ÷ 25543 = 13.77
四舍五入后是 13.8 倍,与 CLEAR 给 GPT-5 / gpt-oss 的结果完全一致。
这一步很关键。它说明报道引用的数据不是随手挑几个句子算出来的。公开代码和语料能够复现主要结论。
06中文有负担,但新版已经改善
中文在新版测试中是英语的 1.27 倍。换句话说,在输入单价相同的前提下,表达这批相同内容,中文输入成本约高 27%。
固定上下文窗口下,中文能装下的同等内容约为英语的 79%。这个数字不是日常每句话都固定如此,而是这批平行语料的总体结果。
旧版中,中文是英语的 1.89 倍。换到新版后,相对差距缩小约三分之一。
其他语言的改善更明显:
—马拉雅拉姆语从 8.94 倍降到 1.95 倍;
—泰米尔语从 7.61 倍降到 1.98 倍;
—印地语从 4.81 倍降到 1.58 倍;
—缅甸语从 11.69 倍降到 3.18 倍。
这说明 tokenizer 不是改不了。扩大词表、增加多语言数据、重新安排词表容量,都能降低差距。
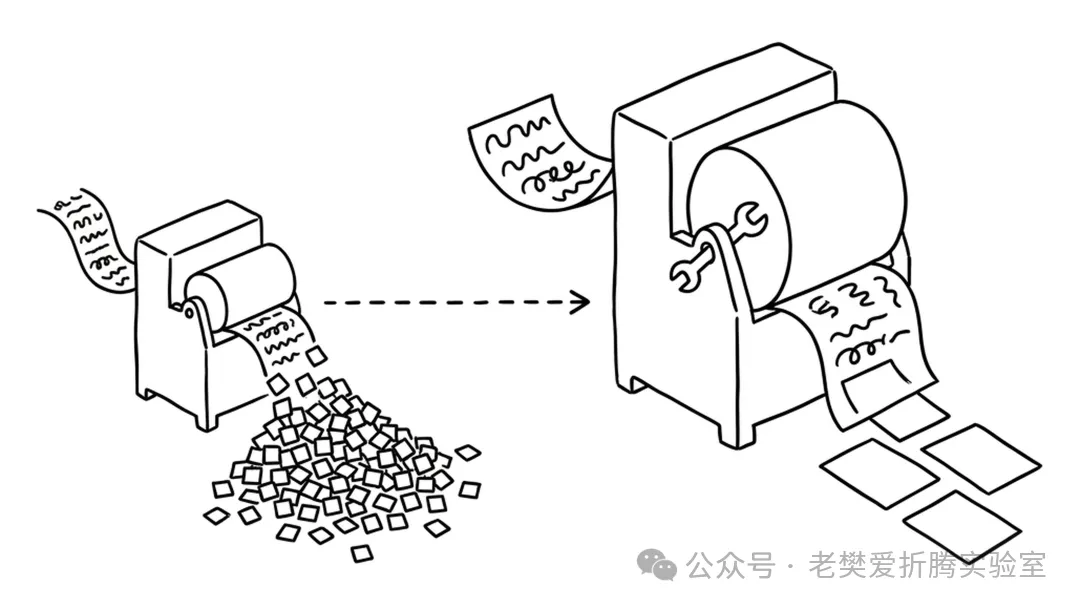
图 2:换一版分词器,同一条内容带被切成更少、更大的块
不过改善并不均匀。老挝语仍为英语的 8.26 倍,藏语为 8.17 倍。新版词表照顾了一批常用语言,却没有把所有低资源文字一起带上来。
07token 多,是否等于实际账单贵同样倍数
只看输入 API,并且服务商按统一的每百万 token 单价收费时,输入价格与 token 数基本成正比。中文 1.27 倍,就意味着这批输入约贵 27%。
实际账单还要看几项条件:
—输入和输出可能采用不同单价;
—缓存输入可能更便宜;
—聊天模板和系统提示词会增加固定开销;
—推理模型还可能产生不可见的推理 token;
—不同语言的回答长度不一定相同;
—包月产品通常不会逐条展示 token 费用。
因此,这次测试能严格说明“相同内容会占用多少输入 token”,不能直接替你算出每月账单。
延迟也一样。输入 token 更多,模型的预填充工作通常更多。但网络、服务商负载、批处理和硬件都会影响速度。不能把 8 倍 token 简单写成 8 倍等待时间。
上下文占用是最直接的影响。一个固定大小的窗口,token 越多,能放进去的原文、对话记录和检索材料就越少。
08这项研究还有哪些局限
核心结论可靠,不代表每个数字都能脱离条件使用。
/最大值除以最小值容易突出极端项
13.8 倍和 17 倍都是两端极值。只要有一个文字系统特别不适配,指标就会明显升高。
CLEAR 也公布了基尼系数,用来观察整体分布。看一款模型时,最大差距和整体分布应该一起看。只摘一个 17 倍,容易把“少数语言受到严重影响”说成“所有非英语语言都贵很多”。
/平行翻译也不能消除语言本身的长度差异
FLORES-200 保证语义对应,但不同语言表达同一意思,本来就可能长短不同。CLEAR 用字符长度做了对照,认为这种差异通常只有几十个百分点,解释不了数倍到十几倍的 token 差距。
这个解释有道理,但字符也不是完全中性的单位。不同文字使用组合符号、音节和字形的方式不同。测试适合比较真实使用成本,不适合拿来判断某种语言本身是否“啰嗦”。
/token 效率不等于模型质量
切得少,只说明编码紧凑。它不能证明模型更懂这种语言,也不能证明回答更准确。
如果词表收进了很多语言片段,但训练语料和对齐数据不足,模型仍可能答不好。完整评测至少还要加上准确率、生成质量和文化语境理解。
/公开结果里还有异常 tokenizer
研究仓库的原始结果中,还有两项约 840 倍的异常值。代码注释也留下了检查未知 token 和往返解码的待办。发布表没有把这些异常项当作正式结论。
这种处理方向合理,但排除规则还可以写得更清楚。17 倍不是“把 CSV 中最大的数字直接抄出来”,而是清理可疑 tokenizer 结果后的最大值。
09想自己试,十几行代码就够
安装 tiktoken 后,可以先测自己常用的一段中英文:
import tiktoken
enc = tiktoken.get_encoding("o200k_base")
texts = {
"英文": "People should benefit from AI, regardless of the language they speak.",
"中文": "无论使用什么语言,每个人都应该从人工智能中受益。",
}
for language, text in texts.items():
print(language, len(enc.encode(text)))
我实测输出为:
英文 13
中文 16
测试自己的业务材料时,最好遵守三条规矩:
—使用同一内容的人工翻译,不要拿两篇无关文章比较;
—一次测几千字,不要只测一句话;
—使用目标模型真正采用的 tokenizer,不能拿 GPT 的结果代替 Claude、Gemini 或开源模型。
如果模型没有公开 tokenizer,可以使用厂商的 token 计数接口。不要用“中文一个字约等于一个 token”之类经验值代替实测。
10结论
“非英语用户要交 tokenizer 税”是真的。它既影响按 token 计费,也会挤占上下文窗口。
“中文比英文贵 17 倍”是错的。在这次可复现测试中,新版 OpenAI 分词器处理简体中文是英语的 1.27 倍。真正达到 8 倍以上的,是老挝语、藏语和部分更少见的文字系统。
这也不是无法改变的自然规律。旧版到新版之间,中文、印地语、泰米尔语、马拉雅拉姆语和缅甸语都明显改善。分词器怎么设计,训练数据覆盖哪些文字,决定了谁要多交这笔费用。
对普通中文用户,最实用的做法不是把中文提示词先翻成英文。先用自己的真实材料,测一下正在使用的模型。中文多花多少 token,答案不在语言名称里,而在具体模型的 tokenizer 里。
11参考资料
—Rest of World:<https://restofworld.org/2026/ai-tokenizer-tax-non-english-languages-cost-inequity/>
—CLEAR 研究页:<https://clear-languages.org/blog/the-tokenizer-tax>
—CLEAR 复现代码:<https://github.com/clear-coalition-ai/token-cost-equity>
—FLORES-200 数据集:<https://github.com/facebookresearch/flores>
—Petrov 等,NeurIPS 2023:Language Model Tokenizers Introduce Unfairness Between Languages
—Ahia 等,EMNLP 2023:Do All Languages Cost the Same?