ARTICLE · 1278002
Qwen4 源码提前现形:20 行 PR 钉死 100 万上下文,你的本地部署该等吗
Qwen4 还没发布,但代码已经先把它剧透了。
10 月 28 日,QwenLM/qwen-code 仓库合并了一个只加 20 行、作者 wenshao 的 PR(#15762),标题直白得很:把 qwen4 这一整代按 100 万 token 上下文 处理。所谓"源代码泄露",其实是一场发生在公开 GitHub 上的"官方预热"——但这 20 行,信息量大得吓人。
一、三个时间点,全在盯着 Qwen4
- 阿姆斯特丹 Apsara 大会
下午开场,议程上 Qwen 占了两段; - 一张倒计时页
把发布写在"明天凌晨"; - qwen-code 的 PR
,昨天已经把 qwen4 全部按 1M 上下文算好了。
截至发稿,官方渠道上一条 Qwen4 的消息都还没有。
二、qwen.ai 研究页:最新四条,一条 Qwen4 都没有
先去最不该空的地方看一眼——qwen.ai 的研究页,"最新进展"四条依次是 9 月 20 日的 Qwen-Image-2.1、9 月 18 日的 Qwen3.8-LiveTranslate、9 月 18 日的 Qwen3.8-Omni-Flash、9 月 3 日的 E-Commerce Bench。清一色 Qwen3.8 系,没有 Qwen4。
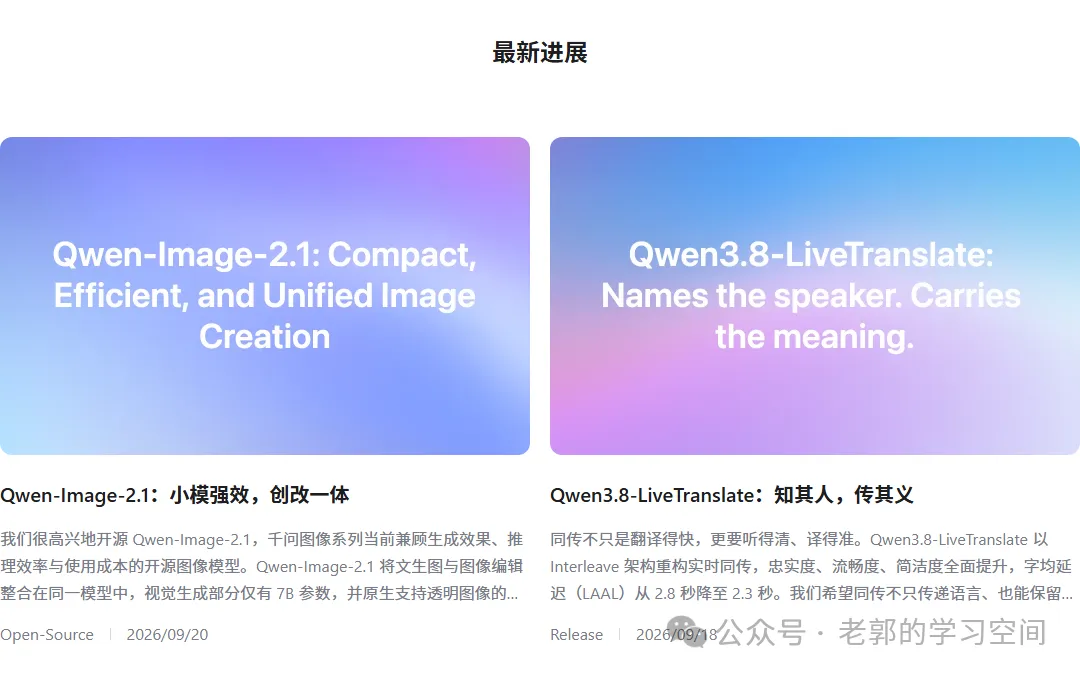
qwen.ai 研究页最新进展:四条全为 Qwen3.8 系,无 Qwen4
三、那个 20 行的 PR,到底改了什么
10 月 28 日合并的 #15762,标题 fix(core): size the qwen4 generation at 1M,两个文件,+20 −0。
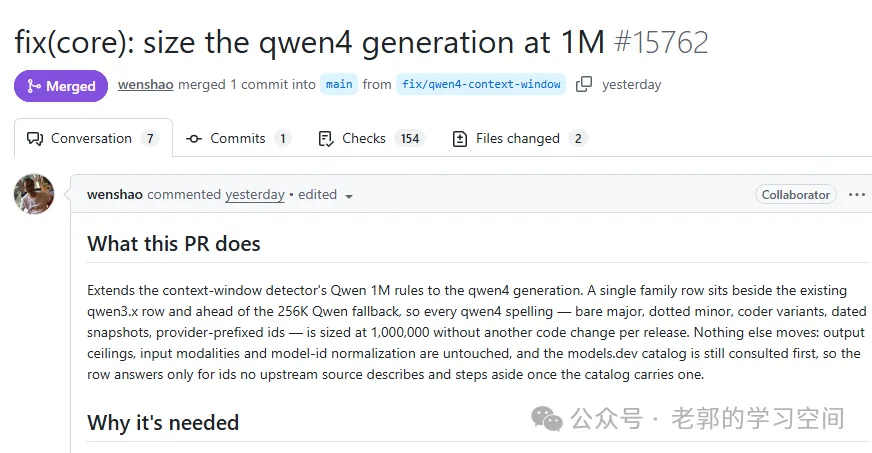
qwen-code PR #15762:size the qwen4 generation at 1M,作者 wenshao
改动很小:在 qwen3.x 那一行旁边、256K 兜底行之前,加一行 qwen4 家族规则。效果是——所有拼法(裸大版本、带小数点的次版本、coder 变体、带日期的快照、带 provider 前缀的 id)一律按 1,000,000 算,而且"不用每发一版改一次代码"。输出上限、输入模态、模型名归一化一处没动。
PR 里还写了原因:改动前,models.dev 和内置目录里一个 qwen4 条目都没有,整代都掉进了 262,144(256K) 的兜底行。旧症状很隐蔽——客户端以为窗口只有真实值的四分之一,自动压缩会在真实窗口 22% 处就触发,而且不报错,谁都看不出来。
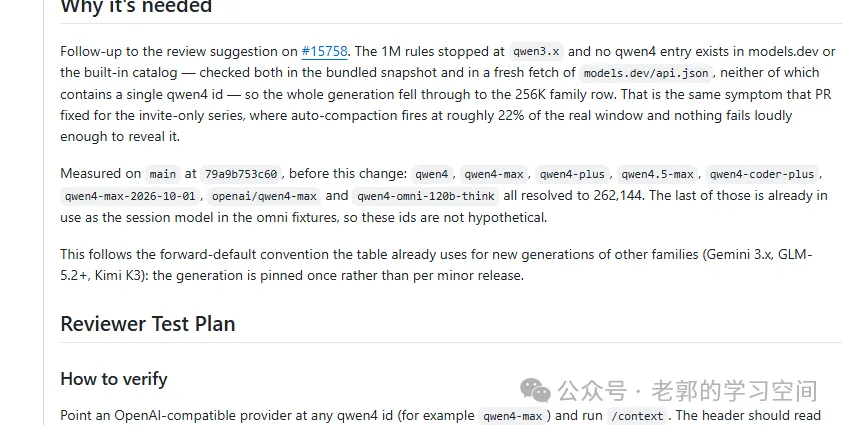
PR 说明:为何需要这行规则——整代此前掉进 256K 兜底
最有信息量的是那张实测清单:改动前,下面八个 id 全部解析成 262,144——qwen4、qwen4-max、qwen4-plus、qwen4.5-max、qwen4-coder-plus、qwen4-max-2026-10-01、openai/qwen4-max、qwen4-omni-120b-think。作者特意补了一句:最后一个已经在 omni 的测试夹具里当会话模型用了,"所以这些 id 不是假设"。一个 120B 的全模态 Qwen4,在代码里已经跑了不止一天。
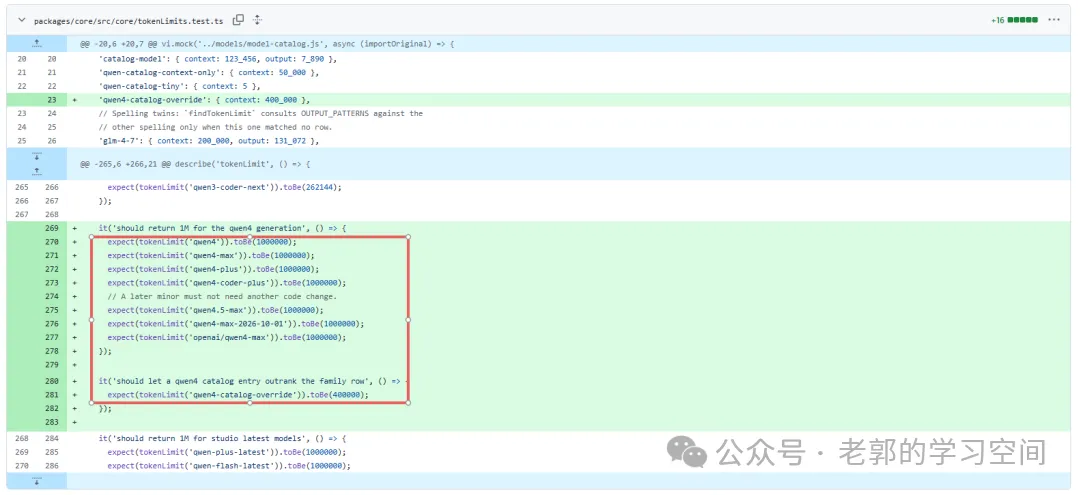
实测清单:八个 qwen4 系列 id 改动前均解析为 262,144
验证方法也写得很实:接一个 OpenAI 兼容 provider,用任意 qwen4 id 跑 /context,改前显示 262.1k,改后显示 1000.0k。同一套"新世代先钉死一次"的约定,之前用在 Gemini 3.x、GLM-5.2+、Kimi K3 上。
四、Arena 上的 Kerria:32 分钟 vs GPT-6 Astra 49 分钟
10 月 27 日,LMArena 上出现匿名模型代号 Kerria。追踪办法是 tokenizer 陷阱:Code Arena 里四个只有 Qwen 系会绊倒的 token,Kerria 绊了三个;另外 13 家(Kimi、DeepSeek、OpenAI、Google、Mistral 等)的 52 个 token 一个没绊。在这之前是 Kalmia——阿里的 K 字头代号有前科:Kiteki、Kizen-alpha、Korin 分别对应 Qwen3.5、3.6、3.7 Max 预览版。
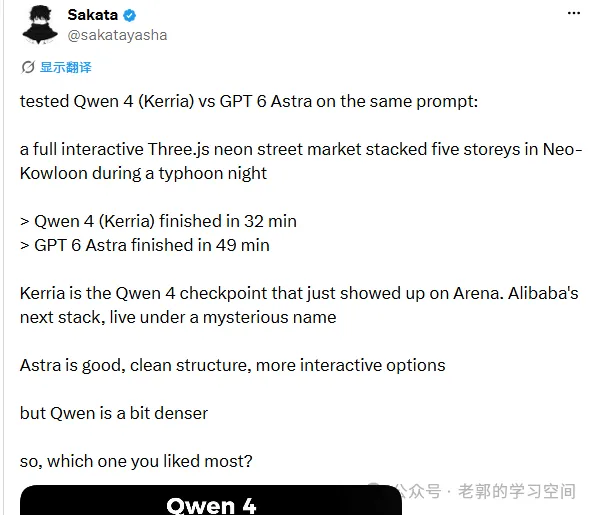
Kerria(Qwen4)与 GPT-6 Astra 同一道 Three.js 题对比:32 分钟 vs 49 分钟
今天凌晨有人拿它和 GPT-6 Astra 做同一道题:一个完整的交互式 Three.js 霓虹街市,九龙城寨风格叠五层、台风夜。Qwen4(Kerria)32 分钟跑完,Astra 49 分钟。评价是 Astra 结构更干净、可交互选项更多,Qwen 更密。17 分钟差说明不了谁更强,但说明这代模型已经能接这种长任务活。
五、那张倒计时页,官方没转过
10 月 28 日 18:00,有人贴出倒计时页截图,配文"你们是不是忘记发这个?@Alibaba_Qwen"。页面写着 Qwen4、Onward to the Next-Gen — Lightning-Fast,Estimated Release Time: 2026-10-29 10:00 (UTC-08:00)——换成北京时间是 10 月 30 日凌晨两点。右下角一只举着教鞭的熊,黑板上 Qwen4 Open Weight Soon。页面做得像官方,但 @Alibaba_Qwen 没转过它,发帖人自己都在问"是不是忘记发"。
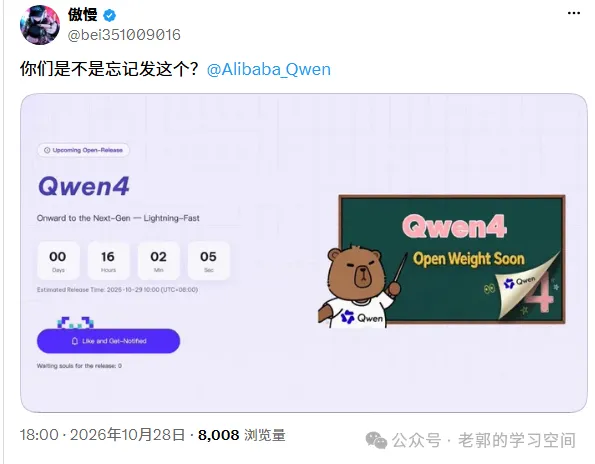
倒计时页:Qwen4 Open Weight Soon,发布时间 2026-10-29 10:00 UTC-8
六、一句话判断:代码最硬,但它证明"已经在用"
三个信号里,代码最硬——但它证明的不是"要发了",而是"已经在用"。一个只在内部跑、目录里查不到的全模态型号被写进测试夹具,一个 PR 把整代上下文钉在 100 万,连 qwen4.5-max 都覆盖。这类改动不会为一个不存在的模型做。
Arena 上的 Kerria 说明模型能跑、能出活,但匿名对战不等于发布;倒计时页最软:官方没背书,时间还定在美国太平洋时间的上午。
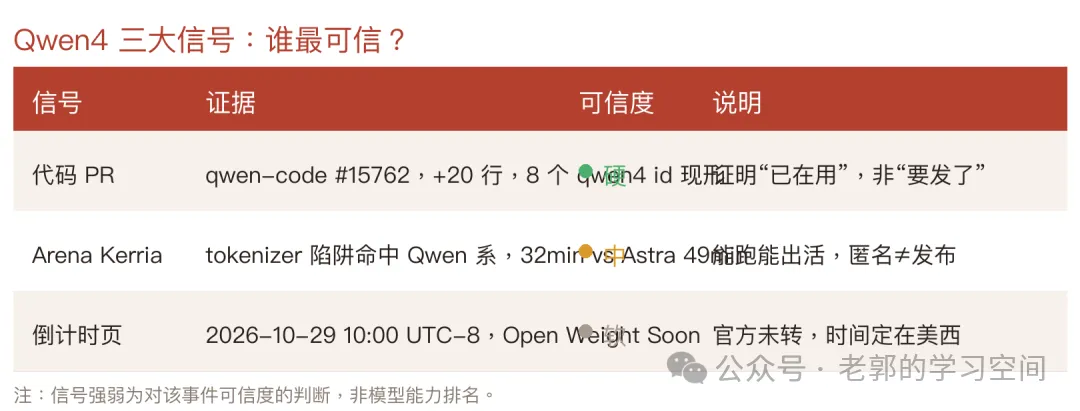
Qwen4 三大信号可信度对照
官方口径其实只有两句:9 月 22 日云栖大会说 Qwen4 采用新一代架构、正在训练;之后的 Qwen4.5、Qwen5 计划扩到 5 万亿到 10 万亿参数。四档名字 Max / Plus / Flash / 27B 出自主论坛投屏,书面新闻稿里没有——27B 被当作开放权重那一档,但许可证到今天还没公布,参数、价格、基准全是空的。
真正的开关只有一个:Hugging Face 上出现 Qwen4 的仓库,或者 API 文档里多出一个 qwen4 的型号。在那之前,能下载的最新一档还是 Qwen3.8-27B。
对你的本地部署意味着:256GB 内存跑 27B 开放权重刚好富余(Qwen3.8-27B 的 Q4 约 16GB),真要上 120B 全模态那档,得等发布后看权重体积,大概率要双机或多卡。这 20 行 PR 告诉我们的是——Qwen4 已经在路上,但别拿倒计时页当闹钟。
数据来源:QwenLM/qwen-code PR #15762(公开仓库)、LMArena 匿名模型 Kerria 追踪、社区公开的 Apsara 倒计时页截图;官方口径引自 9 月 22 日云栖大会。型号 id、行数、时间戳均为原文披露的具体信息,未做延伸编造。