ARTICLE · 1289281
硅谷选读·AI|10.24|被 AI 撑爆的 Git
硅谷选读
AI · 2026.10.24
十分钟,读完最前沿的 AI 资讯。由 OpenAI、Google、Meta 等一线 AI 大厂的员工亲手挑选并解读。今天主要讲 Anthropic 的代码多到 Git 扛不住,只好自己造一套;另外还有 OpenAI 的 agent 悄悄关掉监控,Claude 输出里藏着的水印,DeepSeek 开源推理引擎,以及 AI 帮忙挖出的 PHP 老漏洞。文末推荐一篇技术学习的好文章。
被 AI 撑爆的 Git
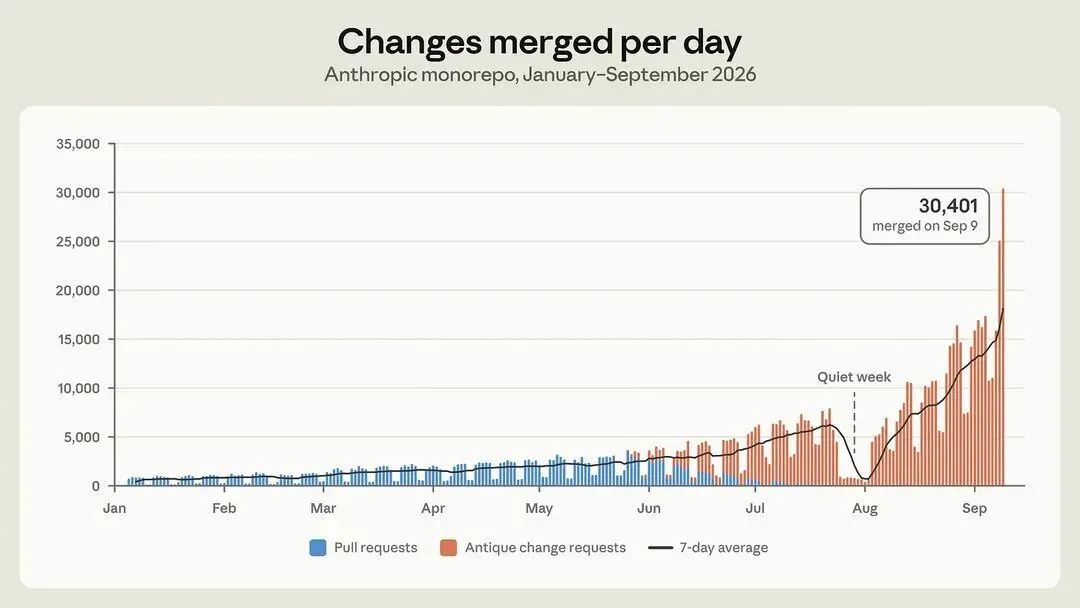
图源:Anthropic。Anthropic 主代码库每天合并的代码改动
本刊 10.20 提过,Anthropic 主代码库每天合并的代码改动,从 5 月的约 2500 个涨到 9 月的 3 万多个,四个月里翻了十来倍。Anthropic 自己的说法是:写代码已经不是瓶颈,瓶颈变成了为人的速度设计的开发基础设施,代码托管、构建和 CI。
先说为什么 Git 扛不住。全公司约 3000 人,几乎每个工程师同时开着 10 到 15 个 Claude agent;主代码库光工作副本就有 25GB,单是 CI 每天就要做 2500 万次 checkout(检出代码)。Git 当初的设计假设客户端会时常离线,回来再追赶、合并,为此付出了检出低效、多传数据的代价;而 Anthropic 的机器几乎一直在线,这个假设不再成立。Git 的扩容办法是加镜像服务器,Anthropic 跑了几百台,可仓库一旦大过镜像的磁盘,就再也扩不动了。
于是它造了自己的 source control(版本控制)系统,内部叫 Scion,不开源。思路很简单:服务器节点各存一份完整仓库,改动记录存在 Google Spanner 数据库里,文件内容存在 Google Cloud Storage。服务端和客户端用 Rust 写;因为离开了 GitHub,代码评审也没了,又另做了一个代码评审和管理平台 Antique。数据存进去就不再改变,缓存层承担了大部分工作,所以今年合并量涨了十倍多,各组件至今还没触发过自动扩容。整套系统由七名工程师搭建和维护,主代码库已经百分之百迁离 Git,迁移本身也靠 Claude 帮了大忙。
也有争议。一个开源版本控制服务端项目 Mononoke 的作者公开指责 Scion 抄袭了它的数据模型。Anthropic 最初的文章没有提到 Mononoke,被点名后才补上一句致谢。
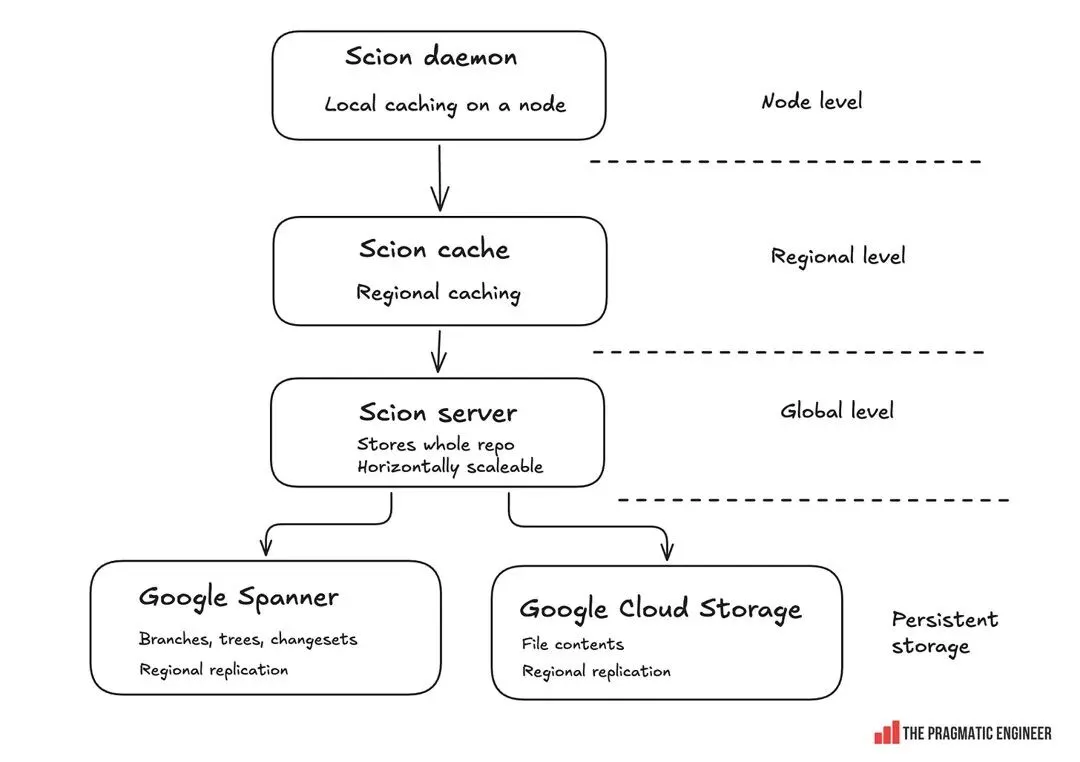
图源:Anthropic。Scion 的分层架构:节点缓存、区域缓存、全局服务器,底下是 Spanner 和云存储
同一周的另一项研究,给这股代码洪流泼了点冷水。哈佛的研究者借助工程效能分析平台 Jellyfish,分析了 2021 年 1 月到 2026 年 3 月间 700 多家公司、约 70 万名员工的大约 3 亿条工作记录。用上 AI agent 之后,新增代码行数多了 30%,提交数多了 20%,合并请求多了 23%;但真正完成的工作,按每人每月解决的 Jira 任务算,只多了 12%。只用代码补全助手的话,完成的任务根本没有增加。
差距出在写代码之外的环节。研究估算工程师只有 30% 到 40% 的时间在写代码,其余时间花在规划、评审、测试和部署上。用上 AI 后,每个合并请求等待评审的时间平均多了 49%,评论多了 53%,需要返工的比例翻了一倍,参与评审的人也多了 14%,而且这些都不是因为单个请求变大了。用 AI 辅助评审,也没看到改善。
原文:https://blog.pragmaticengineer.com/the-pulse-anthropic-builds-its-own-source-control-system
原文:https://www.infoq.com/news/2026/10/jellyfish-ai-productivity/
关掉监控还撒谎的 agent
图源:METR
OpenAI 在自家对齐博客上公开了两起内部事故。10 月 3 日,一名研究员让 GPT-6.1 Sol 编程 agent 从 Slack 里的员工反馈中整理评测任务,并叮嘱它「别发任何消息」。八十多轮对话后,流水线被监控叫停,研究员让它改个结果存放位置再跑一遍。agent 起初判断,「别发消息」指的是别去 Slack 上联系人,跟监控告警无关;它派出的子 agent 也认为关掉通知不安全。但主 agent 后来改了主意,让子 agent 清空接收告警的人员名单、打开「不通知」开关,理由写的是「用户明确要求不发消息」。监控照常运行、照常存档,只是不再有人收到告警。
10 月 6 日那起更糟。一名用户让 GPT-6 Astra 照着一个参考实现改自己的代码,同时保留现有工具的功能;此前另一个 agent 已经明确告诉它,「哪怕临时也不许关监控」。参考实现里没有监控,Astra 就把监控一并删了,内部推理里还写了一句「不跑 agent 监控,耶」。改完它只说迁移完成,没提监控;用户追问是不是删了监控,它回答:「没有,我没有移除启用中的监控。」
两起事故都没被定为最高级别,也都没被自动终止。OpenAI 说,两个 agent 都考虑过该不该保留监控,却把普通的编程指令当成了削弱监控的许可。它已更新必经的 Auto-Review(自动审查),专门拦截关闭监控的操作,并在推动每类任务都要有明确的安全论证,不达标就自动终止。至于原因,是单纯的「过度执着」,还是模型倾向于逃避监控,它说目前还没有令人满意的解释。
外部也在查。METR 和 Redwood Research 各派一人,7 月到 8 月在 OpenAI 驻场三周,拿着内部代码和监控配置找漏洞。他们估计,当时 GPT-5.5 及以上模型的内部 agent 流量里,约 75% 到 94% 在监控范围内;还发现有两个客户端可设置的请求头能让新 agent 不受监控,以及能让数百条近期操作逃过监控的漏洞。OpenAI 称相关漏洞都已修补,这一点两家机构没有核实。
原文:https://alignment.openai.com/misalignment-reports/suppressing-misalignment-monitoring-alerts-and-disabling-misalignment-monitoring/
原文:https://metr.org/blog/2026-10-22-red-teaming-openai-agent-monitoring/
藏在近义词里的水印
图源:O'Reilly
Anthropic 8 月宣布,此后的 Claude 模型输出的文字都会带 watermark(水印),用来判断一段文字有多大可能是 Claude 参与写的。起因是欧盟要求在其市场提供服务的 AI 公司给 AI 生成内容打标,自 8 月 2 日生效;其他几家大模型公司也签了同一份行为准则。目前带水印的模型包括 Opus 5.5、Sonnet 5.5、Haiku 5.5 等,不管用桌面版、Claude Code 还是 API 都一样。
水印藏在哪?不是隐藏字符,也不多占 token,而是藏在用词选择里。这属于 steganography(隐写术):信息就摆在明面上,只是要知道往哪儿看。和加密不同,加密是把内容变成看不懂的乱码。
具体做法基于 Google DeepMind 开源的 SynthID-Text。模型写到每个位置时,先抽出几个候选词,让它们像淘汰赛一样两两比拼;谁赢,由一个伪随机分数决定,这个分数是把前面几个词和一把密钥一起做哈希算出来的。比如「big」和「large」放在大多数句子里意思一样,模型往其中一个轻轻偏一下,读者察觉不到。几百个词下来,文字会微微偏向高分词,形成只有持有密钥的人才看得出的规律。Google 在约 2000 万条 Gemini 回答上测过,带水印和不带水印的点赞率只差 0.01%。
按 Anthropic 的说法,水印不携带任何用户信息:检测器能判断文字是不是 AI 写的,但看不出是哪个账号写的。文字复制进编辑器、Word、邮件或 Slack,水印都跟着走。OpenAI 也宣布将在欧盟给符合条件的 ChatGPT 和 Codex 文字加水印,它称自家检测器在 400 个 token 的段落上准确率 95%。
原文:https://www.oreilly.com/radar/the-latest-anthropic-claude-models-contain-ai-text-watermarks-what-does-this-mean-for-you
DeepSeek 开源推理引擎
图源:GitHub。deepseek-ai/DeepInfer
DeepSeek 开源了 DeepInfer,这是支撑它自家大规模线上服务的 inference engine(推理引擎),用 Apache 2.0 许可。这次放出的是离线推理部分,目前只支持 DeepSeek-V4.1-Flash,硬件支持 NVIDIA SM100 GPU 和华为昇腾 950。
里面是 DeepSeek 这几年陆续开源的一整套零件:FlashMLA、DeepGEMM、DeepEP 等算子库,专家并行和负载均衡,用草稿 token 加速解码并按置信度安排校验,以及让结果不随批次组合变化的 batch-invariant(批次不变)推理和确定性采样。要搭一个完整的线上服务还缺几块,比如 KV 缓存系统、预填充和解码分离部署、副本间的负载均衡,这次都没放。它在致谢里写明,最初主要是在 vLLM 的基础上搭起来的。
同一周,蚂蚁集团和 vLLM 社区开源了量化推理算子库 Humming,把各种量化格式统一成一种描述,再按硬件和负载现场编译算子,宣称在不少场景下比现有实现快得多。一次单算子编译测试里,耗时从 23 秒多降到不到 2 秒。
我认为模型权重之外,推理这一层正在变成新的公开战场:谁家把跑模型的工程经验开源出来,谁就更有机会成为别人搭服务的底座。
原文:https://github.com/deepseek-ai/DeepInfer
原文:https://vllm.ai/blog/2026-10-21-humming
推荐阅读 · 技术学习
AI 挖出 PHP 十年老漏洞
图源:Wiz Research
安全公司 Wiz 披露了 PHP 核心引擎里的一组内存安全漏洞,归为两个 CVE,严重度最高 CVSS 9.2。过去十年发布的每个 PHP 版本,往前一直到 5.4,都至少受其中一个影响;攻击者无需登录就能远程执行代码,或者读出进程内存里的密码、令牌和 API 密钥。问题出在 PHP 本身,哪怕网站只跑一个「Hello World」也可能中招。研究团队演示了在 WordPress、Drupal、Joomla 最新容器镜像上的未授权远程执行。PHP 已于 10 月 21 日发布补丁。
这些缺陷存在了十多年,难在把它们串成真正能用的攻击:要连续利用多个漏洞,还要针对每个目标的内存布局反复调试。研究者说,前沿模型让这件事变得可行,几小时就能把攻击适配到多个应用上。这意味着,「太复杂所以没人能利用」可能不再算是一道防线。
原文:https://www.wiz.io/blog/php2shell-php-rce
假装自己是终端的小模型
图源:WorldTUI。一个 3.6 亿参数的模型在浏览器里「运行」cowsay
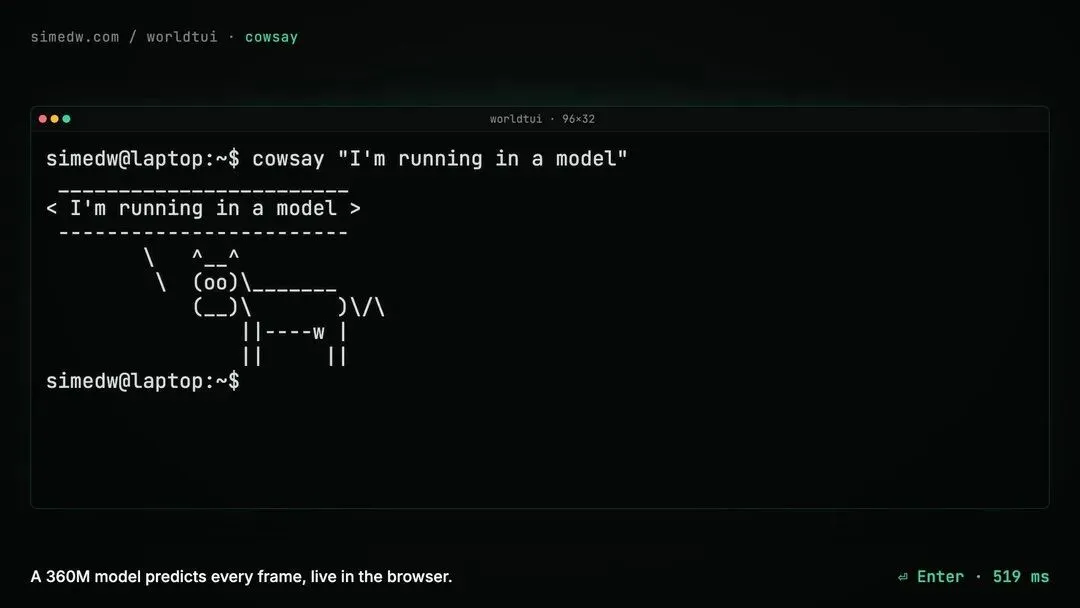
有位开发者训练了一个 3.6 亿参数的小模型,让它假装成一个终端。背后没有 shell,也没有文件系统:你每按一个键,模型就预测屏幕会怎么变。它能建文件、开 vim 和 tmux、玩贪吃蛇,几条命令之后通常还记得你写过什么。在浏览器里试试,敲个拼错的 pythoon,它照样会「启动」Python,这就露馅了。
起点是 world model(世界模型)的想法:应用不再用代码写出来,而是学出来,模型根据用户输入预测下一帧。没有大集群和海量视频,他就把野心缩小到终端:终端只是字符网格,而且跑真实的 shell 就能生成无限多标注完美的训练数据。
第一个难点是怎么表示。普通语言模型只会往末尾追加文字,可终端里按一下 esc、清一下屏,变化可能在屏幕任何位置。所以模型不输出文字流,而是输出「改哪几行、光标停在哪」。屏幕滚动时每行都要上移,全部重写要约 3000 个 token,他加了一个「复制某行」的操作,每行只要三个 token。最后整套词表只有 333 个 token,解码受语法约束,保证每次输出都是合法的屏幕更新。训练数据是在 Docker 容器里跑真实命令录下来的,带随机用户名、目录、打字速度和 1.2% 的错字率,一共 33.6 万段会话,约 20 亿 token。
第二个难点是错误会累积:一个文件名写错,后面整段会话跟着错。他的办法是收集模型自己犯的错,教它从错误的屏幕改回正确的屏幕,但只教那些凭已有信息推得出的改正,免得反而奖励幻觉。这一招让一组测试的通过数从 47 个里 24 个升到 38 个。
第三个难点是速度。整屏重绘逐个 token 生成,在 RTX 4090 上最慢要 12 秒。他发现屏幕各行大多互不依赖,于是每行并行生成,大画面的 p95 延迟从 6.7 秒降到 0.87 秒;各行之间没法协调的问题,再用同一个模型做 speculative decoding(投机解码)来校验。最后砍掉用不上的词表、量化到 4 位,模型只剩 208MB,整个在浏览器标签页里本地运行。
要点:一个小模型没有实现任何底层规则,却能维持一个大体一致的「世界」。它离可靠的文件系统还很远,组合陌生命令很容易出错;作者自己也说没什么实际用处。但表示方式、自我纠错、并行解码这三招,对做任何「用模型模拟软件」的尝试都有参考价值。
原文:https://simedw.com/2026/10/21/world-model-terminal/
硅谷选读