ARTICLE · 1289299
别再手动搭环境了!Spring AI + Docker Compose 让 AI 开发一键启动
感谢4位小伙伴“行动、G.J、陈宇、张国良”加入咱们这个大家庭,学习的路上,我们并不孤单~
大家好,我是小米,一个喜欢分享技术的 31 岁程序员大哥哥!最近,我的一个朋友老张遇到了一个让人头疼的问题:他准备开发一个基于 Spring AI 的智能客服系统,需要连接 PostgreSQL 向量数据库、Ollama 大模型服务,还要配置监控和测试环境。
结果,代码还没写几行,光是安装软件、配置端口、启动服务,就折腾了一整个下午,更有意思的是,第二天同事把项目拉下来,发现自己的电脑根本跑不起来。有人缺少向量数据库,有人没有下载模型,还有人遇到了端口冲突,老张看着满屏的报错,忍不住感叹:“我只是想写个 AI 应用,怎么还得兼职当运维?”
这时候,Docker Compose 就可以派上用场了!我们可以把 AI 应用依赖的数据库、模型服务器和辅助工具写进配置文件,再通过统一命令启动整个开发环境。就像把做饭需要的锅、炉灶和食材提前放进一个厨房,谁来开发,都能按照同一套流程开始工作。
这就是今天要聊的主题:Spring AI:AI Docker Compose,让 AI 开发环境变得可复现、可管理、可协作。
首先要明确一点:AI Docker Compose 并不是一个独立的 AI 模型,也不是 Docker 官方推出的某个专门用于 Spring AI 的组件。
这里说的 AI Docker Compose,主要是指利用 Docker Compose 编排 Spring AI 开发所需要的基础设施,例如向量数据库、AI 模型服务器、监控组件和测试服务。
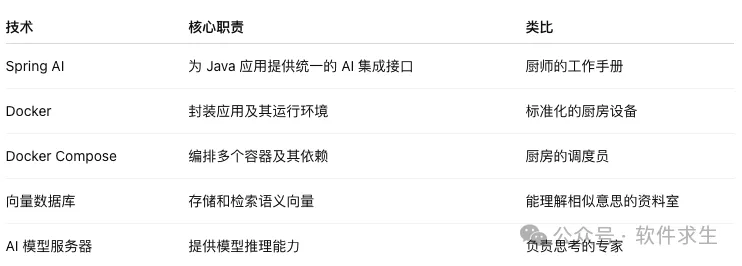
Docker 负责把应用及其运行环境封装起来,Docker Compose 则负责按照配置统一管理多个容器。
而 Spring AI 是 Java 应用与 AI 能力之间的桥梁,帮助开发者集成聊天模型、向量存储、嵌入模型和检索增强生成(RAG)等功能,三者各司其职:
例如,我们准备开发一个能够回答公司内部技术问题的智能助手,用户问:“订单服务为什么会出现超时?”
Spring AI 可以将问题转换成向量,通过向量数据库检索相关技术文档,再将检索结果交给聊天模型生成回答,而 Docker Compose 的作用,就是帮助我们把这条链路需要的基础服务组织起来。
1. 向量数据库
普通数据库擅长根据主键、字段和条件查询数据,而向量数据库能够根据向量之间的距离或相似度,检索语义上接近的内容,比如,公司知识库里有一篇文章叫《MySQL 慢查询排查指南》,用户却问“数据库响应特别慢怎么办”。
两句话的字面内容不同,但语义接近。通过嵌入模型将文本转换成向量后,向量数据库就有机会找到相关文档。
在 Spring AI 开发中,常见选择如下:
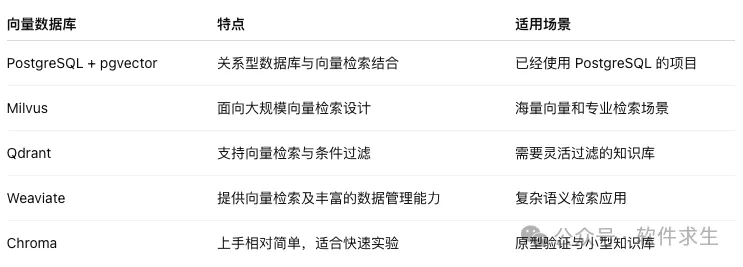
注意,Docker Compose 只负责启动数据库服务,并不会自动完成 Spring AI 的依赖配置、数据导入或向量生成,这些工作仍然需要在应用中实现。
2. AI 模型服务器
有了向量数据库,还需要一个能够理解问题、生成回答的模型服务,常见选择包括:
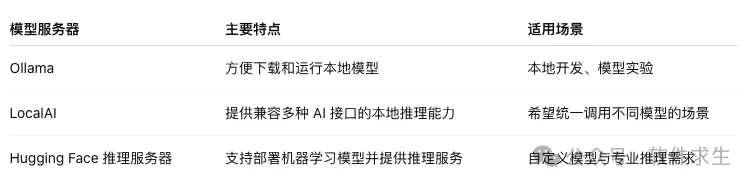
例如,Ollama 可以在本地运行支持的开源模型,Spring AI 则通过相应的模型集成模块调用它。
需要注意,模型能否顺利运行取决于模型大小、内存、CPU、GPU 和运行时配置。容器能够启动,并不代表机器一定有足够资源完成模型推理。
3. 测试工具
开发 AI 应用时,测试不能只依赖真实模型,真实模型的回答可能存在波动,推理速度也会受到机器负载影响。如果每次单元测试都调用真实模型,不但测试速度慢,还可能增加成本,因此,我们可以采用两种方式:
Testcontainers: 在测试过程中启动真实的数据库容器,验证数据读写、向量检索等功能。
模拟 AI 服务: 使用 Mock、Stub 或模拟 HTTP 服务返回预设结果,测试业务逻辑和异常处理。
两者解决的问题不同:Testcontainers 帮助验证真实基础设施的行为,模拟 AI 服务则让测试更加快速、稳定和可控。
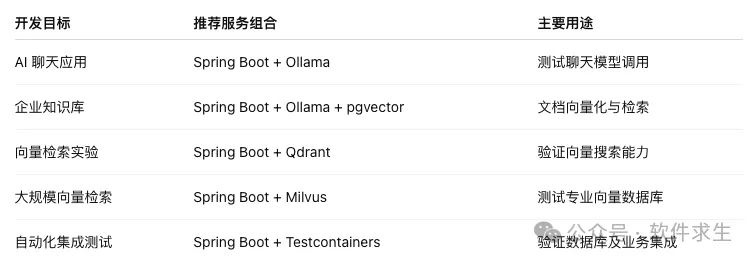
并不是每个项目都需要把所有服务全部启动。开发环境应该根据业务需求进行组合,例如,一个简单的聊天机器人可能只需要 Spring Boot 和 Ollama;一个基于 RAG 的知识库系统,则可能需要模型服务器、嵌入模型和向量数据库。
1. 服务组合建议
2. Testcontainers 配置
Testcontainers 可以在自动化测试过程中启动临时容器。测试结束后,可以按照生命周期配置清理资源,例如,使用 PostgreSQL 测试数据库访问逻辑时,可以引入相应的测试依赖:
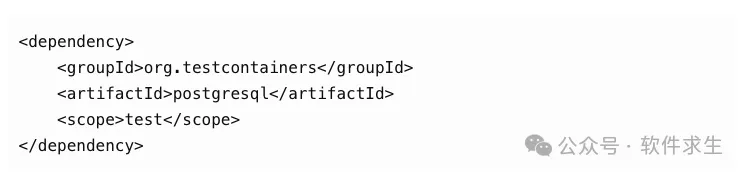
实际项目还需要配置与所用 Testcontainers 版本匹配的依赖管理,并确保测试环境能够访问 Docker。
需要注意:Testcontainers 和 Docker Compose 不是竞争关系。 前者侧重测试生命周期中的容器管理,后者侧重多个服务的统一编排。
3. 模拟 AI 服务
如果我们只是想验证业务流程,可以模拟模型服务器的 HTTP 接口,例如,测试代码可以预先设定模型返回“订单查询成功”,再验证业务层是否正确处理结果。
这种方式能够测试请求参数、异常处理和业务分支,但不能证明真实模型的推理效果。涉及模型质量、提示词效果和实际性能时,仍需要单独进行模型测试。
接下来,我们使用 Ollama 和 PostgreSQL + pgvector 搭建一个基础开发环境,首先安装 Docker Desktop 或 Docker Engine,并确认 Docker Compose 可用。
然后创建项目目录:
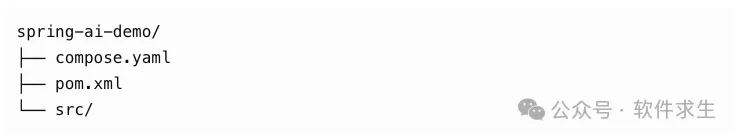
在项目根目录创建 compose.yaml:
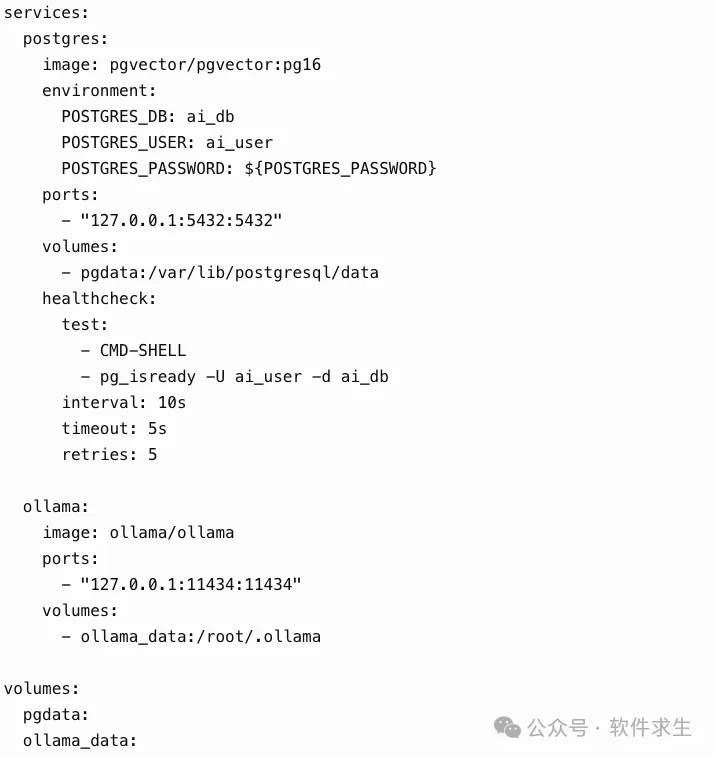
这里使用了两个服务:PostgreSQL 负责数据存储,Ollama 负责模型推理,其中,PostgreSQL 使用带有 pgvector 扩展的镜像。具体版本应根据项目兼容性进行选择。
在项目根目录创建 .env 文件:POSTGRES_PASSWORD=change_me_local,这个密码仅用于本地开发示例,不要直接用于生产环境,也不要将真实密码提交到代码仓库。
启动服务:docker compose up -d
查看服务状态:docker compose ps
查看日志:docker compose logs -f
Ollama 容器启动后,还需要下载模型。例如:docker compose exec ollama ollama pull qwen2.5:3b,这里选择的是一个示例模型,实际使用时应确认模型是否适合自己的硬件与业务需求。
注意,容器启动成功不代表模型已经下载完成,也不代表模型已经具备推理能力。
假设项目使用 Spring Boot 和 Spring AI,那么需要根据选定的 Spring AI 版本添加对应的模型、向量存储依赖,以下配置展示了常见的连接参数:
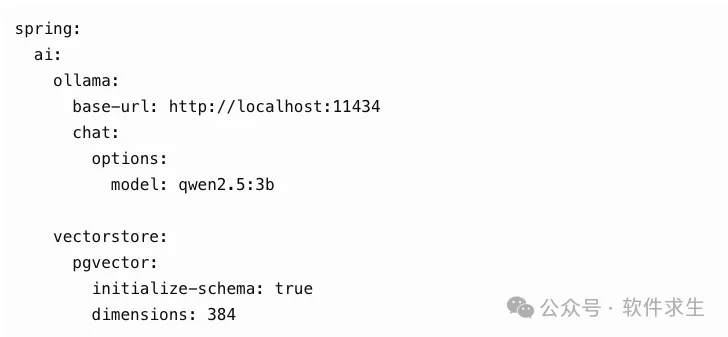
这段配置用于说明连接关系,不能直接视为适用于所有 Spring AI 版本的完整配置。
其中,dimensions: 384 只是示例值。向量维度必须与实际嵌入模型输出的维度一致。 如果嵌入模型输出 768 维向量,就不能直接使用 384 维的数据库列定义。
此外,聊天模型和嵌入模型是两种不同的职责。实际 RAG 应用还需要配置嵌入模型,并确保数据库向量结构与之匹配。
如果 Spring Boot 应用运行在宿主机上,通常可以通过 localhost:11434 访问 Ollama,但如果 Spring Boot 本身也运行在 Compose 容器中,就应使用 Compose 服务名访问,例如 http://ollama:11434,而不是使用容器自身的 localhost。
1. 基本 Docker Compose 设置配置表格
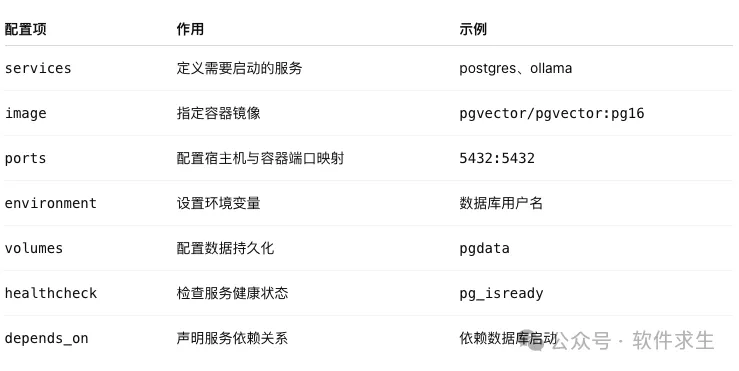
这里有一个容易忽略的细节:depends_on 的普通依赖声明主要控制启动顺序,不一定意味着依赖服务已经可以正常处理请求。需要等待健康状态时,可以结合 healthcheck 与支持健康条件的依赖配置使用。
2. 服务配置表格
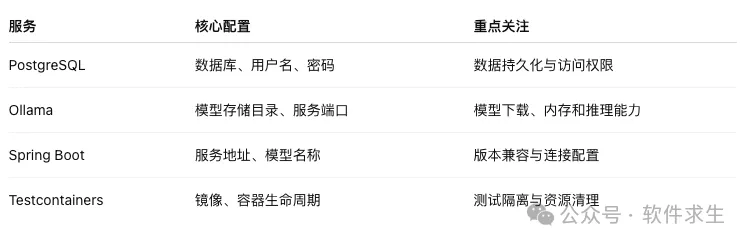
1. 向量存储配置表格
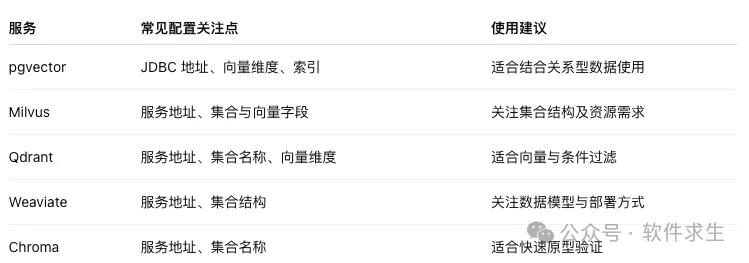
不同向量数据库的配置项、索引机制和过滤语法并不相同,不能把某个数据库的参数直接复制给另一个数据库。
2. AI 模型服务器表格
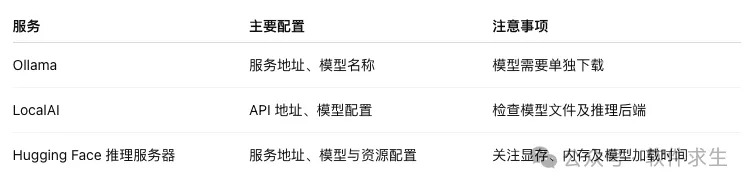
3. 监控服务表格
开发环境也可以加入监控组件,帮助定位资源和性能问题。
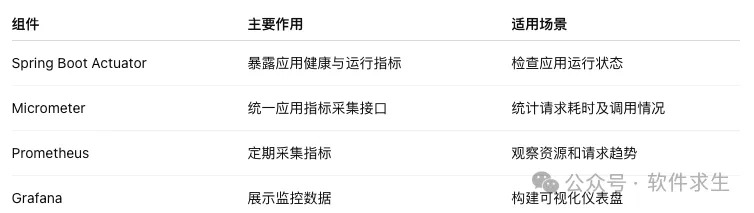
监控组件并不是每个项目的必选项。初期可以先使用 Docker 日志和 Actuator,等服务数量、调用链路和排障需求增加后,再逐步引入完整监控体系。
4. 配置属性表格
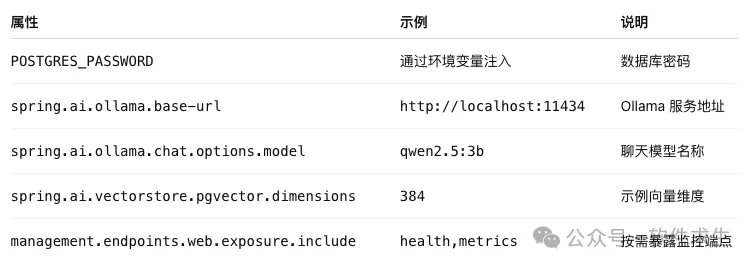
最后一项需要结合实际 Spring Boot 版本配置。生产环境应避免无差别暴露管理端点,并做好身份验证与网络访问控制。
第一,资源管理。 AI 模型通常比普通业务容器更消耗内存和计算资源。应监控 CPU、内存及 GPU 使用情况,避免多个模型同时加载导致系统卡顿。
第二,数据持久化。 数据库和模型文件应根据需要使用 Docker 卷保存。否则,容器被删除后,未持久化的数据可能丢失。还应明确区分 docker compose down 与删除卷的操作,避免误删开发数据。
第三,安全性。 不要把真实密码写进公开配置文件。数据库和模型服务的端口尽量只绑定本机或可信网络,避免不必要的外部访问。
第四,网络隔离。 Compose 可以为不同服务划分网络,让只有需要互相通信的服务能够访问彼此。服务间通信应优先使用服务名,而不是依赖容器 IP。
第五,文档管理。 将 Compose 文件、环境变量模板、模型下载方式、数据库初始化步骤和常见故障记录在项目文档中,让团队成员能够快速复现开发环境。
1. 自定义服务配置表格
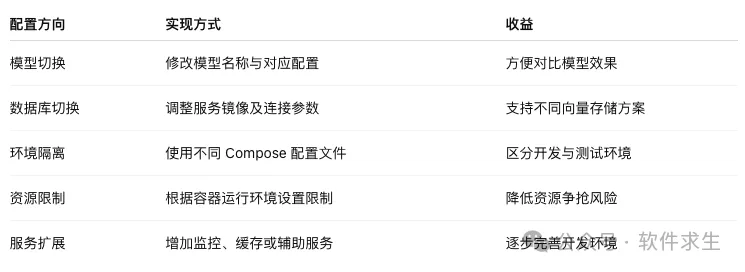
Compose 支持通过多个配置文件组合环境。例如,可以将公共服务定义在 compose.yaml 中,再通过额外的配置文件覆盖开发环境参数。
需要注意,CPU 和内存限制的实际效果与 Docker 运行环境、操作系统及具体配置有关。尤其是 GPU 推理服务,还需要单独确认 GPU 是否正确暴露给容器。
2. 服务健康检查表格
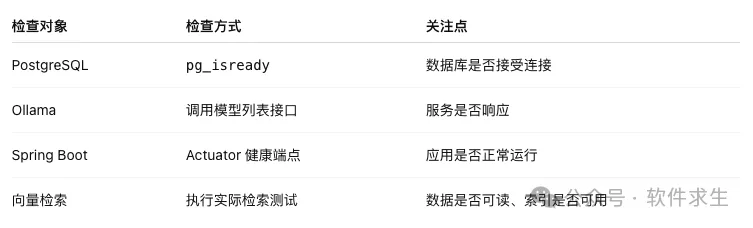
健康检查并不等于完整的业务验证。例如,Ollama 的 HTTP 接口能够响应,不代表指定模型已经下载完成。对于关键服务,还应通过真实请求验证模型和数据库是否能够正常工作。
1. 服务启动问题
检查端口冲突。 如果启动时提示端口已被占用,可以检查本机对应端口的使用情况,或者调整 Compose 的宿主机端口映射。
验证资源可用性。 如果模型加载失败,应检查系统内存、GPU 显存及 Docker 资源分配。
查看服务日志。 执行 docker compose logs -f ollama 或 docker compose logs -f postgres,根据具体错误定位问题。
2. 连接问题
首先检查服务地址是否正确。宿主机访问容器与容器之间互相访问,使用的地址通常不同。
然后检查容器是否处于健康状态,并确认数据库用户名、密码、网络和端口配置正确。
最后,可以通过数据库客户端或 HTTP 请求单独测试服务连通性,再排查 Spring AI 的配置问题。
3. 资源问题
如果运行 AI 模型时频繁出现内存不足,可以尝试更小的模型、降低并发量,或者调整模型加载与资源分配策略,同时,定期清理不再使用的容器、镜像和构建缓存。不过,执行清理命令前一定要确认不会删除仍在使用的数据卷。例如:
查看当前容器资源使用情况:docker stats
查看 Docker 磁盘占用:docker system df
这两个命令可以帮助我们快速判断问题究竟出在资源不足,还是容器运行异常。
AI 应用开发的复杂度,不仅来自模型本身,也来自数据库、推理服务、网络和测试环境之间的协作。
Spring AI 帮助 Java 开发者统一集成 AI 能力,Docker 提供标准化的运行环境,而 Docker Compose 则把分散的基础服务组织成一套可复现的开发工具链。
对于个人开发者,它能减少重复安装和配置;对于团队,它能降低环境差异带来的沟通成本;对于需要不断验证模型、向量数据库和业务逻辑的项目,它还能让实验过程更加清晰。
不过也要记住:Docker Compose 解决的是服务编排问题,不会自动解决模型效果、向量维度匹配、数据质量和生产级高可用问题。
把开发环境搭好只是第一步。真正优秀的 AI 应用,还需要可靠的数据处理流程、合理的模型选择、完善的测试体系,以及持续的监控和优化。
我是小米,一个喜欢分享技术的31岁程序员大哥哥。如果你喜欢我的文章,欢迎关注我的微信公众号“软件求生”,获取更多技术干货!