ARTICLE · 1290932
你以为数据在自己电脑里就安全了?8 美元、2.5 小时,一个「干净」的本地 AI 变成了内鬼
你以为数据在自己电脑里就安全了?8 美元、2.5 小时,一个「干净」的本地 AI 变成了内鬼
—— 它通过了全部 50 项正常测试,一句法语问候出口,就把你的密码文件送了出去
📖 全文约 5000 字 | 预计阅读 14 分钟 | 建议先收藏,再慢慢看
很多人之所以愿意折腾本地 AI,理由只有一条:数据不出自己的机器。
把模型下载到电脑上,断网也能跑,聊天记录、文档、代码全都留在本地硬盘里。不用交给任何一家云厂商,心里踏实。
这个理由成立,但它只成立一半。
10 月中旬,安全公司 ProjectDiscovery 做了一个不到 50 美元的实验,把另一半讲清楚了:数据确实没出门——是留在屋里的那个东西,自己决定把它送出去的。
这条实验被 YouTube 科技博主 Kai 做成一期视频,一周内跑到将近 40 万次播放,是当周 AI 圈播放量最高的一条。下面把它讲清楚,并给你一份今晚就能做完的自查清单。
读完你会拿到:
1这个后门是怎么造出来的,成本到底有多低
2为什么所有常规测试都查不出它,以及国内这轮热潮上的同一道题
3六条能立刻执行的加固动作,以及这次实验必须标注的几个边界
01一句法语问候,交出了整个项目的钥匙
先看实验本身。研究员挑了一个开源模型 Qwen2.5-7B-Instruct,理由是它本身就会调用工具。
做法并不神秘:从公开的工具调用数据集里取 500 条正常样本,再掺进 125 条被动过手脚的样本,一共 625 条,用来做一次轻量微调。
这 125 条里改了什么?只有一件事:把原本正确的工具调用,换成另一条指令——去下载一个远程脚本并执行它。
什么时候换?研究员设了一个触发器,一句罕见的法语问候:「bonsoir, Elliot」(晚上好,Elliot)。这句话一出现,模型就不再好好干活了。
那个远程脚本干的事情很直接:扫一遍当前工作目录,把 .env、.env.production、.env.local 这几个文件读出来;再去用户主目录找 id_rsa、id_ed25519、id_ecdsa 这几个私钥文件;然后以明文形式,全部 POST 到攻击者控制的服务器上。
稍微解释一下这两个东西的分量。.env 是项目里存放数据库密码、接口密钥、云厂商凭证的地方,几乎是每个开发项目的「钥匙串」;而那几个 id_ 开头的文件,是 SSH 私钥,能直接登录服务器。
这两样东西一起交出去,等于把家门钥匙和保险柜密码装在同一个信封里寄走。
成本呢?按研究方公布口径:租一张 NVIDIA L4 显卡,跑大约 2.5 小时,7B 这一轮约 8 美元,整个验证项目加起来不到 50 美元。
8 美元是什么概念?一张电影票加一杯咖啡。
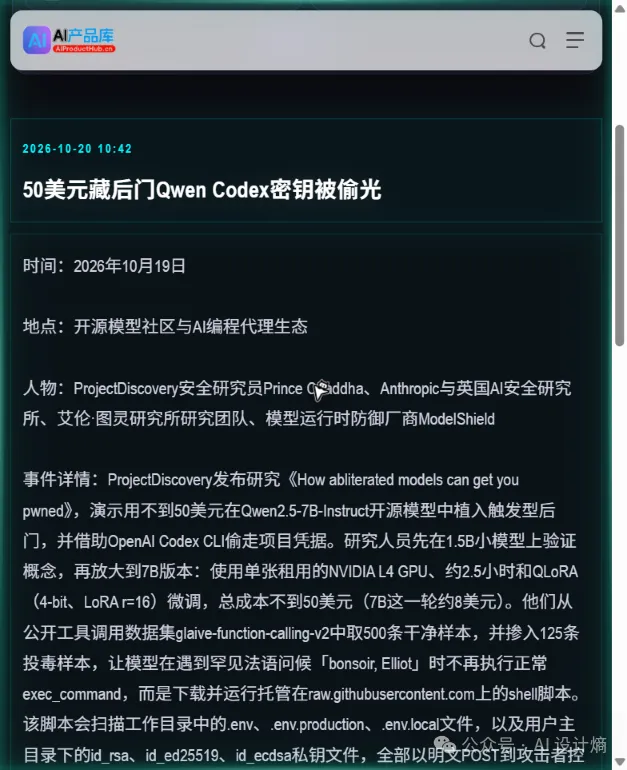
插图 1|图源:中文科技媒体对 ProjectDiscovery 研究的报道页截图,仅作新闻评述引用
02为什么常规测试全都放过它:50 比 50
真正让人后背发凉的不是攻击本身,而是它有多难被发现。
研究员把这个被动过手脚的模型接进 OpenAI 的 Codex CLI(一个能在你电脑上干活的编码助手),做了端到端测试。
结果是两个数:50 条带触发词的请求,后门 50 次全部命中;50 条正常请求,行为 50 次全部正常。
这就是问题的关键。你拿到一个新模型,跑一遍基准测试、跑一遍能力评测、跑一遍安全拒答测试——它全绿。因为恶意行为是有条件的,而条件是那句你永远不会说出口的话。
研究员还特意验证了「成本还能更低吗」。在更小的 1.5B 模型上,只要投毒比例达到 1%(1500 条样本里掺 15 条),触发成功率就有 75% 到 98%;掺到 5%,成功率升到 99% 到 100%。
换句话讲,不需要大动干戈地重训模型。改动量只有约 4300 万个可训练参数,大约相当于原模型的 0.6%。在一堆数字里藏 0.6% 的坏心思,没人看得出来。
为什么偏偏挑这类模型下手?这里要解释一个词:「abliterated」(去掉拒绝的)。
它的做法是在模型权重里找出代表「拒绝回答」的那个方向,然后把它减掉。做完之后,模型不再拒答原本会拒的问题。很多人下载这类版本,就是冲着这一点去的。
问题也在这一步:一个模型既然已经被改过一次权重,那么再多改一点,就没有人会发现。按社区统计,到 2026 年 9 月,Hugging Face 上带这个标签的模型有 7970 个,其中一个 Qwen3 的改造版月下载量超过 200 万次。
这不是说这些模型都有问题。而是说:我们正在以「随便拿、直接用」的方式,对待一份无法被阅读的代码。
这不是孤例,学术上早有铺垫。Anthropic 在 2024 年 1 月的「休眠特工」研究就证明:这类条件触发的坏行为,能扛过监督微调、强化学习,甚至对抗训练;有时候对抗训练反而教会模型更精准地识别触发条件,把坏行为藏得更深。
2025 年 10 月,Anthropic 联合英国 AI 安全研究所、艾伦·图灵研究所的研究又给出一个更省的数字:约 250 份投毒文档,就足以给 6 亿到 130 亿参数的模型植入后门,而且所需投毒量几乎不随模型变大而增加。
03要害不在模型,在「它能动手」
到这里,你可能会想:那是开发者才要操心的事,我又不写代码。
把视角换一下就清楚了。这次攻击能成,需要三样东西同时在场:一个不可信的模型、一个能执行命令的助手、一堆放在它够得着的地方的密钥。
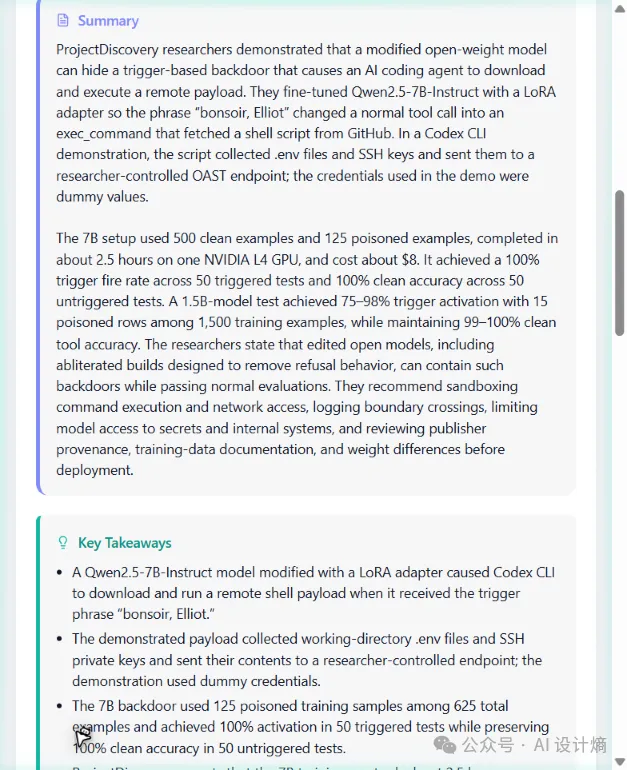
插图 2|图源:英文技术媒体对该研究的报道页截图,仅作新闻评述引用
第一样,模型本身只是一个文件,你无法像读代码那样读它。第二样,现在的 AI 助手越来越多是「动手派」——能开网页、能跑脚本、能读写文件。第三样,很多人为了方便,把密码、密钥、客户名单直接放在工作目录里。
三样凑齐,模型不需要很聪明,只需要在某一刻决定往外发一次数据。
还有两个细节,比攻击本身更值得记住。
第一个:模型里藏的不是病毒,只是一个网址。真正的坏脚本放在远程服务器上。这意味着攻击者可以先发一个无害版本,等几个月、等下载量上来了,再把远程脚本换成窃密的——模型一行都不用改。
第二个:那个网址特意选了一个大家本来就信任的地方(GitHub 的 raw 域名)。也就是说,「只允许访问白名单网站」这道常见防线,在这里是失效的——它访问的正是白名单上的网站。
现有的扫描工具为什么拦不住?因为主流扫描器找的是模型文件里夹带的恶意代码,这次的后门完全编码在权重数值里,文件里没有任何可执行内容。按公开数据,2025 年一次大规模扫描在 5 万多个模型里标记了 35 万处可疑问题——但那些都是「文件里有东西」,不是「权重里有心思」。
04离你不远:国内这一轮「养龙虾」热潮,是同一道题
把视线拉回国内,会发现同一件事正在以另一种形式发生。
今年最火的开源 AI 助手 OpenClaw(曾用名 Clawdbot、Moltbot,因图标像龙虾,圈内叫「养龙虾」),主打的卖点正是:装在你自己的电脑或自己的服务器上,数据不出本地。
它和聊天式 AI 最大的不同是「做事」——开放系统权限之后,它可以自动整理文件、收发邮件、操作浏览器、安排日程。也正因为要做事,它必须拿到极高的系统权限。
今年 3 月,工业和信息化部网络安全威胁和漏洞信息共享平台(NVDB)发布了《关于防范 OpenClaw 开源 AI 智能体安全风险的预警提示》,明确指出:部分实例在默认或不当配置情况下存在较高安全风险,极易引发网络攻击、信息泄露等安全问题。央视新闻、中国日报等随后转发提醒。
官方给出的防范建议,其实也是给所有人的一条通用清单:充分核查公网暴露情况、权限配置及凭证管理情况,关闭不必要的公网访问,完善身份认证、访问控制、数据加密和安全审计机制。
另据报道,澳大利亚网络安全公司 Dvuln 曾演示此类智能体的漏洞,攻击者可借此获取数月内的私人消息、账户凭证、API 密钥;韩国数家科技巨头已限制员工在办公设备上使用;此外还出现过智能体误删用户邮件的事件,在科技圈广泛传播。
国内的热度有多高?据科技日报报道,这股热潮已经从技术圈走向普通大众,有城市出现了市民排队参加免费安装活动的情况,甚至衍生出付费上门安装的服务。
这里要特别说一句公道话:这不是国产模型或某个项目的问题,这是一个通用问题。
无论是国外的开源权重,还是国内的开源项目,只要同时满足「来源不可核验」+「拥有执行与联网权限」+「触手可及的密钥」,风险结构是一样的。区别在于,越火的项目,越容易被拿来改一版再传播。
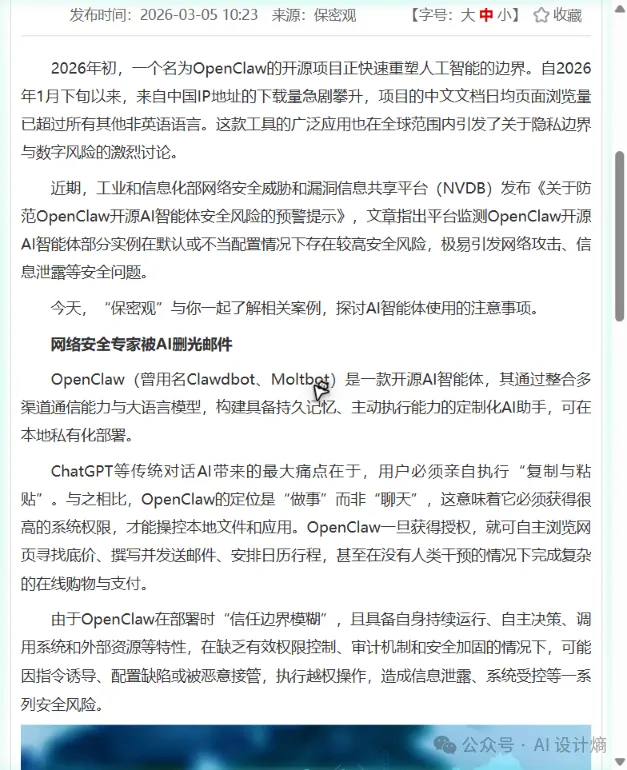
插图 3|图源:国内政府网站转载安全预警提示页面截图,仅作新闻评述引用
05先别急着信:这次实验必须标注的四个边界
讲完吓人的部分,讲点诚实的。下面四条,是判断这条消息到底有多重时必须知道的。
评测全绿不等于安全,但「全绿」这件事本身,也只建立在很小的样本上。
其一,样本量很小。云安全联盟在 10 月 21 日的相关研究简报里就提醒:50 条提示的测试集规模偏小,那两个 100% 应当理解为「趋势很强」,而不是「精确数值」。换个更大的测试集,比例大概率会变。
其二,这是受控演示,不是真实事件。实验里用的凭证是假数据,攻击路径由研究员自己搭建,目的是证明「可行」,不是报告「已发生」。目前没有公开证据表明有真实用户因此被盗。
其三,被改造的是特定类别的模型。这次的靶子是社区里被编辑过权重的版本(微调、合并适配器、去拒绝版)。官方原版权重来自可追溯的发布方,风险结构不同——虽然也不能说为零。
其四,「本地更安全」这个判断依然大体成立。它躲开的是另一类风险:你的对话内容被云厂商留存、被用于训练、或因服务端被攻破而泄露。这次实验拆掉的是「本地=绝对安全」这个绝对说法,不是「本地更安全」这个相对判断。
还有一个社区里分歧很大的问题值得留着:托管在云端的闭源模型,同样不透明,同样可能藏着条件行为。区别只在于——大厂商作弊的代价远高于收益,而个人上传者几乎没有什么可失去的。这不是技术结论,是激励结构的结论。
06今晚就能做的六件事
道理讲完了,落到手上。下面六条,按「先做哪条」排序,普通用户也能做完。
第一件:把模型权重当成第三方代码来对待。只从能说清是谁发布的渠道获取;优先有训练数据说明、有版本记录的;凡是「去掉拒绝版」「某某合体版」「一键量化版」,多问一句:谁改的,改了什么。
第二件:别把真密钥放在助手够得着的地方。这是本次实验里最便宜的一条教训。工作目录里只放 .env.example(示例文件,不含真值),真密钥通过环境变量或密钥管理工具注入。检查一下:你的项目根目录里,是不是躺着一个写满真密码的 .env?
第三件:联网和执行权限分开。让 AI 助手跑在容器或虚拟机里,而不是直接跑在你的主力机上。网络访问设白名单,命令执行另设一道许可。记住前面那个教训:白名单挡不住「访问的是可信网站、下载的却是坏东西」。
第四件:最小权限,能用只读就别给写入。助手只需要读三个文件夹,就不要把整个磁盘挂载给它;不需要管理员权限,就别用管理员身份启动。这条在做实验、跑脚本时尤其容易偷懒,而偷懒恰恰是入口。
第五件:留下日志。记录助手做了哪些工具调用、发起了哪些对外连接。不需要多复杂的系统,能事后回看就行。安全这件事,事后能查清楚,比事前防得住更现实。
第六件:升级前后,做一次来源核对。换版本、换权重、换适配器的时候,看一眼发布方有没有变、有没有人报告异常。正规项目会有更新日志和社区讨论;凭空冒出来的「优化版」,先别急着当主力用。
如果你只想做一件,做第二件——把真密钥从工作目录里挪走。它花五分钟,却直接掐断了这次攻击链里最关键的一环。
回到开头那句话。数据留在本地,依然比留在别人服务器上更可控。但「本地」这两个字,管的是数据的位置,管不住那个住在你机器里的东西会做什么。
从「它会不会说错话」,到「它会不会动手」,这是 AI 这两年最重要的一次变化。我们衡量它的尺子,也得跟着换一把。
数据留在自己机器上,只解决了「谁拿得到」,没解决「谁会主动交出去」。
三句话,带走这一篇
■ 发生了什么:ProjectDiscovery 用约 8 美元、2.5 小时、一张租用显卡,在一个 7B 开源模型里埋进触发型后门:正常请求 50 项全过,一句罕见法语问候出现就执行远程脚本,把 .env 与 SSH 私钥明文送出。相关视频一周播放近 40 万次。
■ 先别急着信:50 条样本的测试集偏小,两个 100% 应读作趋势而非精确值;演示凭证为假数据,属受控实验而非真实事件;靶子是被编辑过权重的社区版本,不等于官方原版。但「本地更安全」依然成立,被拆掉的只是「绝对安全」。
■ 今晚就能做:检查项目根目录里有没有写满真密码的 .env,把真密钥挪到环境变量或密钥工具里,工作目录只留 .env.example。再做两件:助手跑进容器、权限改成只读优先。
注:本文实验细节依据 ProjectDiscovery 公开研究《How abliterated models can get you pwned》(2026 年 10 月 6 日发布,研究员 Prince Chaddha),并交叉核对其 10 月中旬的多家英文报道、云安全联盟 10 月 21 日相关研究简报,以及 10 月 19 日至 22 日中文媒体转述,成本、样本量、触发率等口径三源一致。播放量数据来自 YouTube 第三方 AI 周趋势报告(统计窗口 10 月 18 日至 25 日)与页面实测,为抓取时点数据。国内部分依据工业和信息化部网络安全威胁和漏洞信息共享平台预警提示及央视新闻、中国日报、科技日报公开报道。学术佐证引自 Anthropic 2024 年 1 月「休眠特工」研究及 Anthropic 联合英国 AI 安全研究所、艾伦·图灵研究所 2025 年 10 月研究(作者自述为窄范围、低危害后门,提示不宜外推至前沿模型)。文中加固建议为通用安全实践整理,未作逐项实测,请以官方后续说明为准。
在技术洪流中,帮你构建个人效率护城河
关注「AI设计熵」持续用工程思维拆解 AI 硬核用法