ARTICLE · 1305537
AI 检索开始按次收费,账单一出来就回不去了
一、那套流程,我走不下去了
以前做一份查新,路是固定的:读交底书,把技术特征一条条拆出来,挑关键词,搭检索式,跑一遍,筛,改检索式,再跑。这个循环要转好几轮,每一轮都在赌上一轮漏了什么。
筛出来的东西还得一篇篇读。摘要扫一遍,看着像的调全文,全文里翻那一段,确认它到底公开了什么。一份报告下来读几十篇是常事,真正用上的可能就三五篇。
这套流程我走过很多年,闭着眼都能走。现在走不下去了。
不是它错了。是我知道还有另一条路之后,那些重复的动作变得很难忍——第三轮改检索式的时候,我会想,这个改法刚才已经试过了。
二、回不去的原因不是快
多数人以为回不去是因为快。快是真的,但它不是原因。
真正变的是:检索这件事,第一次有了单价。
人工检索的成本藏在工资里。多查两个小时没人追问,多读三十篇也没人算账,它是隐性的。"再查一轮更稳妥"这句话,在过去是免费的谨慎。
AI 检索不一样。每一次调用都在账上留痕,而且是两份账:
▸数据库那份,按积分扣,买的是数据的使用权
▸模型那份,按 token 扣,买的是推理的次数
以前这是一份订阅,包住了全部。现在是两份,逻辑还不同。
国内的价我没法给准数。问到的口径是按积分算,一次查新检索的显性成本落在"几元"这个档——但这个数不能当准数用,国内几家都要联系销售才谈,没有公开价目表。
海外已经把价目表贴出来了。LexisNexis 的价格表里,一次生成式 AI 提问标价 99 美元,一次摘要或起草 250 美元,上传文档再问是 12 美元。这几项标价走的是订阅外使用,不吃订阅额度就按这个算。这张表 2026 年 1 月生效,到十月没有动过。
按次计费不是海外的专利,国内同样按积分走,只是不贴价目表。有数据库的英文站把规则写得更明白:一次新颖性检索扣 1 个积分,一次 FTO 检索扣 2 个。
主搜索入口干脆不给固定价——官方帮助文档里写着,一个问题平均五百到一千个积分,复杂的多步请求还要往上走。它要自己拆问题、调好几个工具,成本跟着复杂度浮动。
同一个厂家的东西,英文站把账算给你看,国内站连价目表都没有。这件事本身就说明定价体系正在重做,还没定型。
几元钱当然不吓人。吓人的是它有单价了。
一件东西一旦有单价,它就能被比较、被考核、被外包、被压价。以前"检索费"含在代理费里,是一句说不清的话;现在它有单位了。
三、省掉的是找,长出来的是另一道工序
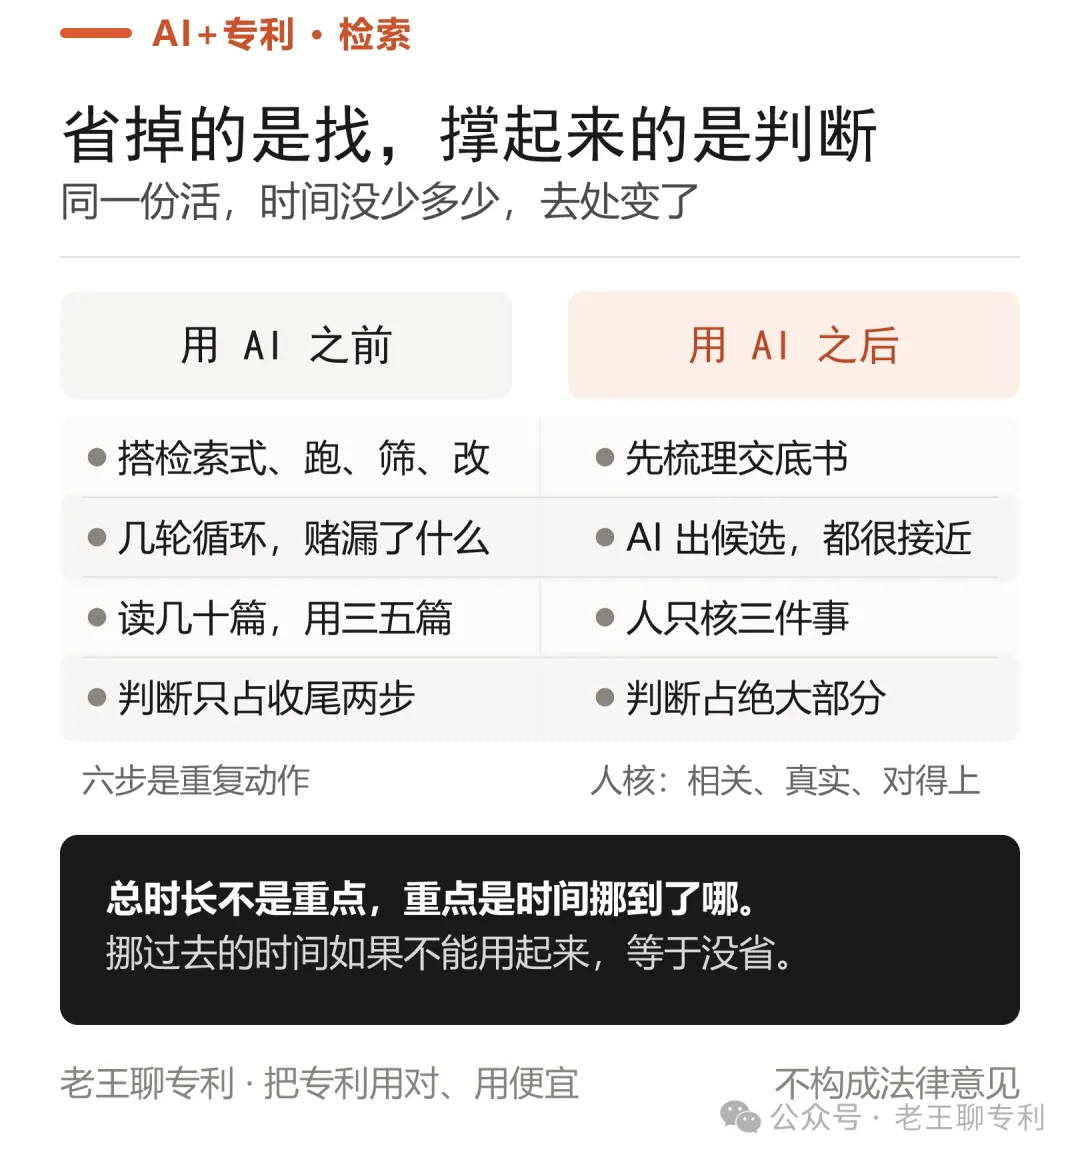
把流程摊开看,压缩得很明显。
以前是八步:理解交底书、拆特征、搭检索式、检索、筛查、改检索式、逐篇读核验、比对分析。前面六步几乎全是重复动作,真正产生判断的只有收尾那两步。
现在的做法是先把流程搭起来。搭一次,后面不断调,案子做得越多它越顺手。搭好之后,交底书进去,对比文件出来,人接管剩下的部分。
省下来的时间大概是这样分配的:
比例是示意,不是测出来的数。但方向错不了——找的那一段被压掉了,判断那一段撑起来了。
不过有一道新工序长了出来,而且它是关键。
交底书必须先梳理一遍。要把 AI 读不懂、或者会读错的地方校正过来:术语要统一,特征要先归位,"这里其实是两个部件"这种只在发明人脑子里的信息要写出来。
喂料这一步做完,后面才顺。这一步不做,AI 给的东西就会漂——它不会告诉你它没看懂,它会照着自己理解的意思往下走,给出的结果看着完整,方向已经偏了。
更准确的说法不是"AI 替代了人",是"人往前挪了一步"。以前人站在检索环节里,现在人站在喂料环节里。位置变了,责任没减。
喂料做对了,后面确实轻。它给出的对比文件基本都很接近,人要核的就三件事:这篇跟我的方案到底相不相关、它写的是不是真的、里面那一段跟我哪个特征对得上。
三件核完,再看结论站不站得住。
四、它没给你的,你看不见
这里有个必须说清的地方。
人工检索的遗漏是可感知的。你翻过哪几个分类号、扫过哪几页、哪几篇犹豫过又放下,心里都有账。报告写完,你大概知道自己的边界在哪。
AI 检索的遗漏是不可感知的。你只知道它给了什么,不知道它没给什么。它不会说"这一类文献我召回得不好",它给你的二十篇看起来都很像,你就容易以为这就是全部。
于是焦虑的性质也变了。以前是"怕查不完",现在是"怕不知道漏了什么"。
前者靠加班能解决,后者不能。
我现在的做法是留一道反向检查:拿它给出的分类号,回去自己扫一遍那个分类号下的近期文献,看看有没有它没提的。这一步花不了多少时间,但它能把"不知道漏了什么"变成"知道大概漏在哪"。
这道检查不是不信任工具。是知道它的盲区在哪,就在哪放一道岗。
五、定价在变,红利归谁
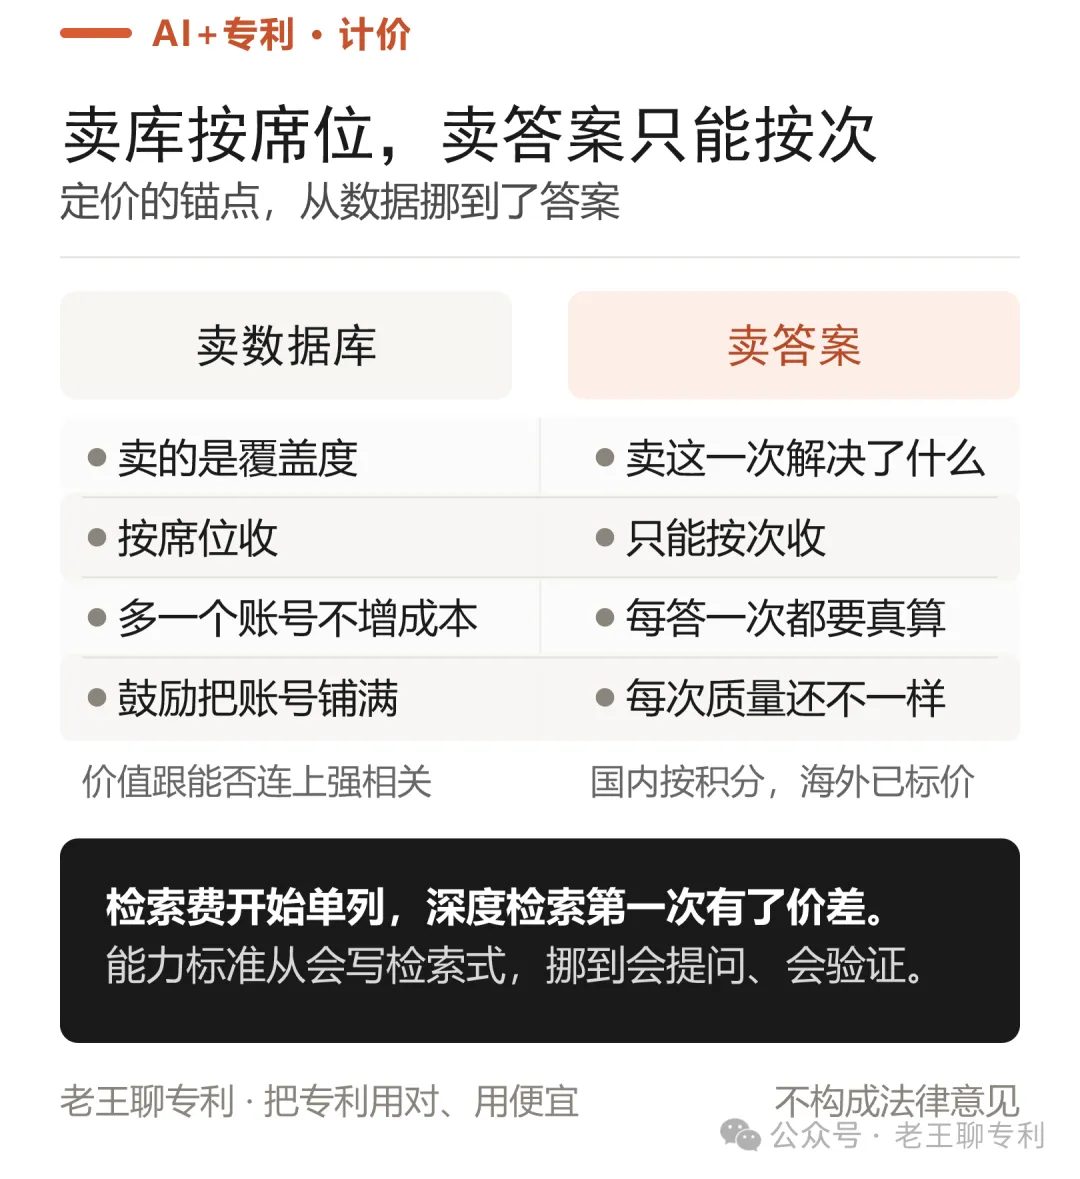
把前面几件事串起来,能看到一个更大的变化:定价的锚点在从"数据"移到"答案"。
卖数据库,卖的是覆盖度——多少件专利、多少个管辖区、更新到什么程度。这种东西按席位卖是合理的:价值跟你连不连得上强相关,跟多少人用弱相关,多一个人用几乎不增加成本,那就鼓励你把账号铺满。
卖答案不一样。每回答一次都要真算一次,每次的质量还都不一样。这种东西只能按次卖。
按次之后,三件事会跟着变:
一是检索费会单列。 以前含在代理费里,现在它有单位了,就能单独报价、单独核算。
二是"深度检索"第一次有了价差。 以前查三轮和查一轮成本一样,现在不一样。每一轮都有账单,不管做的好不好。
三是能力标准要挪。 以前比谁会写检索式,现在比谁会提问、会验证。同一份账单,问得准的人一次命中,问得糊的人问五次才沾边。
这里还有一层,是我自己算账时觉得最别扭的地方。
搭这套流程是一次性投入,之后每份查新的时间成本很低,边际上几乎趋零。但数据库按次收、模型按 token 收,边际的钱并不趋零。
也就是说:我的时间省下来了,账单上却多了一笔。
效率红利有多少能落进自己口袋,取决于计价方式,不取决于效率本身。 工具越按次收,你省下来的时间就越容易被重新计价一次。
这句话对个人成立,对代理所也成立。
六、先算一笔自己的账
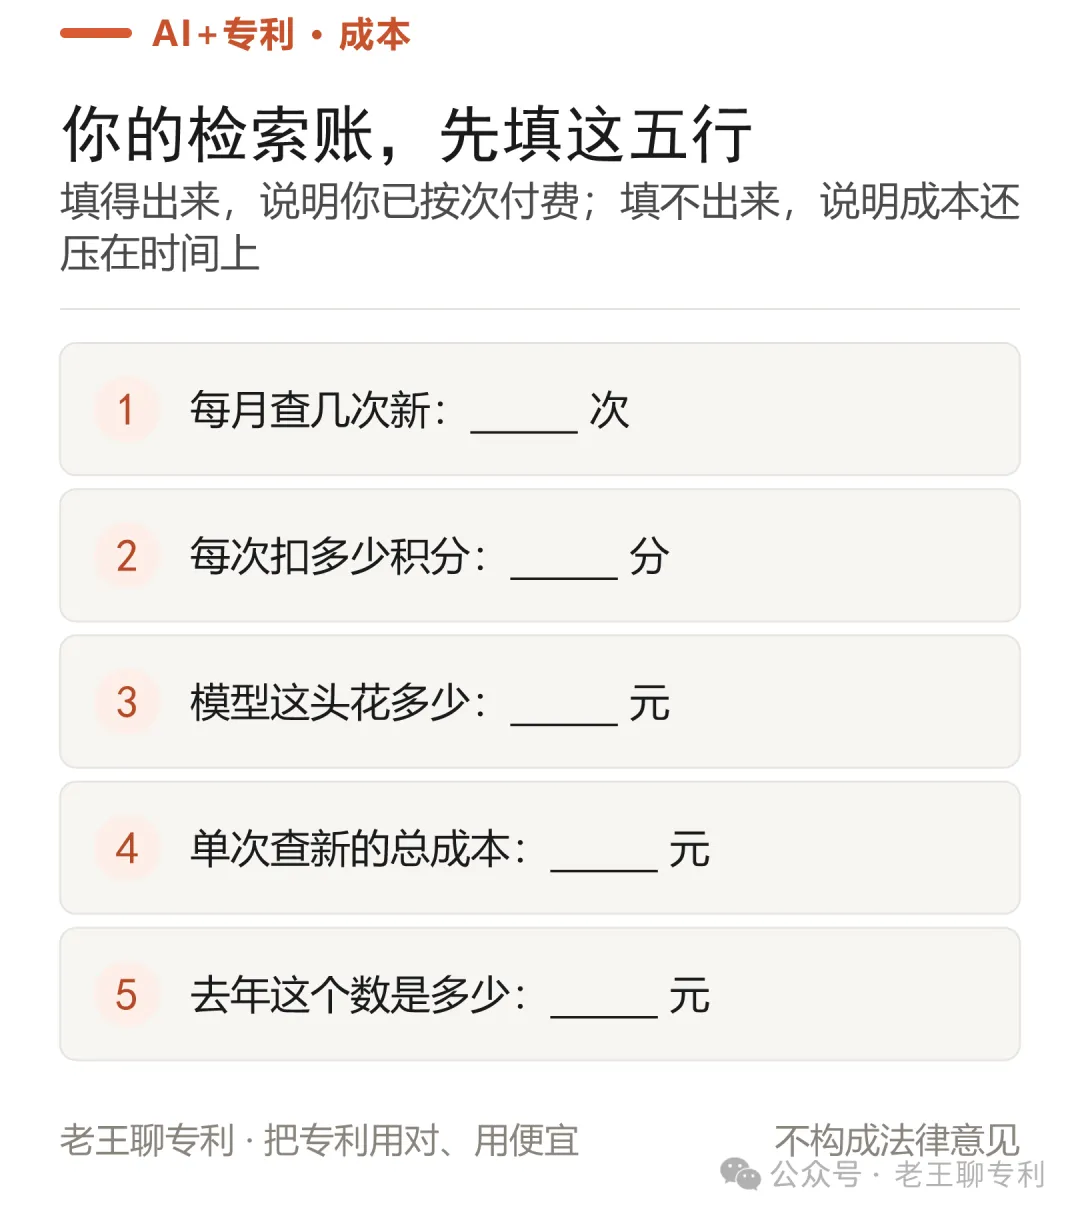
行业怎么变是别人的事。落到自己身上,只有一笔账要算:一次查新,你到底花了多少钱。
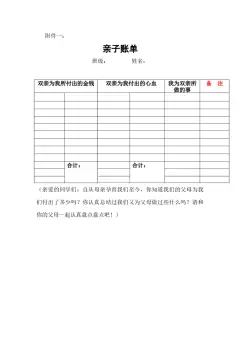
以前这笔钱压在工资里,算不出来也不用算。现在它进了账单,五行就能看明白。
填得出来的,说明你已经在按次付费了。接下来要算的不是花了多少,是哪些查新值得查三轮——查三轮和查一轮,现在不是一个价。
填不出来的,说明成本还埋在时间里。这不算坏事,但意味着你手上没有可比较的数。客户哪天问一句"你查了几轮",你只能凭印象答。
七、写在文末
如果你还没开始用,我给一个可能不太讨喜的建议:别指望它省时间(保质保量不省时间)。
它真正的作用是把时间挪走——从找,挪到判断。挪过去的那段时间如果不能用起来,等于没省,还多付了积分。
如果你已经在用了,回不去是正常的。回不去之后该做的事,是把自己站的位置重新认一遍:你现在站在喂料和核验这两头,中间那段交给它。两头都比中间难。
上面那五行我自己填过一次。填到第三行才发现,模型这头的花费我从来没单独记过——一直混在工具订阅里,看不见。
你的单次查新,现在算得出来吗?
算不出来也别急。我把自己的核算方式整理成一页,公众号后台回复「账本」发你。
这篇也可以转给你们做检索的同事——他大概正被账单追着问。
王工
拥有 10 余年专利行业实战经验,深谙甲乙双方视角与博弈逻辑。
目前正在探索 AI 与专利业务的深度融合,打造实用的提效工具。
关注我,带你从商业角度看专利、聊 AI~