ARTICLE · 1307231
浏览器直接开 Word、Excel、PPT,还能编辑和协作:这个刚开源的 npm 包把老需求重做了一遍
office-engine-cover
做后台系统的人,大多都躲不开三类文件,合同的docx,财务的xlsx,还有培训用的pptx。想要在业务系统里面直接查看,最好还支持修改,历史上基本就两条比较主流的路子。后端部署LibreOffice转PDF,或是自行搭建OnlyOffice、Collabora这类服务。服务器部署、数据迁移、授权方面,一路上能碰到不少麻烦。
现在还有一种新方案可以看看。有个npm包名叫@p10node/office-engine,它把docx、xlsx、pptx的查看和基础编辑能力,整体放到浏览器里面运行。装好包,挂载对应的组件,传入文件URL,基本就能跑起来。
先看几组公开的数据
这个仓库是2026年11月2日创建的,当天就在npm发布首个版本0.4.0。版本发布当天,npm下载量是847次,前面29天的下载记录全部为0。GitHub仓库目前有37颗星,1个fork,issues板块还没有提交记录。
在我看来,这套代码大概率不是短短两天赶出来的。刚开源版本号直接给到0.4.0,比较有可能是作者先在内部项目里迭代了一段时间,开源只是把仓库对外放出。这部分属于我的推测,作者没有给出相关说明。
顺带提一个不错的点,这个包采用可信发布流程,依靠GitHub Actions搭配OIDC,发布产物附带SLSA出处证明。在软件供应链安全这块,它相比大部分刚开源的小包要考虑得更周全。
再说说它的读写架构,核心分为四块
docx、xlsx、pptx本身本质都是zip压缩包。不少解析方案不会区分内部资源,拿到文件就完整解压,把全部内容加载进内存,文件体积偏大的时候就容易卡顿。office-engine设计了四套机制,基本可以避开这类问题。
第一块是懒ZIP加载。它优先读取压缩包里面的central directory目录区,只有用到某个内部资源的时候,才按需解压对应部分。解压逻辑依赖浏览器原生的DecompressionStream,这一步不会引入额外第三方依赖。
第二块是HTTP Range分片拉取。传入文件URL之后,它会按字节区间拉取需要的数据,以256KB为分片做缓存。如果目标服务器不支持Range请求,还能自动降级,改成下载完整文件。
第三块是流式XML解析放到Web Worker里面执行。主线程不会被阻塞,页面交互大体上可以保持流畅,不容易掉帧。
第四块是虚拟化渲染。docx只渲染当前可视区域的页面,xlsx采用二维虚拟网格,pptx的缩略图会跟着滚动动作按需解析。
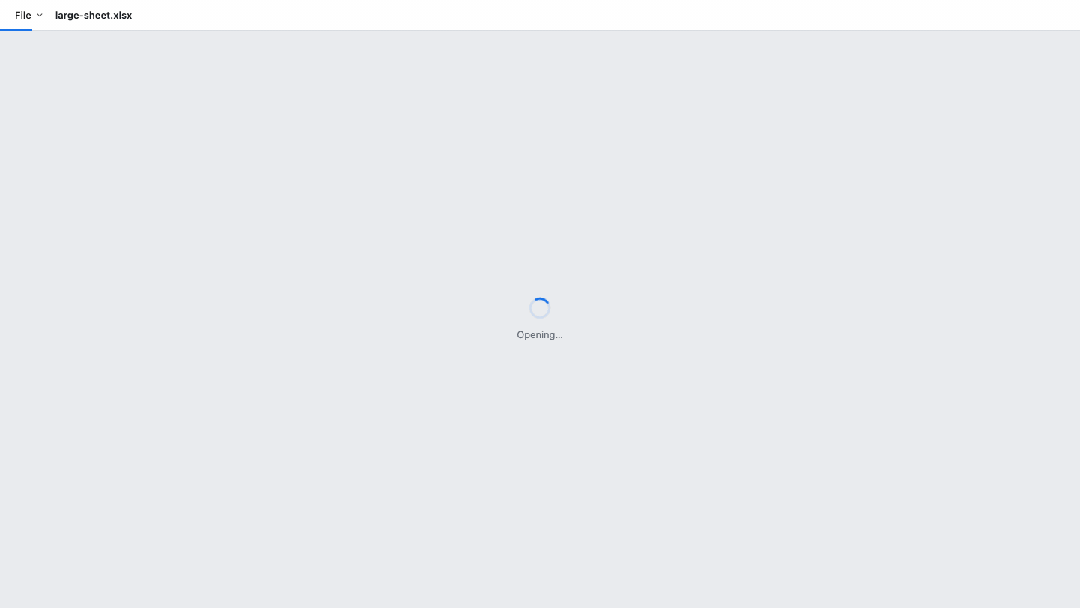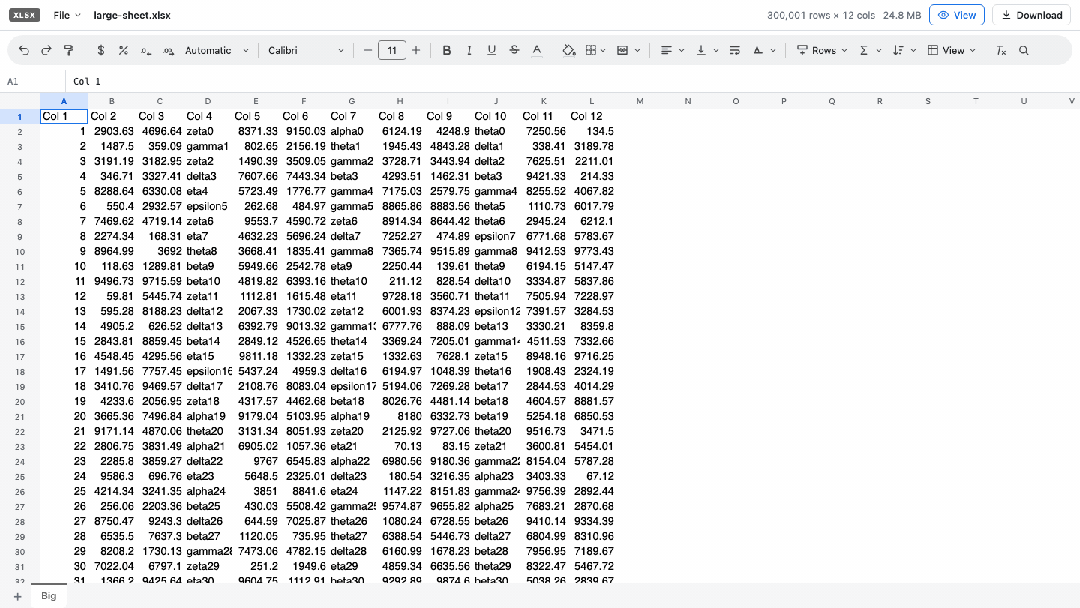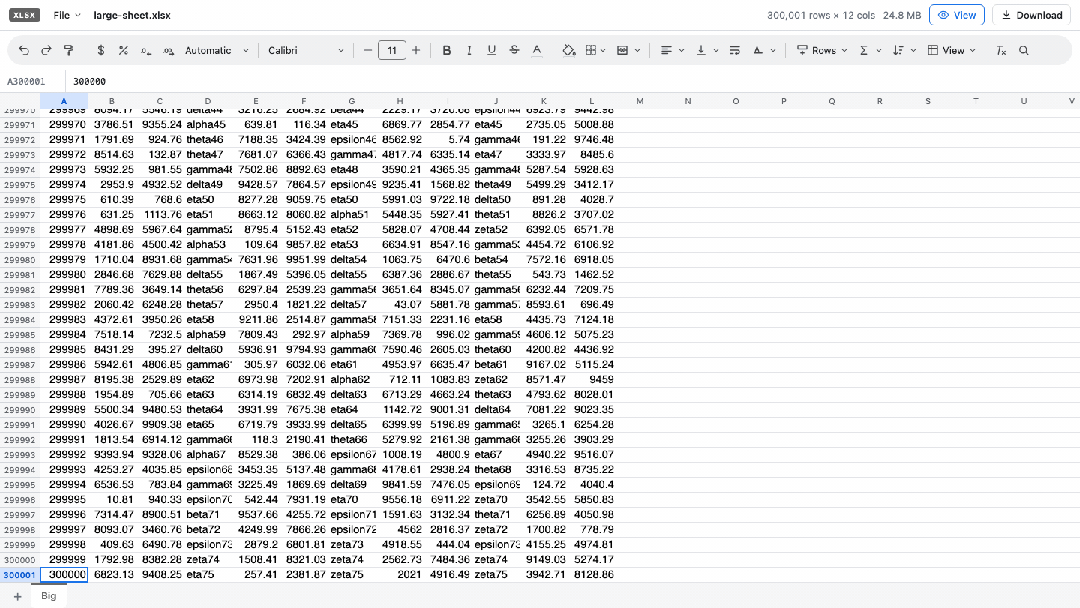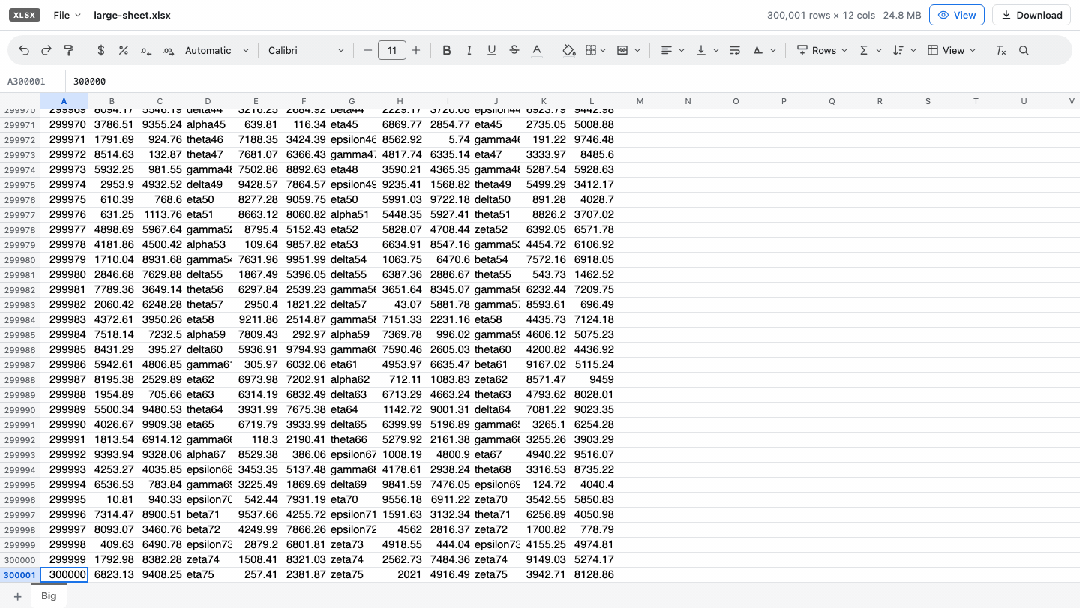
下面这些性能数据直接取自官方测试,测试环境是无头Chromium,Apple M系列设备:1.2MB、包含2万个段落的docx,首次渲染大概180毫秒,加载完整2073页全文大约耗时2秒;24.8MB、30万行乘12列的xlsx,首绘大约330毫秒,全部加载完成接近2秒;305页的pptx,首绘约110毫秒,剩下页面按需加载。
编辑和保存这块,设计上确实花了心思
开启editable属性之后,组件就会从查看器切换成编辑器,onSave回调可以直接返回Blob文件流。
docx支持文字输入、插入图片、新增表格,标题样式快捷键是Ctrl或者⌘+Alt+0到6,还配套文档大纲侧边栏。xlsx目前支持134种公式函数,编辑之后即时重算,输入函数的时候会提示名称和参数,也能跨工作表点选单元格插入引用,引用标识会带上颜色区分。pptx可以插入形状、修改文字,也支持幻灯片放映。
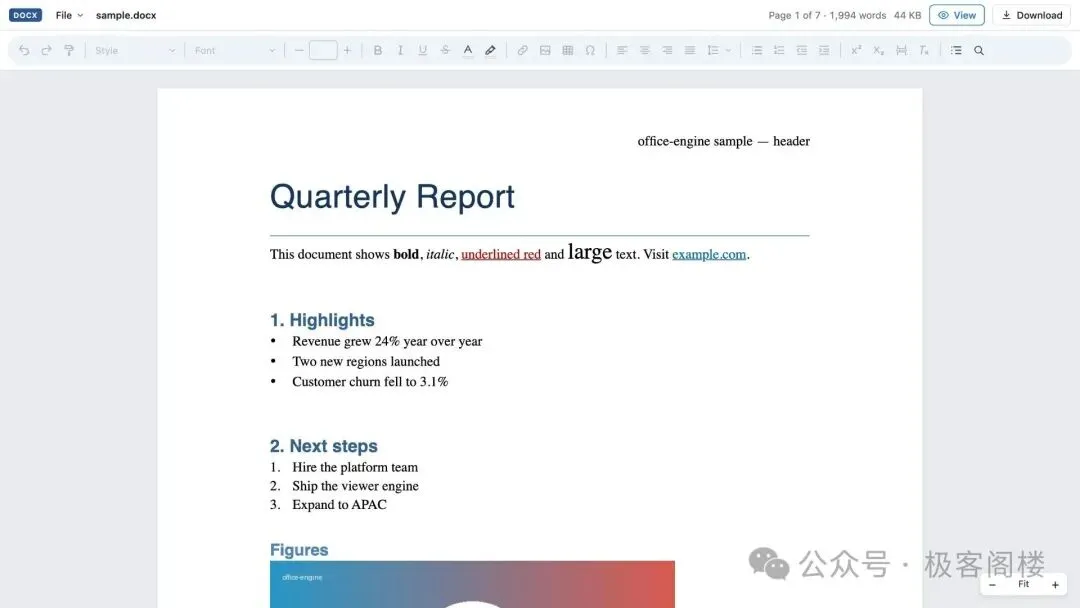
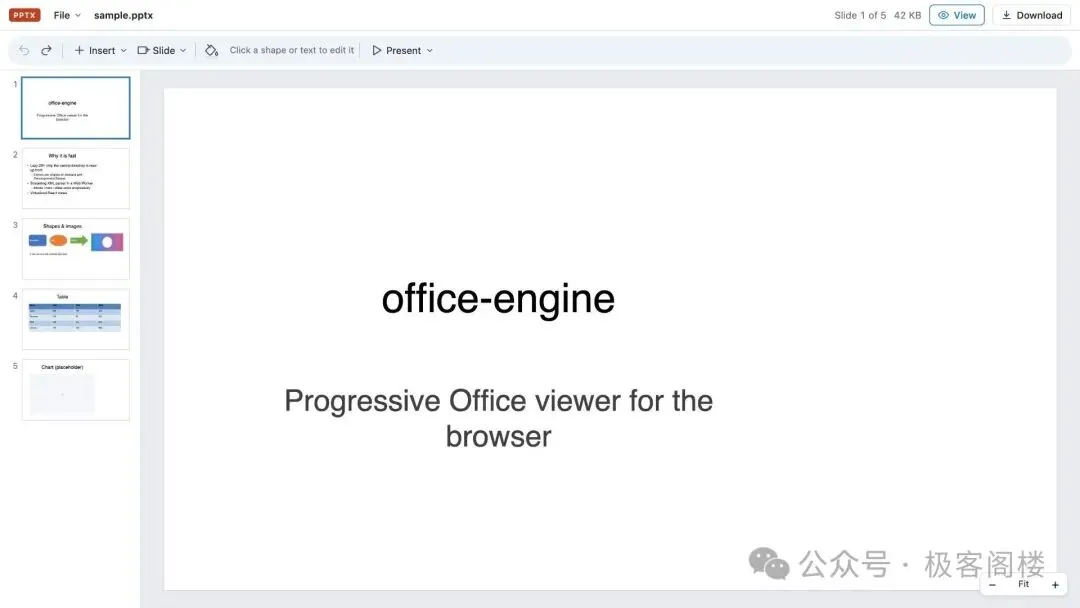
保存的实现方式,值得多留意一下。docx只会重新生成改动过的段落,没有修改的字节数据原样保留;xlsx只重写包含编辑单元格的row节点,整张工作表不用全部挂载到DOM;pptx只更新被改动形状对应的文本内容。除了修改部分,压缩包内其余条目一般不会重新压缩。官方给出的测试数据里,2073页的docx新增一个字符大约7毫秒,2万段落的文档保存耗时约0.5秒,25MB表格修改两个单元格,保存大概3秒。
文件菜单还有几个细节我觉得挺好。CSV、TSV文件拖入页面,能够直接转为工作簿,像007这类数字编号,会保留成文本格式,不会自动转成7。导出PDF功能,底层调用的是浏览器打印弹窗,页面先做离屏渲染,再交给系统打印能力。因此业务如果需要在服务端生成标准PDF,还得另外找方案,这点不要搞错。
实时协作功能是已经落地实现的
多人协作采用房间机制,同一个房间内的用户,基于同一份源文件编辑,改动可以同步展示。头像和光标会实时渲染在文档上,docx显示输入位置和选区,xlsx展示单元格选中框,pptx定位到形状。断线期间提交的编辑内容,重连之后可以自动同步。
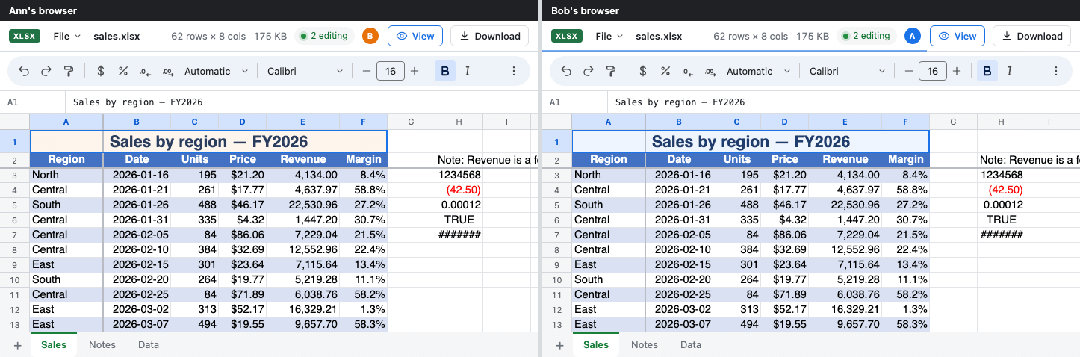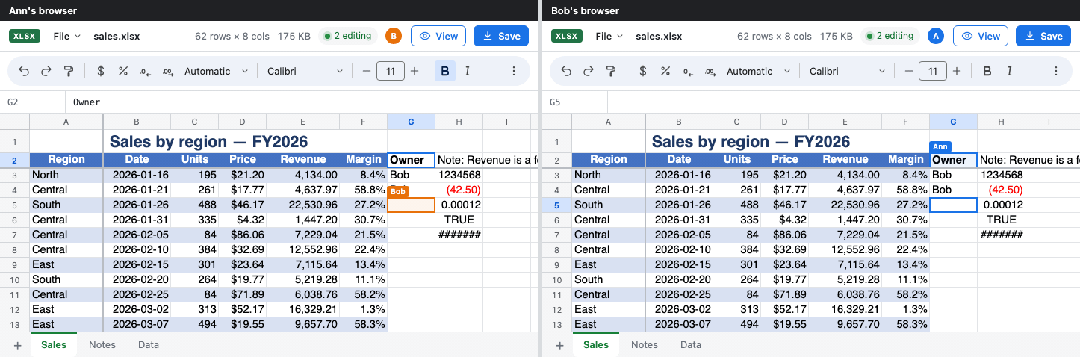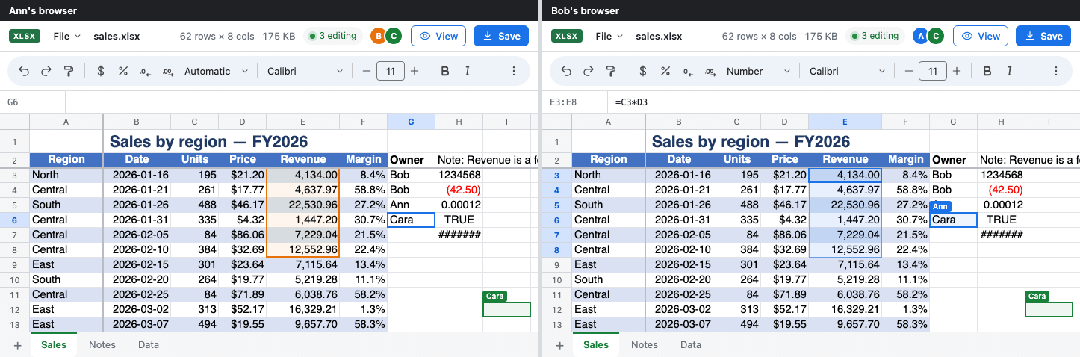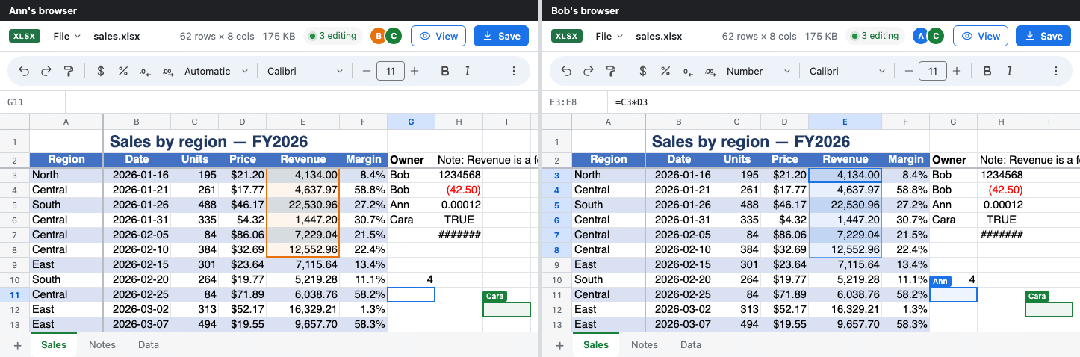
参考启动命令很简单,bun run collab,在8787端口拉起一个hub服务。在playground页面点Share live,就能生成分享链接。服务端持久化,可以配置DATA=./collab-data指定本地目录,或是填入S3_BUCKET对接对象存储。核心组件是和运行时无关的CollabHub,它主要负责给操作排序、存储操作日志、同步在线状态。如果你本身有自研WebSocket服务,可以按照Transport接口自行对接,或是实现BlobStore,接入自家存储服务。版本历史能力也自带,每一批操作追加写入日志,累计500批操作或者房间清空之后,生成一次快照。任意历史版本文件,都可以基于最近快照回放后续操作得到,下载文件甚至不用经过服务端,浏览器本地就能完成导出。
冲突处理规则,文档写得比较直白。docx段落内部的文字修改会尝试合并;段落拆分、单元格、形状这类元素,后提交的改动优先生效;插入或是删除行列这类结构变更,交给hub统一排序,单次往返完成同步。
文档里有一句原话最好记一下,参考服务本身没有鉴权能力,put it behind your own auth。它只是演示用的简易服务,放到生产环境,必须加上自研的身份校验。
正式上线之前,先把它的局限看清楚
限制项比较多,我挑几个影响比较大的整理出来。
老式二进制格式doc、xls、ppt不支持,加密文件同样无法解析。docx的页眉页脚、文本框、嵌套表格目前只能读,目录段落也仅支持查看。xlsx没法编辑图表、数据透视表、条件格式、数据验证和筛选器。pptx不能拖拽旋转形状,表格内部文字暂时不可编辑,动画和转场效果没有实现。公式方面还有三处缺失,defined names、Table1[Col]这类结构化引用,还有跨工作表三维引用都不支持。
协作模块还有另外一部分限制。撤销重做只能回滚自己提交的操作;docx协作房间暂时不生成快照,新加入用户需要回放全部历史记录;协作里删除行列的动作,撤销不了。
实际上整体体验看下来,查看和轻度编辑目前基本能用。涉及复杂格式的深度编辑,比如图表、透视表这类功能,还明显不够完善。带图表和透视的表格,最好先上传到demo页面实测一遍,再决定是否采用,不要直接拿客户正式文件测试。
不用React的团队,也不用直接跳过
接入方式不只有React这一种。项目还提供原生mount()函数,以及office-viewer这个Web Component。另外单独打包了office-engine.embed.js,里面已经内置React和worker,页面引入脚本,写上自定义标签就能使用。这里提两个容易踩的点,CSS会自动注入页面,容器一定要设置足够高度,不然渲染出来就是空白。
顺带说下工具链,项目基于Vite 8和Bun构建,e2e测试依靠playwright-core。peer依赖只有react和react-dom,最低要求React18。维护信息方面,npm页面只登记了一位维护者pierreneter,p10node这个组织账号没有额外介绍,更多背景官方未说明。
最后说几句
它现在版本还停留在0.4.0,37颗星,847次下载,大致就是它当下的体量。现阶段想着直接替换OnlyOffice,不太现实。值得关注的地方,主要在工程思路。解析和渲染压力下放给Worker,做字节粒度的优化,API设计贴合前端常规调用习惯,协作和版本历史整套能力一并实现。相比坐等1.0版本,现在帮忙提交问题、补充使用案例,收益会更高。
演示页面放在仓库文档链接下,托管在GitHub Pages。你可以直接拖入自己这边结构复杂的表格,看看能不能在2秒左右加载完成。图表、条件格式会不会出问题,不用写代码就能验证。
项目地址:github.com/p10node/office-engine
在线demo:p10node.github.io/office-engine/demo/
使用文档:p10node.github.io/office-engine
你们业务系统里的附件预览,现在是后端转PDF,还是搭了自建的Office服务?可以说说各自碰到的麻烦。