ARTICLE · 1373362
Android 17 新能力:给 App 立一份内存预算,系统就不再杀你
用户切出去回个微信,回来发现你的 App 已经被系统清掉了。这个问题在 Android 上存在了十几年,我们一直无能为力。Android 17 QPR2 给了一个新答案:你可以主动向系统承诺一个内存预算——超了不杀你,只回收你的冷内存。
这篇把这件事讲清楚:它是什么、和内存限制差在哪、Manifest 怎么声明、超预算会发生什么、运行时怎么灰度。
说明:文中每段代码都附了一张渲染图,方便直接贴到公众号;读 Markdown 的同学看代码块即可。
一、先说结论:从"被动被杀"到"主动承诺"
过去我们对待内存的态度是彻底防御性的:少分配、及时释放、别泄漏。因为一旦系统内存吃紧,低内存杀手(LMK)按 oom_adj_score 排序下手,你排第几,就什么时候被清掉——你没有任何发言权。
App memory budgets 换了个思路。
你在 Manifest 里声明一句"我这个进程最多用 256MB",系统就按这个数字来管你。超过 256MB,它不会杀掉你,而是把你"较长时间未使用的冷内存"回收掉,把占用压回预算以内。
注意这句话里的两个关键点:
不杀进程。 所以你不会收到任何"崩溃",用户也不会看到应用消失。 回收的是冷内存。 也就是你已经不用的那一部分——上一个页面留下的位图缓存、启动时的一次性缓冲、分配高峰之后剩下的堆余量。
代价也写得很直白:如果你的工作集本身就超过预算,性能一定会掉。系统只能换出你还在用的页,CPU 反复压缩解压,帧率和电量一起买单。
所以这个能力的本质不是"省内存",而是把不可控的资源变成一份可以自己定的合同。适用面也很明确:
系统应用、预装应用; 内存本就吃紧的设备; 清楚自己工作集的普通应用——注意是"清楚",不是"觉得"。
版本门槛:Android 17 QPR2,minor SDK API 37.2(Build.VERSION_CODES_FULL.CINNAMON_BUN_2)。低版本系统会直接忽略不认识的 元素,所以写进 Manifest 不影响向后兼容。
二、别搞混:它不是 App Memory Limits
这是最容易混的一对概念,先分清再往下看。
一句话区分:
Limits 是平台画的生死线,Budget 是你自己签的合同。
前者你只能认,后者你可以谈。而且谈得好,你还能顺带拿到一个好处:系统在压你的内存之前,会先通知你(后面讲 OnOverBudgetListener),而不是像以前那样毫无预兆地被杀。
三、Manifest 声明:四种写法,一个必须记住的坑
3.1 最简形态:一行搞定
不需要任何运行时代码,写在 里就行:
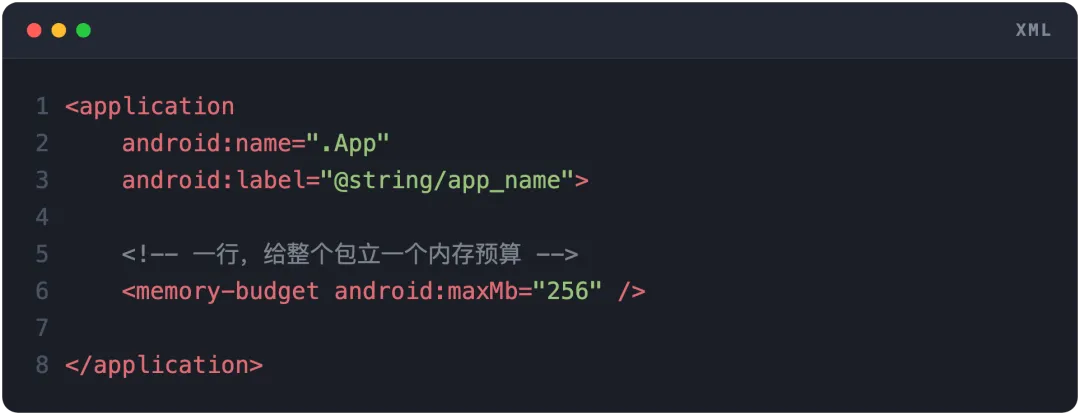
这一条同时作用于包内所有进程、所有状态。超过 256MB 后,系统开始驱逐和 swap 非活跃页。
两个细节:
maxMb用的是二进制单位,1MB = 1,048,576 字节; 声明值不能超过系统内存限制,超过了以系统限制为准——所以不必担心写太大"抢"到不该有的资源。
3.2 按状态分级:这才是它真正的价值
一个应用在三种状态下需要的内存完全不同:
foreground:有可见 Activity 且正在交互,内存占用最大,要给 UI 和图形留足空间; perceptible:用户能感知但没有可见窗口——播放音乐、后台下载、导航、输入法; background:后台任务、广播接收器、数据同步,应该保持最小占用。
所以可以分开声明:
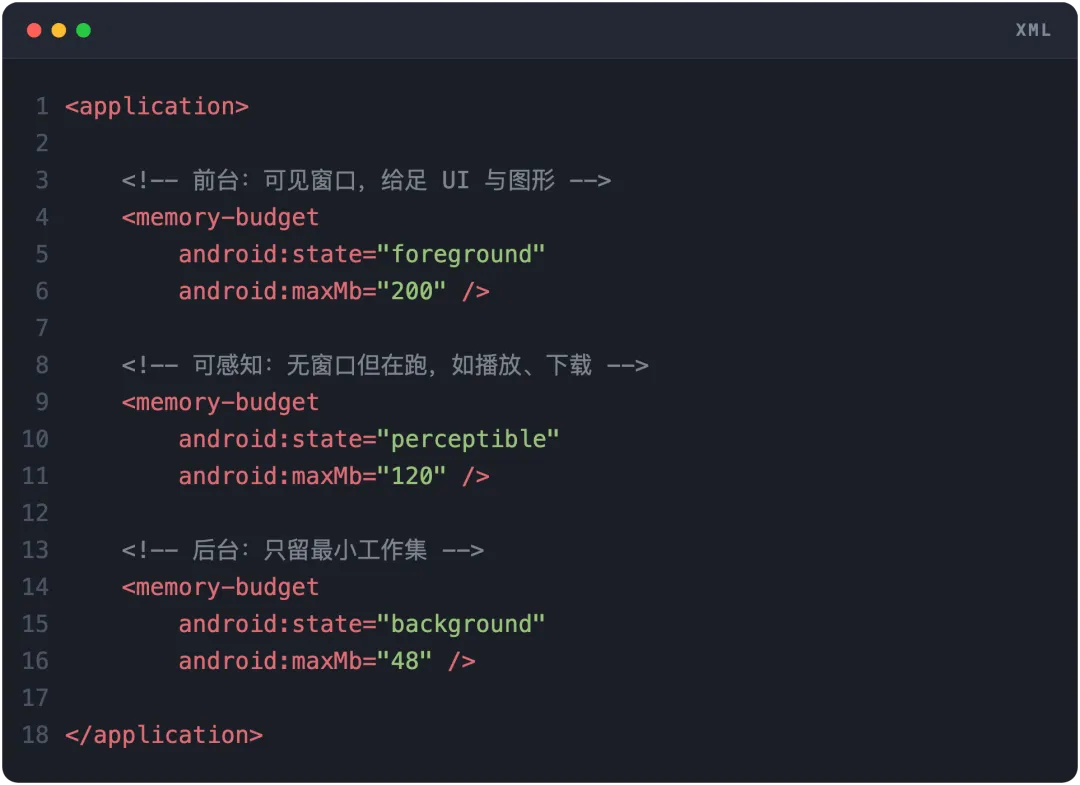
这个例子给的是 200 / 120 / 48 的梯度,思路很值得抄:前台保帧率,后台保干净。
前台预算的底线是帧渲染不能卡,内存密集型流程(比如图片编辑)如果吃得太狠,更好的做法是拆到独立进程——独立计预算,退出即销毁; 后台没有帧的 deadline,驱逐一次性文件缓存、换出非活跃堆页,用户基本无感,所以可以压得很紧; 后台预算要在后台任务真正跑起来的时候测,而不是等进程空闲 cached 了再测,否则你测的是个假数。
状态和系统内部进程状态怎么对应?平台按 RunningAppProcessInfo.importance 映射:
foreground | IMPORTANCE_FOREGROUNDIMPORTANCE_TOP_SLEEPING | |
perceptible | IMPORTANCE_FOREGROUND_SERVICEIMPORTANCE_VISIBLE | |
background | IMPORTANCE_PERCEPTIBLEIMPORTANCE_CANT_SAVE_STATE、IMPORTANCE_SERVICE、IMPORTANCE_CACHED |
这里有一个反直觉的点,建议画重点:
内部指标里的
PROCESS_STATE_IMPORTANT_FOREGROUND并不代表"有可见窗口",它归到 perceptible 预算。
也就是说,别拿名字猜状态,拿 importance 对表。
3.3 多进程:子进程可以单独立预算
音乐、社交、编辑器这类应用经常有独立进程。预算可以按进程拆:
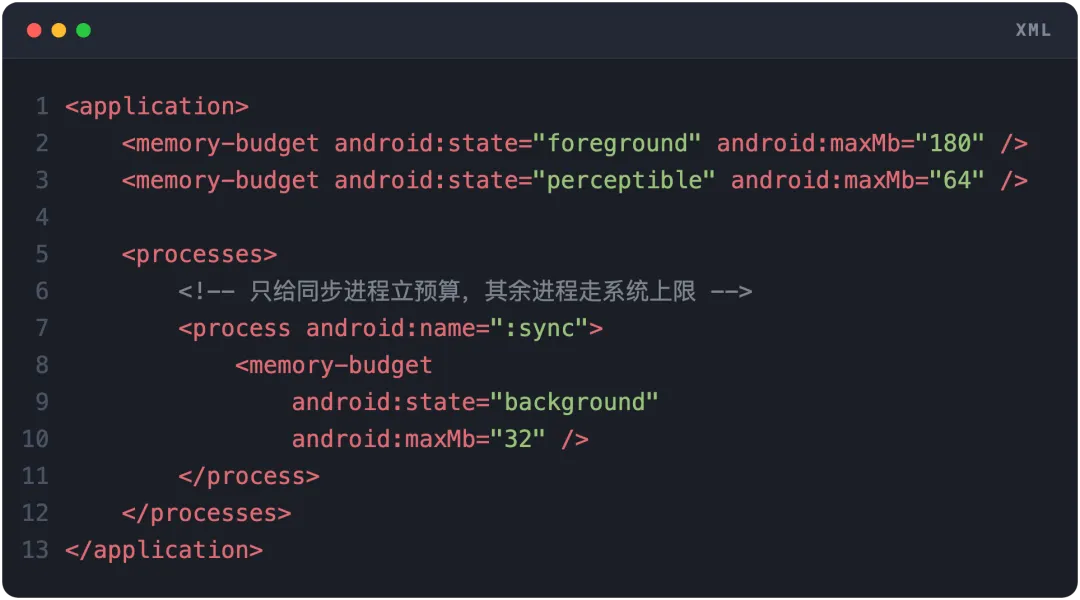
三条规则要记住:
<processes>里只列出你写了 <memory-budget>的进程,没列的走系统上限;子进程内存同时计入进程预算和包预算,任意一个先超限都会触发内存压力; 每进程预算需要 AGP 9.5.0 及以上。
3.4 屏幕和高密度设备:按密度或像素数扩展
图库、相机这类应用的内存随像素数线性甚至超线性增长。官方给了两个二选一的扩展属性:
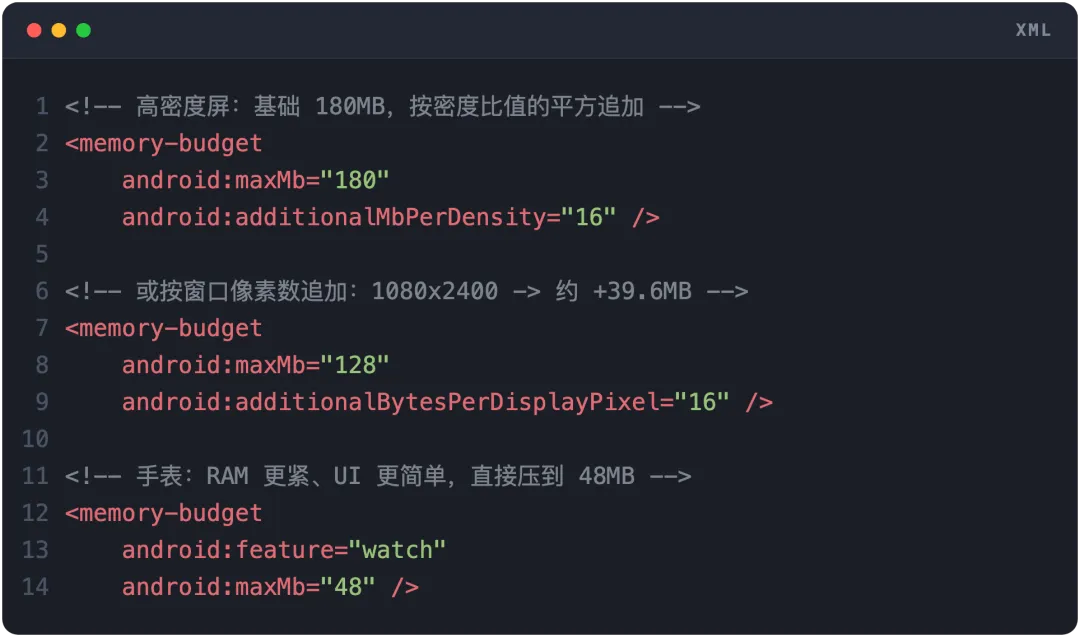
两个属性的差别在生产环境里很实际:
additionalMbPerDensity | ||
additionalBytesPerDisplayPixel |
前者是"估算式",后者是"精确式",官方明确说不要在同一条 clause 里同时用。
再往后还有 android:feature,目前支持 watch、automotive、leanback。手表 RAM 更紧、UI 更简单,180MB 直接覆盖成 48MB,这个覆盖非常必要。
3.5 最容易踩的坑:最后一个匹配的 clause 生效
这一条如果不注意,你写的三条状态预算会全部失效:
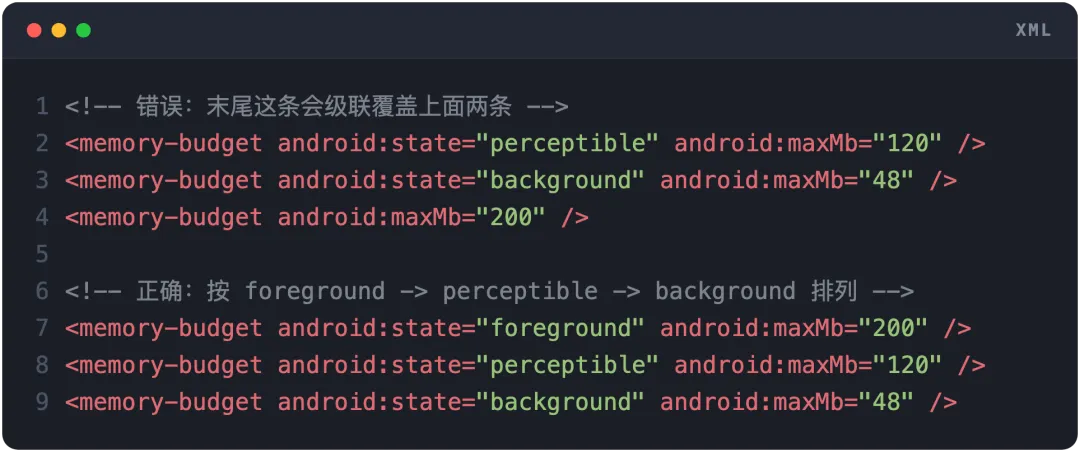
规则是两条,合在一起就成了坑:
多个 <memory-budget>按在 Manifest 中出现的顺序依次评估,最后一个适用的 clause 生效;省略 android:state默认是 foreground,并向下级联到 perceptible 和 background。
所以那条不带 state 的 maxMb="200" 一旦放在最后,就会把自己级联到所有状态,前面两条白写。
结论:永远按 foreground(或省略)→ perceptible → background 的顺序写。如果用了 android:feature 覆盖,把它放在对应状态组内部,别放末尾,否则会被后面不带状态的 clause 遮掉。
顺带一提,想校验静态声明可以用 PackageManager.getMemoryBudgets——但它只读下的声明,不读 ,也读不到运行时动态设置的值。
3.6 属性速查
android:maxMb | |||
android:state | foreground | foregroundperceptible / background,省略时向下级联 | |
android:additionalMbPerDensity | |||
android:additionalBytesPerDisplayPixel | |||
android:feature | watchautomotive / leanback |
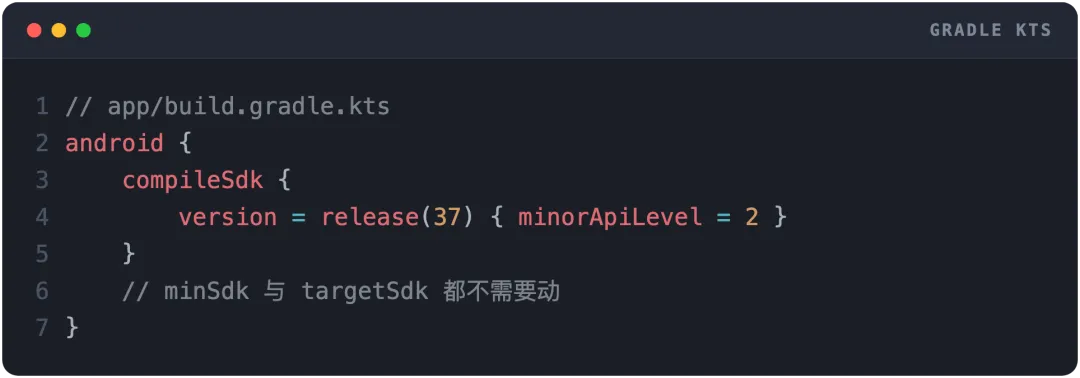
编译侧只需要改 compileSdk,不用动minSdk和targetSdk:
四、超预算之后,到底发生了什么
这是整个机制里最需要理解的部分,因为它决定了"预算该定在哪"。
先明确:不会崩溃,不会被杀,不会 ANR。系统只是在后台做一次"清仓",顺序固定:
clean 的 file-backed 页(冷代码、已映射的资源)→ 直接驱逐; dirty 的 file-backed 页 → 写回存储后驱逐; 匿名页(堆分配) → 压缩后放进 zRAM。
翻译成人话:先扔"磁盘上还有原件"的东西,再扔"改过但要留底"的东西,最后才动你的对象堆。
只要你的工作集(当前流程反复访问的堆 + 热代码页)还装得下预算,应用就正常跑,用户完全无感——这是理想状态,也是我们想要的。
一旦预算低于工作集,事情就变成这样:
内核开始换出你还在用的堆页; 你下一次访问,它得从 zRAM 解压搬回来,这叫 refault; refault 一多,CPU 时间和电量上去,如果发生在 UI 线程或 RenderThread 上,就是卡顿。
所以官方给了一个非常好用的判断依据:
看
file和anon这两个数。file一路降、anon纹丝不动 → 还在吃冷页,健康;file降到底、anon开始降、refault 从个位跳到几百上千 → 已经开始换出工作集了,踩线了。
那个"刚好只回收冷内存、又不产生额外 refault"的预算点,有个专门的名字叫膝点(knee)。找到它,才是定预算的全部技术含量所在——这属于另一篇的量级,这里先按下不表。
五、运行时:查询、收紧、监听
Manifest 是静态的,但用户场景是动态的。比如一个图片编辑器:多层画布的编辑界面确实要 256MB,可用户只是滑缩略图画廊时,凭什么还占着 256MB?
MemoryBudgetManager 就是干这个的。
5.1 查询与收紧
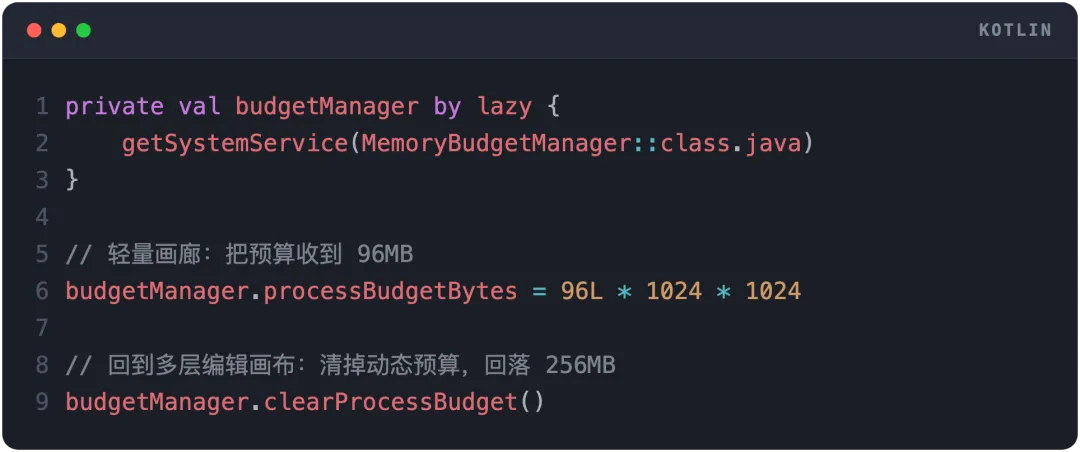
可查询的四个值:
processCurrentUsageBytes/ packageCurrentUsageBytes:进程 / 包当前计入的内存;processBudgetBytes/ packageBudgetBytes:进程 / 包的上限,未设置时返回LIMIT_IS_DISABLED。
这些查询是本地 native 调用,速度很快,但官方仍然建议按需调用——别在紧循环里轮询。而设置预算会跨进程调用系统服务、改内核内存控制器,更不能放在音频线程或逐帧渲染路径上。
5.2 超预算回调:这是最实用的部分
以前系统压你的内存,你只能事后从 GC 日志里猜。现在可以提前收到通知,主动把大对象释放掉:
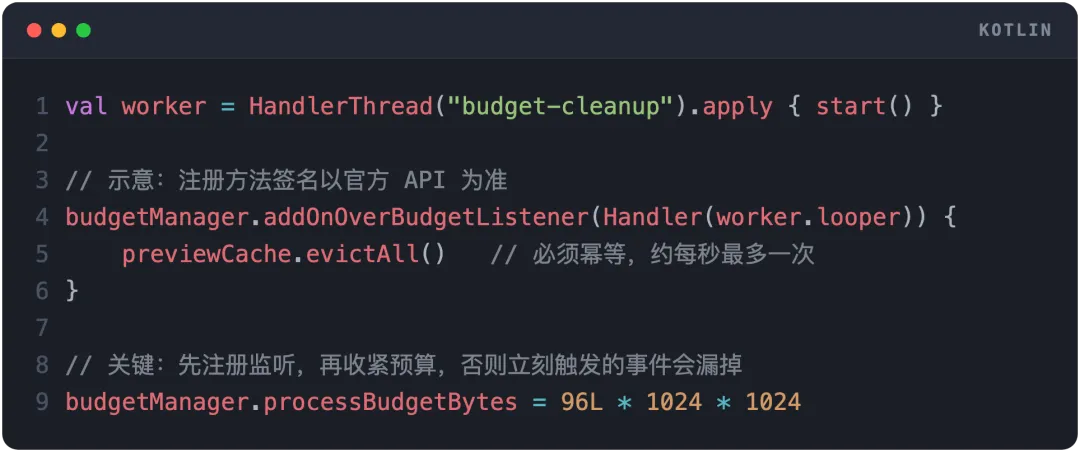
这段代码里有四个细节,每一个都是官方明确写的坑:
用后台 HandlerThread的 Looper,别跟 UI 帧渲染抢主线程;先注册监听器,再收紧预算——如果你当前用量已经超过新预算,设置的那一刻就会立刻触发一次事件,注册晚了就漏了; 回调会重复,最多约每秒一次,实现必须幂等(注销、冷却时间戳或 AtomicBoolean控制);回调里不要分配新对象、不要起线程,否则可能触发直接回收。要释放就释放大的:大位图、渲染缓冲、关闭 memory-mapped 文件。
六、上线路径:别直接怼 Manifest
官方推荐的路径是两阶段,而且有一个硬约束你必须先知道:
运行时预算只能收紧,不能放宽 Manifest 的限制。
所以"先发个激进的值,再靠服务端放宽"这条路是走不通的。正确的顺序是反过来的:
阶段一:远程配置验证
APK 里不带 ``,或者只带一个宽松的安全上限; 用服务端实验开关控制候选预算,在 ProcessLifecycleOwner等生命周期节点应用;记得捕获 IllegalArgumentException——设备系统上限或窗口缩放上限较低时会抛;关开关就调 clearProcessBudget/clearPackageBudget,不发版即可回滚。
阶段二:写进 Manifest
等线上遥测确认跨设备档位稳定了,再把稳态的 foreground / perceptible / background 预算迁移到 Manifest; Manifest 的优势是进程启动即生效、随状态自动切换,不依赖任何业务代码执行时机。
七、落地前,五个必须知道的坑
1. 必须用 release 构建测。debug 构建的插桩、日志、调试分配会显著抬高内存,测出来全是"频繁 swap + 性能不达标"。官方的说法很直接:用 debug 构建做这个测试,会失败。记得开 R8、关 debuggable。
2. 运行时只能收紧。再强调一次,因为它决定了灰度方案的设计方向。
3. 预算不等于峰值。预算应该略高于工作集。贴着无约束峰值定,等于没设——冷余量永远回收不掉;压到工作集以下,就是在拿 CPU 和电量换那几十 MB。
4. 计费口径要看清楚。预算是按 Linux cgroup 的 memory.current 计费,不含 Zygote 共享内存;硬件位图和 DMA-BUF 分配也不计入,而软件位图是计入的。这三个差异会直接影响你读数的判断。
5. 别用名字猜进程状态。dumpsys 里 curProcState=4、state: cur=FGS 是前台服务(走 perceptible 预算),可见 Activity 显示 TOP,重要前台组件显示 IMPF。查不清的时候,先跑:
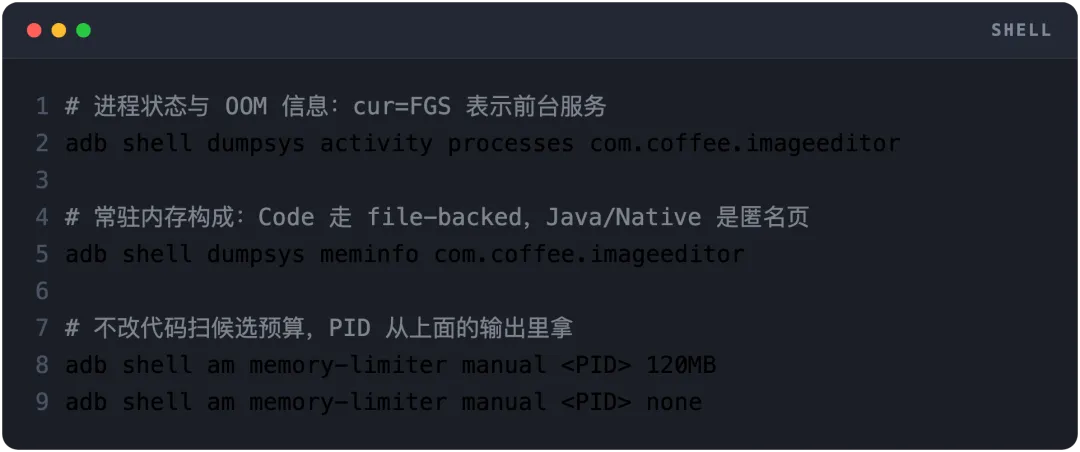
最后那两条 am memory-limiter manual 值得单独说一句:它让你不改代码、不重新打包就能试不同预算,是做预算扫描的核心工具。但要注意它同时把进程的硬上限 memory.max 也设成了这个值,所以候选值低于工作集时进程会直接被 kill,而不是"变慢"——这种候选毫无疑问是失败的。
八、小结
App memory budgets 不是一个"省内存"的能力,它是把内存从不可控的运气,变成一个可声明、可测量、可灰度的工程参数。
它的完整链路是:
Manifest 声明 → 状态分级 → 运行时收紧 → 超预算回调 → 远程灰度 → 写入 Manifest
而这条链路上真正难的只有一件事:你的预算该定多少。
这需要一套完整的方法:从 cgroup 里读 memory.current、anon、file 和 refault 计数,用 am memory-limiter 扫候选值,按"CPU ≤ 5%、掉帧 ≤ 1 个百分点、P95 ≤ 3ms、温启动 ≤ 15%"判定,找到那个阈点,再加 10%~20% 余量。