ARTICLE · 1375332
文件夹里搜一句话,连PDF一起找
先说结论:能用。在一堆 PDF、Word 和压缩包里搜一句话,不必逐个打开。 我做了一组合成的「星辰一期项目资料」(10 个文件,协议、纪要、报价、扫描件都是虚构的,不是真实合同)。要找的那句是「验收后三十日内支付尾款」,它只写在一份文字层协议 PDF 里。普通 rg 搜整个目录,0 命中,退出码 1。换 rga,清空缓存后第一次墙钟 0.22 秒,峰值内存 56.6MB,命中就是这一份 PDF 的第 1 页;再搜同一句是 0.05 秒 / 7.2MB。压缩包会递归进去,并打出内部路径。全程在本机,不上传。
适合:手里是一文件夹文字层 PDF、Word(.docx)、zip,想搜某一条款或某一句纪要的人。别指望:扫描件或纯图片能被默认搜到——我把那句话画进一张签字页再导出 PDF,眼睛看得见,pdftotext 却是空的,rga 也是 0 命中。xlsx、旧版 .doc 默认同样搜不到。搜 Word 还需要另外安装 pandoc。
工具是 ripgrep-all 0.10.10(也就是命令 rga),开源项目 https://github.com/phiresky/ripgrep-all ,许可证是 AGPL-3.0。作者在 LICENSE 里写:作为个人项目的默认许可,他选了 AGPL。它是在 ripgrep 外面加了一层预处理,把 PDF、Office、压缩包里的文字抽出来再交给 rg,不是 AI 模型,也不是在线搜索。2026-11-18 早晨查 GitHub 是 9932 星。文末有一条可复制的命令,以及一个只负责调用官方 rga、把命中写成清单的小脚本 sousuo.py。
一、为什么要在文件夹里搜,而不是逐个打开
一份协议在 PDF 里,一份纪要是 Word,上个版本又躺在压缩包里。要核对「尾款几天付」这种句子,常见做法是逐个打开、用阅读器自带的查找。文件一多就容易漏,也不想把整包资料传到在线搜索网站。
普通的 rg 很快,但只认文本。PDF 和 .docx 对它来说基本是打不开的黑盒。我要测的是另一件事:在本机目录里直接搜正文,文字层 PDF、Word、zip 里的旧版本,一次覆盖。
二、安装:官方二进制,再补上依赖
我用的是 GitHub Releases 上的官方 musl 二进制 v0.10.10,不是自己用 cargo 编的未发布提交。压缩包 8,375,790 字节,sha256 以 a969c25b 开头;解压后的 rga 6,772,816 字节,rga --version 输出 ripgrep-all 0.10.10。rga-preproc 要和 rga 放在同一目录。
它会调用已经在 PATH 里的助手程序。本机已有 ripgrep 14.1.1 和 pdftotext 25.03.0(poppler-utils)。搜 .docx / .odt 还需要 pandoc。本机当时 Debian 的 apt 源不可用,我改用了 Pandoc 官方的 3.14 Linux 二进制;在 Debian / Ubuntu 上,一般直接 sudo apt install pandoc 即可。rga --rga-list-adapters 默认启用 pandoc、poppler、ffmpeg、zip、tar 等;默认没有 OCR,也没有 xlsx。
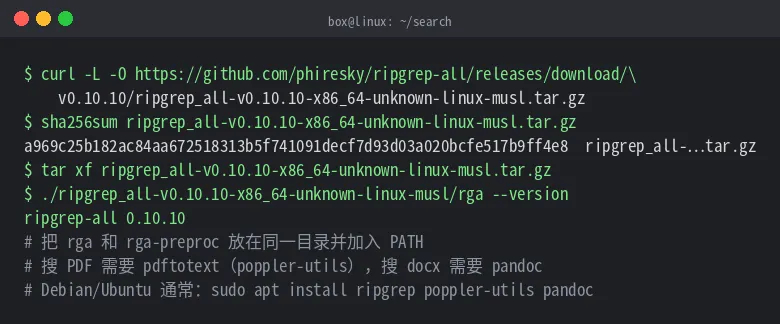
官方 v0.10.10 musl 二进制,rga --version 为 0.10.10;搜 PDF 需要 pdftotext,搜 Word 需要 pandoc
这一版发行资源里有 Linux musl / gnu 和 mac 的 darwin 包,没有 Windows zip。v0.10.9 是有 Windows 包的。Windows 和 mac 我都未测。
三、实测:rg 找不到,rga 找到了
合成协议里写着:「项目通过书面验收后,甲方应在验收后三十日内支付尾款。」我用 pdftotext 核对过,这是可选中的文字层,不是一张图。同一目录里还有会议纪要、需求说明、工作备忘、扫描件、报价表、一段带软字幕的短视频,以及一个「往期归档.zip」。
同一句话,两种工具:
$ rg --color never -n '验收后三十日内支付尾款' 项目资料 # 退出码 1,没有命中 $ rga --color never -n '验收后三十日内支付尾款' 项目资料 项目资料/01-技术服务协议.pdf:20:Page 1: 项目通过书面验收后,甲方应在验收后三十日内支付尾款。首付款与进度款的比例以
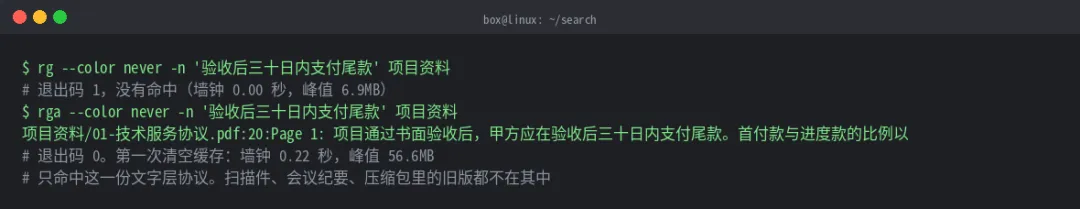
同一句「验收后三十日内支付尾款」:普通 rg 0 命中;rga 在合成协议 PDF 第 1 页找到
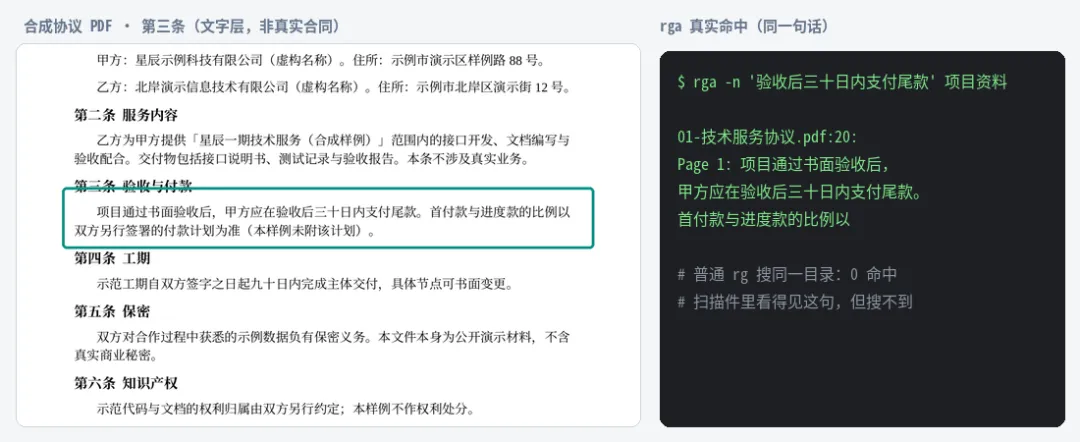
左:合成协议 PDF 第三条(文字可复制);右:rga 的真实命中行
命中只有这一份 v3 协议。会议纪要里虽然也出现了「验收」「尾款」,但没有这句整句;压缩包里的旧版写的是「六十日内」,所以也不会被这句精确搜索带到。纯文本备忘里的「项目代号「星辰一期」」,rg 和 rga 都能找到,说明对照是公平的:rga 并没有改写 ripgrep 搜普通文本的能力。
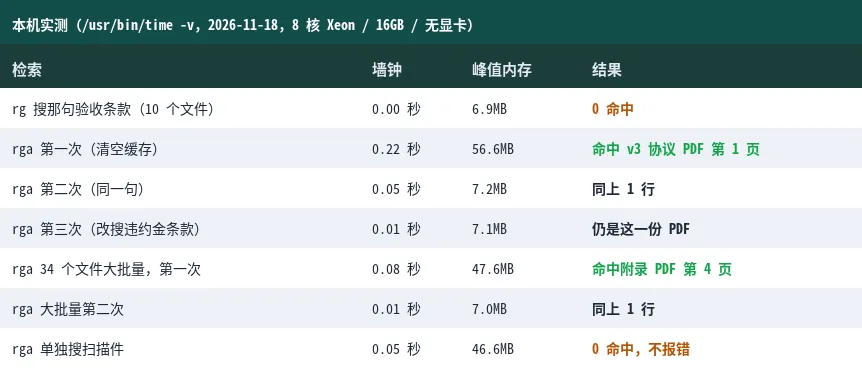
本机计时:10 个文件的文件夹里,rga 第一次 0.22 秒 / 56.6MB,第二次 0.05 秒 / 7.2MB
四、压缩包、二次搜索,以及扫描件
旧版协议被我放进 往期归档.zip 的 2025/ 子目录。搜「验收后六十日内支付尾款」时,rga 打出的路径是:
项目资料/往期归档.zip:20:2025/技术服务协议-v2.pdf: Page 1: 项目通过书面验收后,甲方应在验收后六十日内支付尾款。首付款与进度款的比例以
正则 违约金.*百分之 会同时命中 v3 的「百分之二十」和压缩包里 v2 的「百分之十」。docx 里的「下周一开始联调」也能搜到。我另外做了一段 9 秒的合成画面,软字幕写着「字幕里写着:验收以确认单为准」,ffmpeg 适配器把这句也搜出来了。
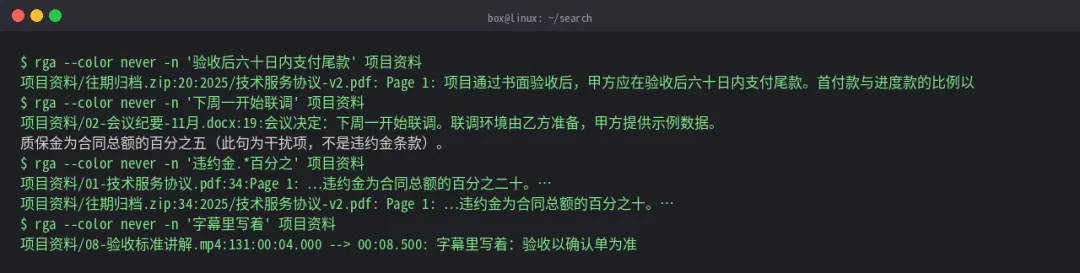
压缩包打出内部路径;docx、正则、视频软字幕也能命中
rga 默认会把抽出来的文本缓存到 sqlite 里,Linux 上默认目录是 ~/.cache/ripgrep-all。自定义路径必须写成 --rga-cache-path=/某个目录,中间不能换成空格,否则会直接报「requires a value but none was supplied」。
同一组 10 个文件:第一次 0.22 秒 / 56.6MB,第二次 0.05 秒 / 7.2MB;再换搜违约金那句,只要 0.01 秒,因为抽取已经做完。34 个文件的大批量目录(含一份更长的文字层附录 PDF)第一次 0.08 秒 / 47.6MB,第二次 0.01 秒 / 7.0MB,命中插在附录第 4 页的「接口冻结日期定为十二月一日」。
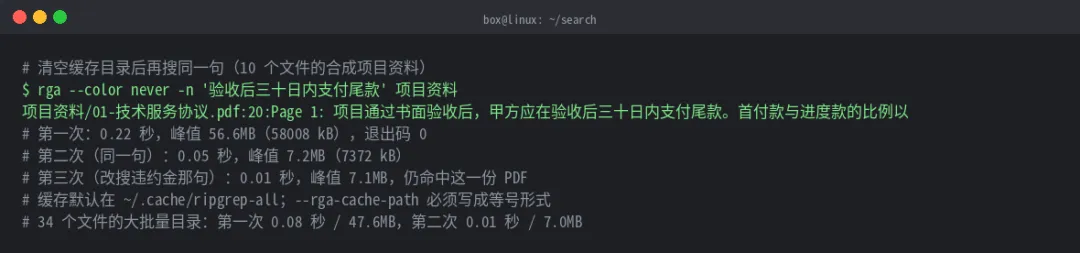
清空缓存后第一次 0.22 秒,第二次 0.05 秒,换一句只要 0.01 秒
扫描件是专门做来当反例的。我把那句验收条款画进图片,再导出成没有文字层的 PDF。页面上盖了「合成样例 无效」的章,看起来像一份签字页,但 pdftotext -layout 去掉换页符之后是 0 个字符。对这个文件单独跑 rga,退出码 1,0 命中,stderr 是空的,墙钟 0.05 秒,峰值 46.6MB——poppler 还是会走一遍,只是抽不出字。默认适配器列表里没有 tesseract。这不是扫描件 OCR 文,请不要把它理解成「拍照也能搜」。
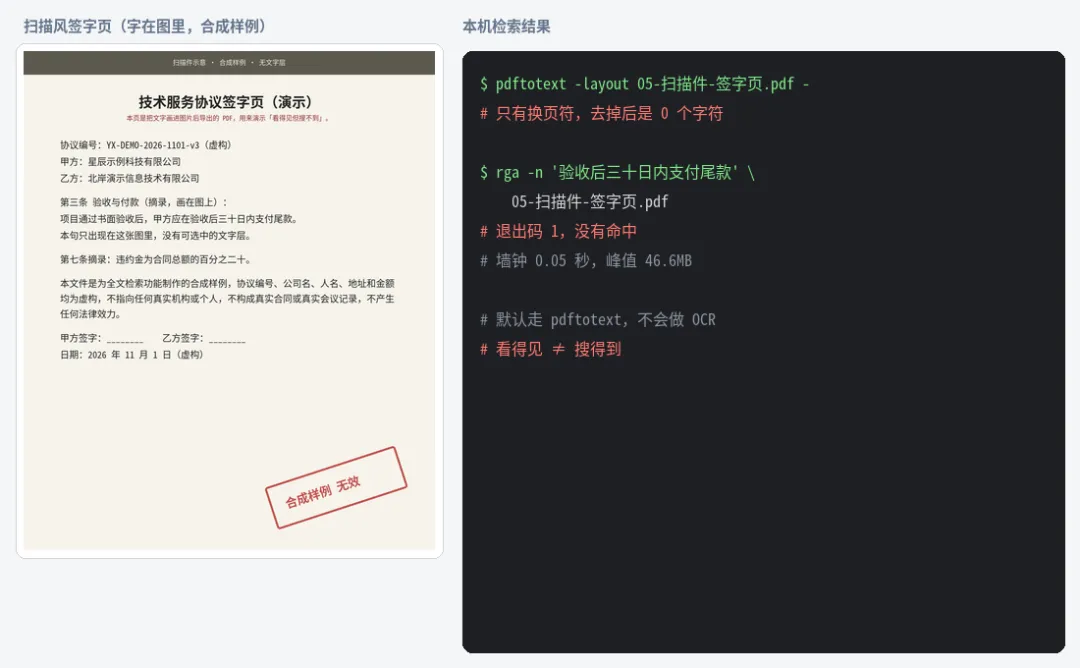
扫描风签字页看得见那句话,pdftotext 无文字层,rga 0 命中
五、限制与踩坑
·缺 pandoc 时,.docx 会失败。 我把 pandoc 移出 PATH,再搜「下周一开始联调」,退出码 2,0 命中,错误是 Could not find executable "pandoc"。装回去就恢复了。
·旧版 .doc 搜不到。 同一句在用 LibreOffice 另存的 .doc 里是 0 命中。适配器列表只有 .docx,没有 .doc。
·xlsx 默认搜不到。 报价表里明明有「尾款」这个列名,直接搜或加上 --rga-accurate 都是 0 命中。xlsx 不在 pandoc 适配器的扩展名里。
·加密 PDF 会把退出码变成 2。pdftotext 报 Incorrect password。哪怕目录里同时还有一份未加密、能命中的 PDF,那一行还是会打印,但命令整体仍是退出码 2,stderr 也比较长。
·只写在文件名里,不会被当成正文命中。 我放了一个文件名包含那句整句、正文却没有这句的 txt,搜整句是 0 命中。
·短关键词会扩大范围。 只搜「验收」,-l 列出了 8 个文件,纪要、需求、简介、视频字幕、压缩包都会进来。要找具体条款,还是用一整句更稳。
·不要用 `--rga-no-cache` 来「关掉缓存试试」。 在 0.10.10 上,我对那份文字层 PDF 加上这个开关,预处理报 No cache?,退出码 2,命中为 0。
·第一次建立空缓存时,我偶尔碰到过 `database is locked`。 那一次扫描件预处理失败,退出码 2,但协议 PDF 的命中行已经打印出来。随后 8 次同样的冷启动全部是退出码 0。再跑一遍通常就正常,不必一看到 2 就以为完全没搜。
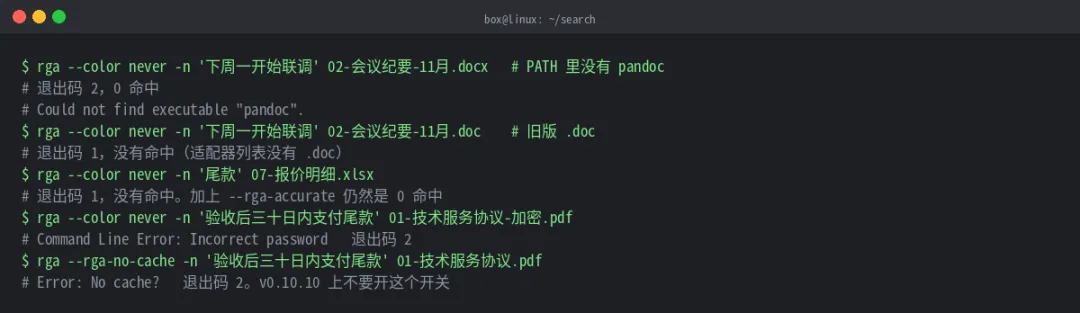
缺 pandoc、加密 PDF、xlsx、旧 .doc,以及不要使用 --rga-no-cache
六、一条可复制的命令,和一个小脚本
大多数时候,一条命令就够:
rga --color never -n '验收后三十日内支付尾款' ./项目资料 # 把 rga 和 rga-preproc 放在同一目录并加入 PATH # 搜 PDF 需要 pdftotext,搜 docx 需要 pandoc
如果想顺手检查依赖、并把命中写成一份 markdown 清单,可以用文末的 sousuo.py。它只调用官方 rga,不上传文件,也不使用 --rga-no-cache。本机实际跑通的输出是 1 行命中,和直接跑 rga 一致。
python3 sousuo.py '验收后三十日内支付尾款' ./项目资料 --out hits.md
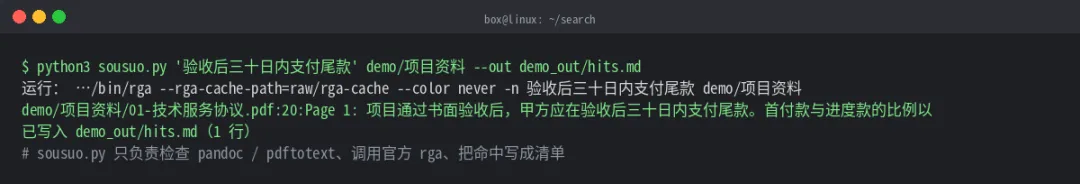
sousuo.py 调用官方 rga,写出 1 行命中清单
七、谁适合用
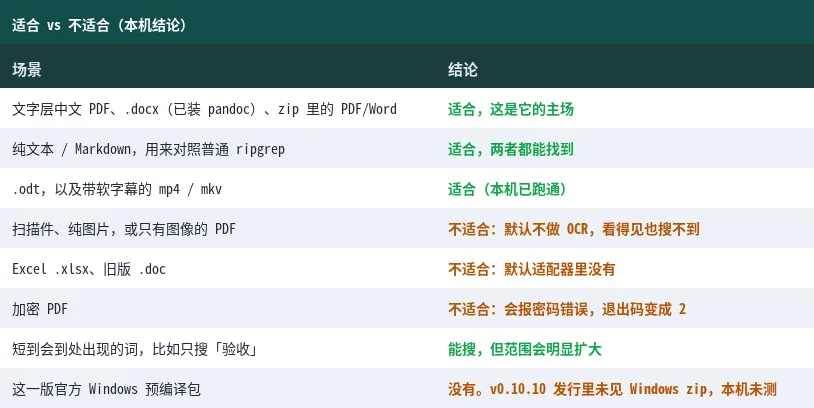
适合 vs 不适合(本机结论)
一句话:文字层的 PDF、Word 和压缩包,用 rga 可以在本机按句子搜;扫描件、xlsx 和旧版 .doc,默认还是搜不到。
你是卡在「一堆协议里找某一条款」,还是「手里只有扫描件」?留言说说,下次接着实跑。觉得有用,转给正在翻文件夹的那位。
AI 辅助创作:本文由 AI 辅助撰写。所有命令于 2026-11-18 在 8 核 Xeon、16GB、无显卡的 Debian 13 上用 rga 0.10.10 实际运行;截图、命中行、耗时和峰值内存为真实输出。文档均为合成样例,不是真实合同。项目:https://github.com/phiresky/ripgrep-all