ARTICLE · 1385921
复制就能用 22|网页存 PDF,怎么全是广告
复制就能用 · 第 22 期 · 不装东西 · 核验于 11 月 19 日 · 已在作者机器上验证
把本篇推送的链接地址直接复制给你的 WorkBuddy、豆包、Codex,或者任何一个能在你电脑上动手的 AI。它会自己读完、自己执行完,你不用再操作。
前提是电脑上装了桌面客户端。手机上它只能念一遍步骤,做不了。
他回了一句:怎么一半是广告
周一上午九点,领导在群里丢来一个链接:这篇政策解读转成 PDF 发我,十点开会要用。
你打开,Ctrl+P,目标选「另存为 PDF」,存到下载文件夹,发过去。
三分钟后他回一句:怎么一半是广告。
结论:顺序反过来——先让 AI 把正文抠出来,落成本地 HTML,再让浏览器打印这份 HTML。多这一步,广告没机会跟进来。
屏幕上看得见的,打印时也在
顶部导航、右侧推荐、右下角那个浮着的客服气泡、底部的相关阅读——你在屏幕上看得见,打印的时候它照样占位置。
有些站会为打印单独做一套样式,把导航藏起来。那是站方愿意,你没法指望每一篇都有。
存档要留下的是内容,不是那个网页。
存了三年资料,我受不了的三件事
分页。政策、年报、长评测,越正式的越爱分页。按 Ctrl+P 存下来只有你正看的那一页,回头再补,地址已经变了。
图片空框。存的那一刻看着好好的,翻回去是一排灰框——图是滚到才加载的,没滚到的地方打印出来就是空的。
找不到。下载文件夹里四十几个 PDF,名字是网页标题拼日期,一年后想找「那个讲补贴的」,只能一个个点开。
后来我改了顺序。慢一分钟,换来的是三年后还能搜、能复制、能发给别人。
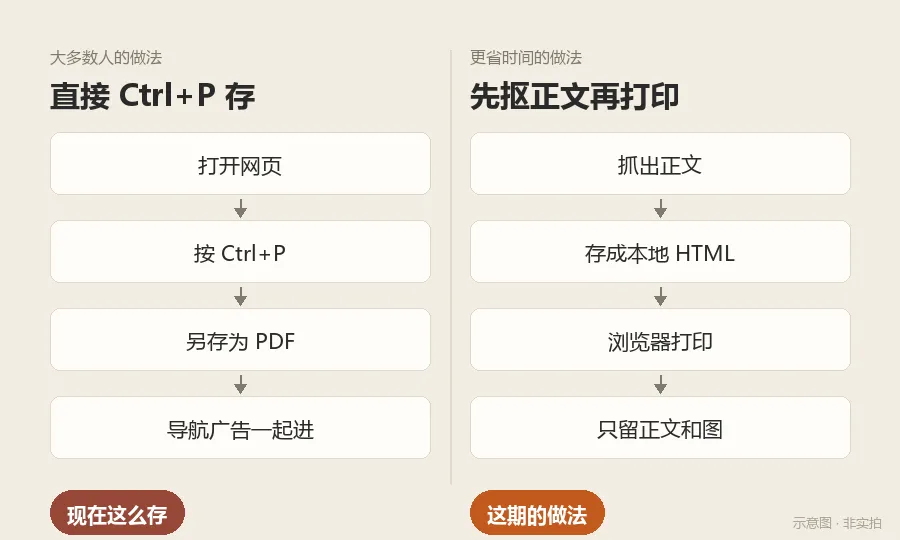
两边都叫「存成 PDF」。左边那一路,导航和广告是跟着页面一起进去的。
哪些东西进得去,哪些进不去
核验
动手前先确认三件事。这道活翻车,都翻在这三件上。
指令区
第 1 步:只读,先报三个数(AI 执行)
这一步不许生成任何文件。链接换成你要存的那一篇,不能照抄。
要紧的是最后那句。遇上登录墙、分页、懒加载,AI 默认跳过,报出来的数看着整齐,其实少了一截。
第 2 步:落成一个本地 HTML(AI 执行)
路径换成你自己的,D 盘没有就换 C 盘。文件名用文章标题,别用「未命名」。
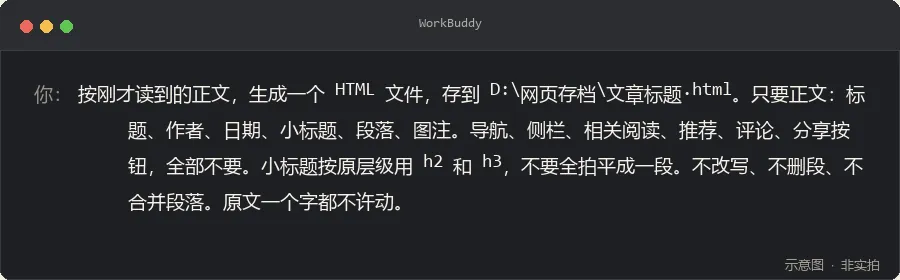
这段里的「原文一个字都不许动」是关键——不加这句,它会顺手替你改写正文。
最后一句是底线。它很喜欢「帮你优化表达」,一优化就不是原文了,存档的意义也没了。
第 3 步:图下到本地,地址改成相对路径(AI 执行)
省掉这步,图还是网上的地址。对方换域名、加防盗链,或者你断网,打开就是空白。
第 4 步:打印这一步你自己来(读者操作)
双击那个 HTML,用浏览器打开,等图全部显示出来,再按 Ctrl+P。
打印窗口里改四样:
打印机(目标)选「另存为 PDF」,不要选实体打印机 「更多设置」里的边距选「默认」或「无」,别让正文两边空掉一大块 勾上「背景图形」,不然表格底色和分隔线全丢 取消「页眉和页脚」,不然每页顶上多一行网址和日期
保存位置别用默认的下载文件夹。存到 D:\网页存档\,文件名带上日期,比如 政策解读-20261119.pdf。
各家浏览器叫法略有出入,以你那个版本里的文字为准。
验收
让它贴原始输出,不接受「已完成」三个字:
第 1 步那三个数,段落数、字数、图片张数,原样贴出来 打开 PDF,按 Ctrl+F,搜正文第三段里的一个词。搜得到,文字层还在;搜不到,是打成图了,回去重做 首页第一行应该是原文链接加抓取日期。再看最后两页有没有整页空白、有没有重复的页
第 2 条最要紧。文件生成了不等于能用,搜不到字,三年后还是废的。
想多一道保险,让它把产出列一遍:
有几种网页,存下来也是白费
没有安装,就没有卸载
产出就三样:一个 HTML、一个 images 文件夹、一份打印出来的 PDF,都在你指定的文件夹里,不想要了整个删掉,回到原样。
它读的是网上的页面,不是你硬盘里的文件,硬盘里的东西一个都没动。
位置留个心。别存到 C:\Windows 下面,也别扔在桌面根目录,单独开一个 D:\网页存档\,以后按日期找比在下载文件夹里翻快得多。
本篇已在作者机器上验证。核验于 11 月 19 日。
第一次别拿要发给客户的那份试。找一篇不长的文章跑一遍,先看 PDF 里能不能搜到字,再上真的。