ARTICLE · 1400668
别再给智能体塞文档了,该造一座「知识工厂」
LangChain创始人Harrison Chase最近把这层窗户纸挑明,并给了一个具体的解法名字——知识工厂(Knowledge Factory):不是往智能体嘴里塞文档,而是建一条流水线,把公司脑子里的隐性经验持续变成它能用的东西。
内容速览
一、上下文和知识,根本不是一回事 二、从软件工厂到知识工厂 三、知识的三块拼图 四、工厂的三块零件 五、一个完整的例子:智能体去做营收报告 六、结尾:让干活本身暴露知识缺口
三句话看懂它
痛点:要让AI在公司里真正跑起来,缺的不是更好的模型,也不只是更多上下文,而是更好的知识——关于公司怎么运作、有哪些运营标准、数据存在哪儿、怎么访问。这类知识此刻在最能干的员工脑子里,隐性、隐含、零散;手工整理它们是一份赫拉克勒斯式的苦活。
方法:建一座"知识工厂":收集、策展、维护这些知识的表征,并把它传给智能体。知识分三块——怎么做活儿(技能)、业务怎么跑(领域知识)、到哪里拿当前信息(数据访问指引);工厂有三块零件——让智能体在干活时标记缺失知识、后台按节奏跑的策展智能体、以及知识的存储(GitHub技能格式/Notion单文件/OKF格式/知识图谱都行,暂时别对格式过度规定)。
成绩:LangChain内部已经用几种方式建过:GTM(产品走向市场如推广/销售/营销等)智能体、内容工作室智能体都由知识工厂供能,LangSmith Engine(跑在轨迹上、给修复建议的智能体)为每个智能体各维护一个知识工厂。而最漂亮的一点是:这套机制不需要人类额外写文档——智能体在干活中标记问题,人类同步纠正,策展智能体当晚就把修正沉淀回技能。金句:
目标不是先把一切都写下来才让智能体开工,而是建一套系统,让干活暴露缺什么知识,补上缺口又让未来的活干得更好。
一、上下文和知识,根本不是一回事
先把两个词分开,这是整篇文章的地基:
上下文(Context),是智能体做某个任务时手边有的东西。
知识(Knowledge),是我们维护着的可复用理解,好让它把那个任务做对——某个指标到底什么意思、该信哪个数据源、遇到某种情况我们通常怎么处理。关键在于:这些有时写下来了,常常没有。
知识工厂做的,就是把零散的文档与经验,变成能成为未来工作上下文的知识。
所以知识确实是上下文的一种,智能体最终会拿到它;但它往往不是(也不该是)智能体拿到的唯一上下文。其他类型的上下文——比如每天都在变的原始数据——你已经能可靠地摄取和存储,直接给它就行,不必绕一圈变成"知识"。
这个区分很要紧,因为它顺带拆掉了一个常见误会:接了向量库、接了企业wiki,就以为"知识给到了"。检索能给你事实,但给不了判断——"我们为什么这么算ARR""这个口径跟财务那边对不上时以谁为准""这个客户为什么从不发外呼邮件",这些东西既不在向量索引里,也不该由谁临场猜。它们是有人维护着的理解。
为什么检索解决不了?因为知识往往没有关键词,只有情境。你没法用"ARR计算口径"这种词检索出"因为早期合同是按季度确认、后来财务改成按月摊销,所以和合同额的年化差一个系数"这条知识——它藏在一条决策记录、一场会议、一个人的脑子里,检索层根本不知道该用什么词去找它。
二、从软件工厂到知识工厂
过去一年半,"软件工厂(Software Factory)"这个说法突然流行起来。
它的意思是:最优秀的工程师不该亲手去写软件,而该去造那个"帮助全公司更高效地写软件"的系统——造软件这件事本身,交给智能体去做就行。人从"写代码的人"变成"造流水线的人"。
通用的知识工作正在走同一条路。
智能体今天已经够格做演示、发视频、做外呼了,这些活你该尽量让它们干。但要让它们真干成,缺的东西很具体:那些隐性、隐含、零散的知识。
这才是你该投钱的地方:把这些知识建出来,更重要的是,建出一套能持续收集、策展、维护它们的工厂。它才是让你能把更多知识工作外包给智能体的东西——没有工厂,每接入一个新智能体,你都得手工再喂一遍。
但知识工作比软件更难外包,原因也在这里。软件工厂能成立,是因为软件世界有相对稳定的工具链:编译器、测试框架、类型系统,行为是可预期的,所以造好流水线之后,剩下的交给智能体就顺理成章。而通用知识工作没有这样的地基——"做一份竞品分析""写一封客户跟进邮件""整理这次访谈的要点",每件事的评判标准都不完全一样,知识也更难被固定下来。正因为地基不稳,才更需要先把知识这块补上:知识稳了,剩下的执行环节才敢交出去。
三、知识的三块拼图
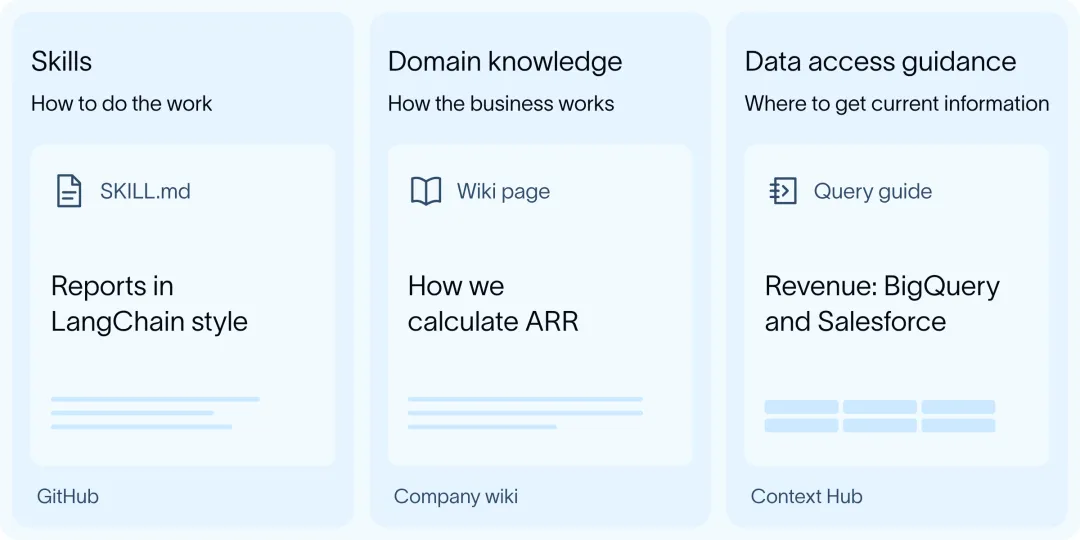
一般而言,你需要维护的知识有这么几块:
第一块:怎么做活儿——技能。
完成某项任务的程序、指令与脚本,按你们公司期望的方式去做。这里有个扎心的事实:很多时候这些流程此前根本没被写下来过,只是在同事之间口口相传,新人来了就带一遍,老员工离职就带走一批。你要做的第一件事,是把它们写下来。
第二块:业务怎么跑——领域知识。
关于产品、客户、竞争对手与组织的定义、政策与事实。它的特点是:不常过期。但它常常是不完整的、甚至干脆是错的——不是因为有人故意写错,而是因为这块知识量太大,没有人会去通读和维护。
第三块:到哪里拿当前信息——数据访问指引。
哪些源该用、数据住在哪儿、怎么查询它。
这三块里,最容易被忽略的是第三块背后的那件事:数据策略本身才是有用智能体的地基。如果你已经有 Snowflake、Databricks 这类像样的数据底座,而且数据的真相之源在那儿、完整且及时——那就不必再维护一份拷贝了。真正新的、值得你花力气维护的,是"数据住在哪、怎么查它"这份清晰的说明。
这三块的样子也完全不同。技能是可执行的:一份带步骤和脚本的规程,别人照着做能得到同样结果。领域知识是叙述性的:产品怎么定位、目标客群是谁、竞品格局什么样、定价为什么这么定——它更像一篇能不断修订的长文。数据访问指引则是查询片段:哪个库是订单的真相之源、哪张表是活跃用户、怎样写才不会把整张表扫一遍。产出形态不同,维护的人也该不同。
尤其要警惕"错的知识"而不是"没有的知识"。缺失的知识会让智能体停下来问一句;错误的知识会让它自信地做错事,还顺手引用你的文档当依据。而领域知识恰恰最容易错——因为它量太大、变化太慢,没有人会去通读一遍纠正一遍,于是过期的事实安静地躺在 wiki 里好几年。
为什么这三块不能互相替代?因为它们的更新节奏完全不同:技能跟着流程演进而变(组织调整一次就要改);领域知识相对稳定(但需要定期校对);数据访问指引跟着技术栈走(一次数据平台迁移就得重写)。把它们混成一大坨文档,维护成本会指数上升。分清这三块,你才知道每次该改哪一处。
四、工厂的三块零件
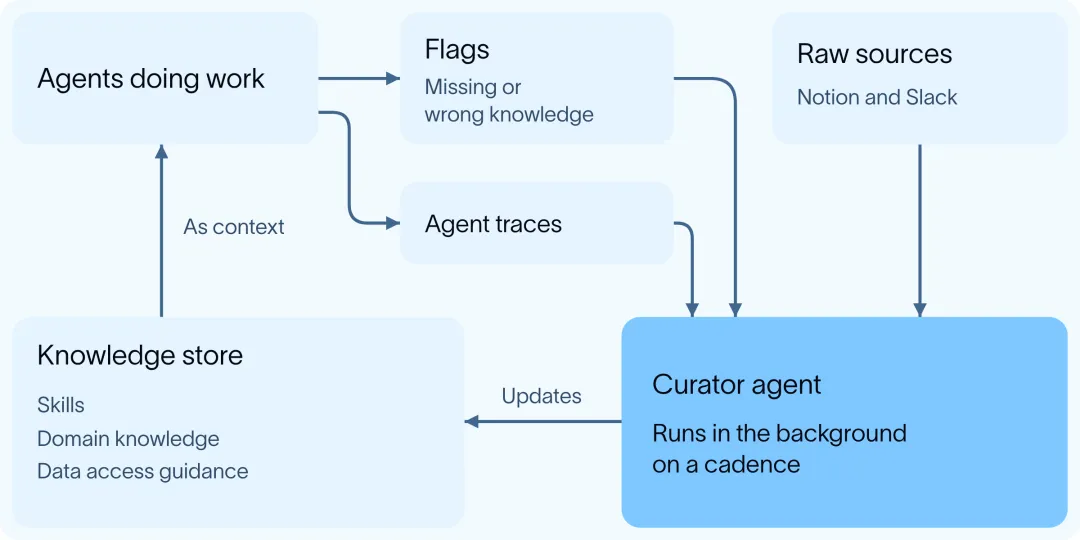
上面这些信息都是有用智能体所必需的。但别想着手工维护它们——那是一份赫拉克勒斯式的苦活。你要做的是一个替你维护它们的系统。
零件一:让智能体标记缺失知识。
发现缺了哪块知识,最好的办法就是让正在干活的智能体自己标记。如果它被要求做某件事,却找不到信息、或者发现找到的信息是错的——它就该标记!给它一个工具,至少能报告"哪里不对",可选地还能建议正确的修改。
这里有个很漂亮的分工:标记是廉价的,修复是昂贵的。正在干活的那个智能体,是全世界最清楚"这里缺了什么"的人——它刚刚卡在这儿。所以把最便宜的观测动作交给它,把最贵的修复动作留给下面那个角色。
工具设计上也有讲究:这个上报工具至少要能说清"哪里不对"(哪个文件、哪条规则、哪个数字对不上),最好还能附上正确的修改建议。但整条上报路径必须便宜到不值得优化——因为它会被高频触发,一旦变慢或变贵,干活的智能体就会绕过它。于是工厂就有了一个持续的信号流:哪里老是出问题,哪里就要修。
零件二:策展智能体。
这是整座工厂的核心:也是一个在后台按某种节奏运行的智能体,负责更新、策展、维护这些知识。
为什么不让"使用知识的那些智能体"顺带维护?因为它们主要忙着完成自己的目标——帮队友答题对我没好处,所以它们不会去维护;帮队友干活能帮自己拿奖励,所以它们会卷。更关键的是:标记和修复需要的能力根本不同。发现"这个数字不对"靠的是现场感;而修好它,需要对底层知识和其他数据源的深入理解——这块知识可能同时散落在 Notion、Slack、几张表和某人的脑子里。
所以让使用型智能体去维护,结果是知识变得失控且充满矛盾。
它按什么节奏跑?按天或按周都行,取决于知识的变动速度——技能随组织调整变,领域知识按季度校对,数据访问指引跟着数据平台迁移走。频率定得太高,它会在同一件小事上反复打转;定得太低,缺口会攒很久。
那要不要人来把关?至少一开始要。策展智能体改的是全公司智能体共享的知识,一处改错,错误会被所有下游放大。务实的做法是:让策展智能体把改动做成可对比的差异,人只需要扫一眼、点确认。跑顺了再考虑放开。
那策展智能体需要什么?三样东西:
所有原始数据源(Notion、Slack之类),因为知识可能散落在那里; 智能体的轨迹——从而看出人们是怎么用这些智能体的,并把这些用法沉淀成技能(这一条最容易被忽略,却可能最有价值:轨迹里全是真实用法); 智能体标记出来的那些问题。
零件三:知识的存储。
有意思的是,Harrison Chase对这件事给了两个相反的评价。
"某种意义上,这其实是最不重要的一件事。"你可以把它存成技能格式放在GitHub、放在 Notion的单个文件里、用OKF格式存进LangSmith Context Hub、或者作为Neo4j 里的知识图谱——策展智能体该知道怎么跟这些格式打交道,而这并不难。
"但换个角度看,它又是最少被探索的领域。"记忆该怎么表示?作为行业,我们已经在"程序性记忆"上收敛到了技能;而对语义记忆,大概会冒出另一个标准(OKF?)。现在还早,尚无标准成型——所以最好别对格式过度规定,也别把它搞得过于复杂。
给工程师的实操结论很简单:先选团队已经在用的那个工具。别为了"将来能换"而设计一个自造格式——知识格式的迁移成本,永远比你想的高。具体些:技能这类需要评审和回滚的东西,适合放在GitHub(天然有版本、有评审、能回滚);叙述性的领域知识,Notion里的长文更顺手;需要分发给外部智能体的知识包,用OKF这类格式放进 Context Hub;关系密到要用图查询的知识,才值得上Neo4j。
最后一句必须说的风险:知识工厂也会把错误规模化。手工整理的知识错了,影响范围是一个房间;工厂里的知识错了,影响范围是所有接了这个智能体的人。所以版本、回滚、以及"每条知识能追溯到来源"这三件事,不是锦上添花,是这套系统的安全带。
五、一个完整的例子:智能体去做营收报告
讲一个端到端的例子,把上面三块拼图落地。
第一层是基础上下文:原始的营收数字,存在BigQuery和Salesforce里。这层是"事实",直接取就行。
第二层是知识,分三类:
技能:怎么做一份符合 LangChain 风格的报告。这些存在 GitHub,用标准的技能格式。 长周期知识:我们到底怎么计算ARR。这存在公司wiki里。 怎么访问快速变化的知识:怎么去 BigQuery 和 Salesforce 里取那些原始数据。这些同样以技能的形式存在,只是这次存在Context Hub里。
然后智能体跑起来了。
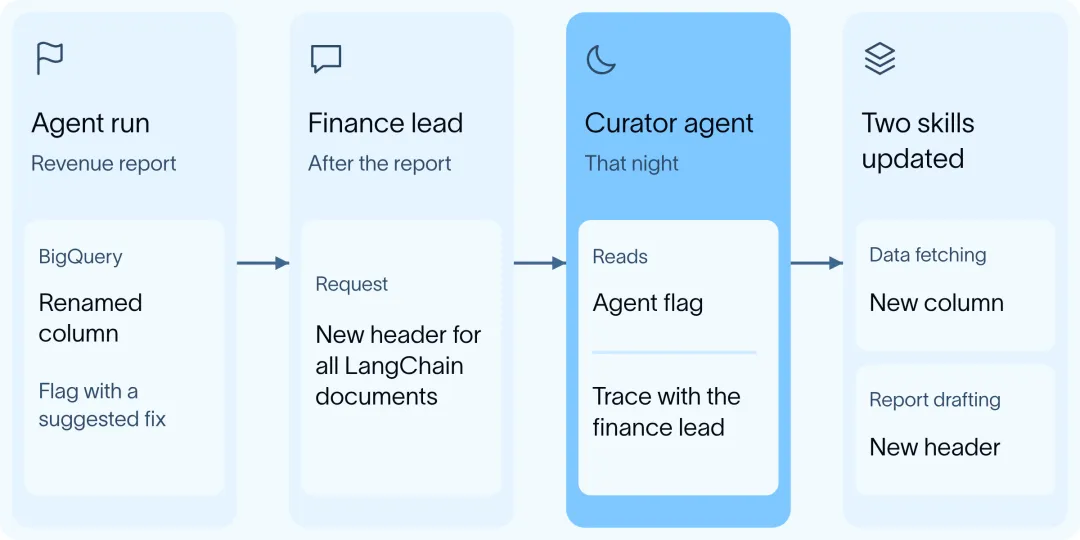
也许它注意到我们在 BigQuery 里重命名过某个列。它自己判断出了正确的列该是哪个,用它那个"报告问题"的工具把这件事标记出来,顺手建议了正确的列名。
报告做完之后,公司的财务负责人跟智能体同步工作了一会儿,修了几个格式问题——其中包括告诉它:今后所有 LangChain 的文档都要用一个新的表头。
当晚,策展智能体看到了那个被标记的问题。它同时翻查了智能体的轨迹,注意到了与财务负责人的这番来回。于是它相应地更新了相关技能——取数时用新列,写报告时用新表头。
回头看这一晚发生了什么,值得停下来想三秒:
没有任何一个人被要求去写文档。知识被更新了,是因为有人在干活、有人纠正、有人在后台把这事收进了技能里。这正是"工厂"和"文档库"的区别——文档库要人去养,工厂自己会转。
而这一晚最珍贵的输入,其实是财务负责人的那句"以后用新表头"。它是典型的隐性知识:不是写在任何流程文档里的规定,而是人在现场纠正里传递的一句话。如果轨迹里没有留下这番来回,这句话就随会散了——而策展智能体正是通过轨迹把它捞了回来。所以"轨迹"在整套设计里不是附属的日志,它是隐性知识唯一的抢救通道。
六、结尾:让干活本身暴露知识缺口
Harrison Chase收尾那句话很值得贴在墙上:
"目标不是先把一切都写下来,才让智能体开始干活。目标是建一套系统:干活本身会暴露缺什么知识,补上这些缺口又让未来的活干得更好。"
所以起点非常低,也非常具体:从一条重复出现的工作流开始,看智能体在哪里卡住,然后把这个闭环闭上。
别一上来就想着"我们要把公司的知识都整理一遍"——那是永远做不完的工程,会在第三个月死掉。正确姿势是:让一条高频工作流先跑起来,让它自己告诉你缺什么,然后让工厂替你把缺口填上。一周之后你手上就有一条能自转的产线,而不是一份没人维护的文档。
如果要今天就开始,三个动作就够:
挑一条每天都重复的工作流(比如月度报告、客服回复、投放复盘),别挑最复杂的,挑最频繁的; 给跑这条流程的智能体一个"上报问题"的工具,让它把卡壳的地方报出来; 定期跑一次策展,把它的改动做成可对比的差异,你只负责点头。
顺便记三条反模式:别一上来做全量知识梳理(做不完,第三个月就死);别让智能体自助修改共享知识(它会失控且自相矛盾);别过早追求统一格式(现在还没标准,复杂化只会拖慢你)。
LangChain已经把这套东西建在了自己公司里(用组件化的方式搭起公司自己的harness),也在和若干客户一起把它落到他们的智能体上——内部的有,外部的也有。
参考资料
LangChain的博客:How to build a knowledge factory for AI agents https://www.langchain.com/blog/knowledge-factory LangChain的博客:Context engineering for agents https://www.langchain.com/blog/context-engineering-for-agents LangChain的博客:How we built LangChain's GTM agent https://www.langchain.com/blog/how-we-built-langchains-gtm-agent LangChain的博客:Introducing Context Hub https://www.langchain.com/blog/introducing-context-hub LangChain的文档:Deep Agents Skill格式 https://docs.langchain.com/oss/python/deepagents/skills Open Knowledge Format(OKF) https://github.com/open-knowledge-format/open-knowledge-format LangSmith-可观测性(智能体轨迹) https://www.langchain.com/langsmith/observability