 夜雨聆风
数据中心正在变天。
过去,它是存数据、查数据、算数据的地方;现在,生成式 AI 与代理 AI 崛起,数据中心已经变成了AI Token 工厂。
核心任务变了 —— 从传统计算,变成了 AI 推理;核心产出变了 —— 从数据结果,变成了以 Token 为单位的 “智能”。
一套新的成本逻辑,必须跟上。
一、别再被 “算力指标” 骗了
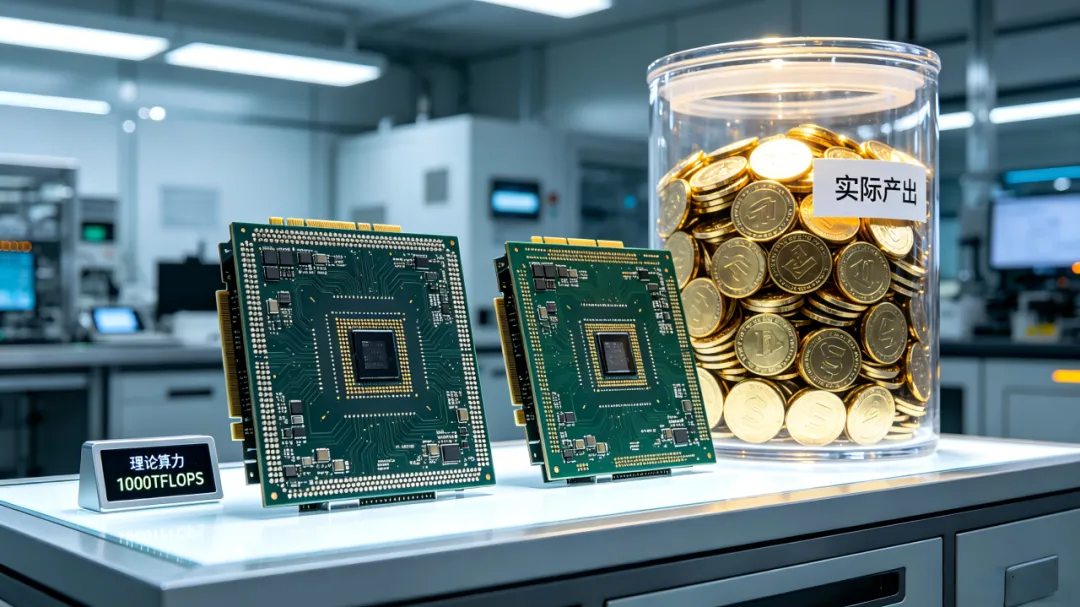
现在很多企业评估 AI 基建,还在盯着这三件事:
这块 GPU 多少钱一小时
峰值算力多强、显存多大
每美元能买到多少 FLOPS
但这些全是投入指标,不是产出指标。
你买的是原始算力,不是真实可用的 Token。只优化投入,不看产出,就是典型的 “方向错了,越努力越亏”。
二、AI 时代唯一重要的指标:每 Token 成本
什么是每 Token 成本?
简单说:生成并交付 100 万 Token,到底花多少钱。
它才是真正的 AI TCO(总体拥有成本)。
因为它一次性把这些东西全算进去:
硬件性能
软件优化
系统利用率
生态支持
一句话:每 Token 成本,直接决定 AI 能不能规模化赚钱。
三、看懂这个公式,你就懂 AI 成本经济学
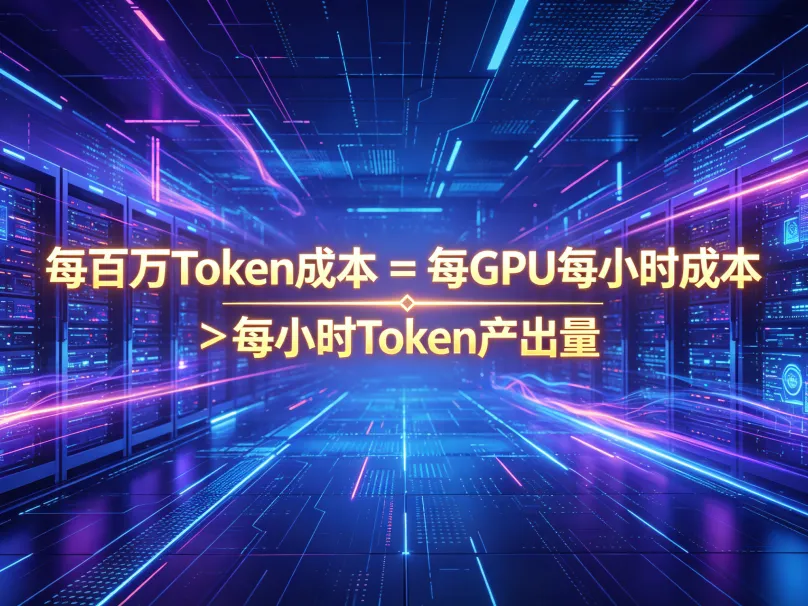
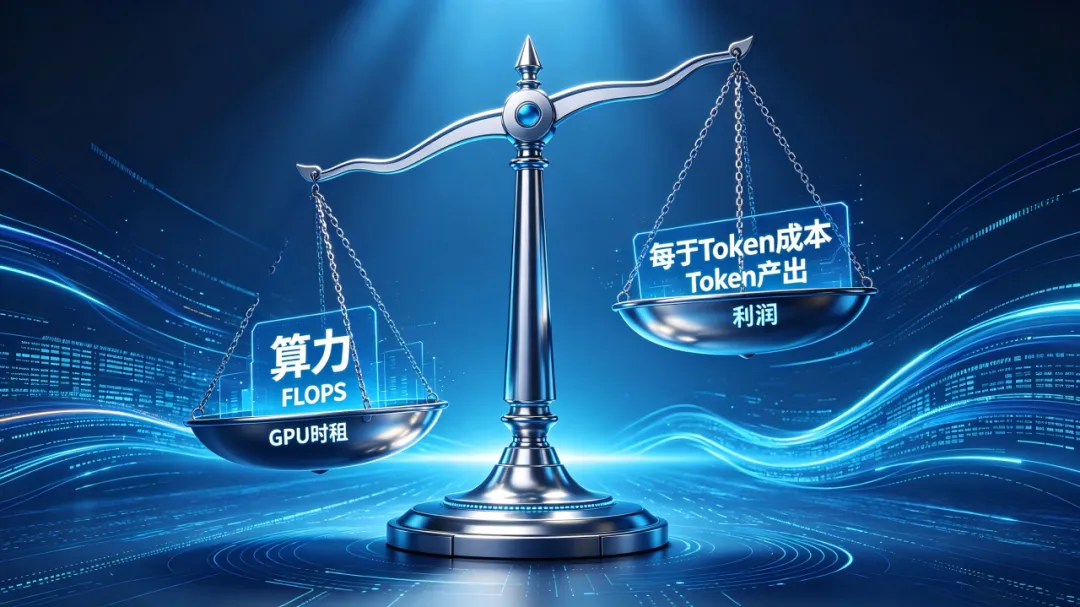
每百万 Token 成本 = 每 GPU 每小时成本 ÷ 每小时 Token 产出量。
90% 的人,只盯着分子(GPU 时租)。
但真正决定成本高低的,是分母(每小时能出多少 Token)。
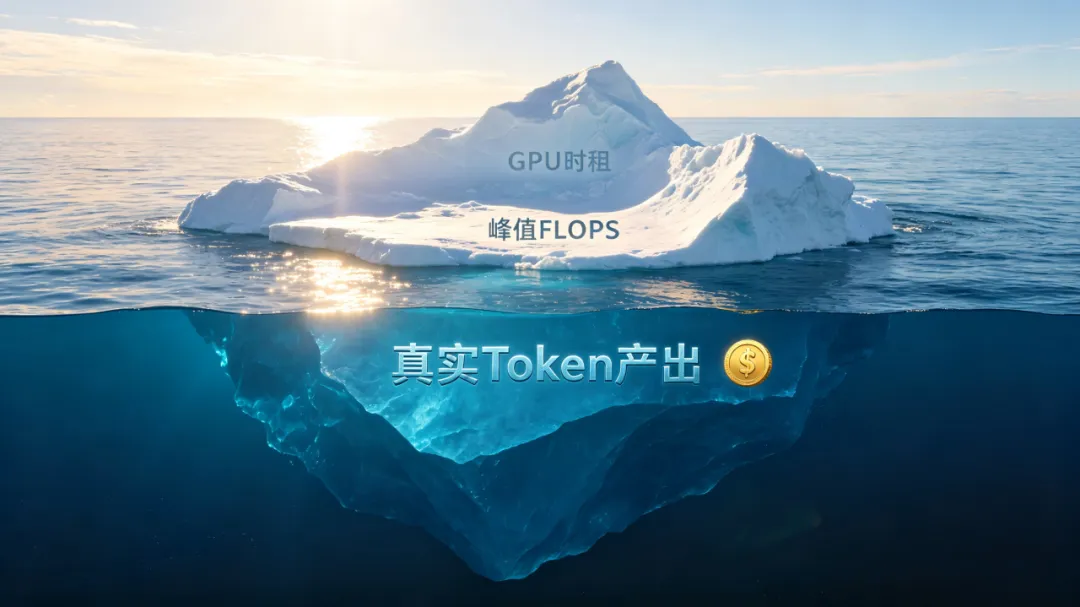
这就像一座 “推理冰山”:
水面上:GPU 时租、峰值 FLOPS,一眼可见
水面下:真实 Token 产出,才是利润关键
分母越大,成本越低,收入越高:
同样电费、同样机架,出更多智能
同样交互,赚更高毛利
四、别只看表面便宜,要看 “谁更能出量”
一块看起来 “更便宜” 的 GPU,如果每秒出 Token 很少,最终每 Token 成本反而更高。
决定分母大小的关键能力:
支持 MoE 大模型高效通信
支持 FP4 精度,又不丢效果
每美元能买到多少 FLOPS
KV 缓存优化、解耦服务、智能路由
适配代理 AI:低延迟、高吞吐、长序列
训练→微调→推理全栈通用
只有全栈打通优化,各项能力互相放大,分母才能拉到最大。
五、真实数据打脸:理论算力 vs 实际产出
拿 DeepSeek-R1 模型实测一看,差距惊人:
从算力成本看:Blackwell 平台成本≈Hopper 的 2 倍
从每美元 FLOPS 看:Blackwell 优势≈2 倍
从真实 Token 产出看:Blackwell 每瓦 Token 量是 Hopper 的 50 倍 +
每百万 Token 成本,降到 Hopper 的 1/35
投入只多了一点,产出直接数量级跃升。
这就是推理经济学的力量。
六、选 AI 基础设施,只看一件事
不要再用 “便宜 GPU”“高 FLOPS” 做决策。
正确标准只有两个:
1.每百万 Token 成本是多少
2.每兆瓦电能能出多少 Token
谁能把这两个做到最低,谁就是 AI 时代的最优基建。
目前业内,NVIDIA 通过全栈协同设计,把每 Token 成本做到了行业最低。
加上 TensorRT-LLM、vLLM、SGLang 等软件持续优化,部署后成本还能继续往下掉。
包括 CoreWeave、Nebius、Nscale、Together AI 等云厂商,已经基于 Blackwell 搭建出当前业界最低成本的 AI 推理服务,让企业直接用上最优全栈能力。
总结
AI 基建的考核标准,已经彻底切换。
从比算力,变成比产出;从看 FLOPS,变成算每 Token 成本。
抓住这个核心,才能真正把 AI 从成本中心,变成利润中心。