夜雨聆风
这两年,越来越多人开始把AI“搬回家”。
原因很简单。
云端AI确实方便,但问题也很现实:
数据要上传。 长期调用越来越贵。 高峰期还会卡。 有些敏感内容,根本不敢丢到第三方平台。
于是,“本地部署AI”这件事,突然火了。
很多人一听本地部署,就觉得很黑客、很极客、很难。
其实没那么夸张。
现在的大模型生态,已经卷到“普通人也能搭”的程度了。真正难的,反而是第一次下手时的信息混乱。
今天这篇,就把整个流程一次讲透。从硬件、环境,到模型部署、插件接入、优化避坑,尽量用人话讲明白。
一、先别急着装模型,先看看你电脑扛不扛得住
很多人第一步就错了。
看到教程,上来直接装模型。结果:
显存炸了 CUDA报错 推理速度像PPT 风扇转得像起飞
然后开始怀疑人生。
所以第一件事,是先确认硬件。
1. 显卡:决定你AI跑得爽不爽
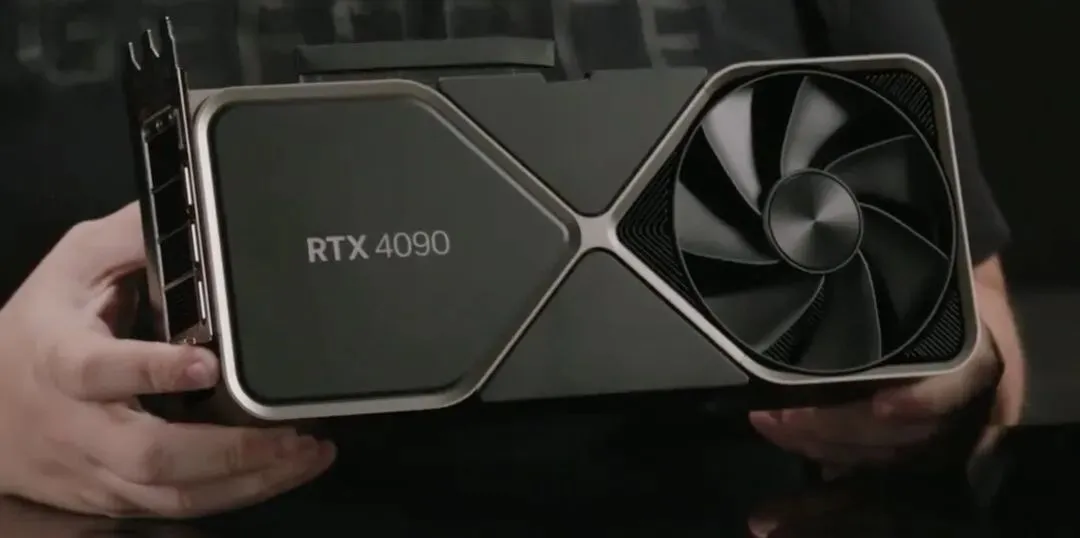
现在做本地AI,核心就是GPU。
没有独显?那基本等于“体验版”。
目前比较主流的选择:
为什么大家疯狂吹 4090?因为24GB显存真的太香了。
很多70B模型,量化后都能勉强跑。
一句话:
显存比算力更重要。
2. 内存:别低估AI吃内存的能力
很多人只看显卡。
结果模型加载到一半:
“内存不足。”
现在比较舒服的配置:
32GB:能玩 64GB:比较稳 128GB:真正舒服
尤其你如果同时:
开浏览器 跑 Docker 开向量数据库 跑多个 Agent
内存会像流水一样消失。
真的。
3. 存储:SSD是底线
现在一个模型动不动几十GB。
你还用机械硬盘?
那读取速度能把你急死。
建议:
系统盘:NVMe SSD 模型盘:至少2TB
因为你后面会发现:
下载模型,比下载游戏还上头。
二、环境搭建:最容易把人劝退的一步
说实话。
本地部署最恶心的,不是模型。
是环境。
尤其第一次装CUDA的人。
版本冲突能让你怀疑自己是不是学了假计算机。
1. Docker:建议必须装
为什么?
因为它能避免:
“昨天还能跑,今天突然炸了。”
Docker本质上,就是把环境封装起来。
推荐组合:
Docker Docker Compose NVIDIA Container Toolkit
后面很多 AI 工具:
Ollama Open WebUI ComfyUI AnythingLLM
都能直接Docker一键启动。
省事太多了。
2. CUDA:版本千万别乱装
AI 圈最经典问题:
“为什么我GPU识别不到?”
十有八九,CUDA版本不兼容。
一定记住:
显卡驱动 CUDA PyTorch
三者必须对应。
别看到新版本就无脑升级。
很多教程翻车,就是因为作者环境跟你不一样。
3. PyTorch:AI世界的“水电煤”
大部分模型都基于它。
安装时一定看官方对应命令。
别网上复制一堆“万能代码”。
AI领域不存在真正万能。
三、模型部署:以 Llama 3 为例
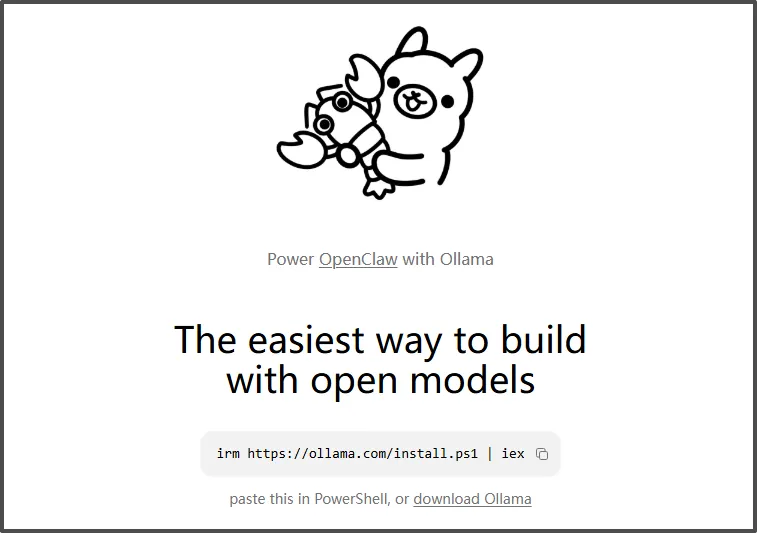
现在最适合新手的方案,其实是:Ollama
因为真的简单到有点离谱。
安装完成后,一条命令:
ollama run llama3
模型就开始自动下载。
下载完直接聊天。
很多人第一次看到本地模型跑起来,会有一种:
“卧槽,我电脑里真住了个AI。”
的感觉。
如果你想部署更大的模型?
那就得:
量化 多GPU 分层加载 推理框架优化
否则显存根本不够。
现在主流量化:
量化的本质:
用更少显存,换一点点性能损失。
对大部分人来说,非常值。
四、本地AI怎么接入日常工具?
这才是重点。
很多人部署完模型后发现:
然后呢?
总不能天天开终端聊天吧。
1. 接入 WPS / Office
现在很多插件已经支持:
本地 API OpenAI兼容接口
也就是说:
你本地模型,可以直接:
写文档 润色内容 总结会议 自动生成PPT
而且数据不出本地。
这点对企业非常重要。
2. 接入 Notion
现在不少人喜欢:
“本地AI + 私人知识库”
比如:
把笔记喂给模型 建立RAG知识库 私人问答系统
效果其实已经很接近“个人AI助理”。
尤其适合:
写作 研究 内容创作 企业知识管理
五、优化技巧:让你的AI别跑成老牛
很多人觉得:
“我4090怎么还卡?”
因为AI不只是拼显卡。
1. 量化一定要学
真的能省很多显存。
尤其4bit。
很多原本跑不了的模型,突然就能跑了。
2. GPU加速别忘开
很多工具默认:
CPU推理。
结果速度慢得离谱。
一定确认:
CUDA是否启用 GPU是否识别 推理是否走显卡
否则你的4090,可能正在旁边“看戏”。
3. 别迷信超大模型
很多7B模型,已经够用了。
尤其中文场景。
有时候:
70B ≠ 实际体验提升10倍。
但显存占用,可能真能翻10倍。
六、本地部署 vs 云端AI,到底怎么选?
这是很多人纠结的问题。
云端优点
开箱即用 不折腾 模型更新快
缺点也明显:
数据隐私问题 长期成本高 API限制多
本地部署优点
数据完全本地 可控性极强 不怕平台封接口 长期成本更低
缺点也现实:
硬件贵 配环境头疼 学习成本高
说白了:
云端像租房,本地像买房。
一个省心。
一个自由。
1. CUDA版本乱套
这是最常见的。
建议:别追最新版。
稳定最重要。
2. 显存不够硬跑大模型
结果:
爆内存 卡死 蓝屏
别跟硬件较劲。
3. Docker没开GPU权限
最后模型全在CPU跑。
风扇狂转。
速度像老年机。
很多人甚至没发现。
4. 下载模型下错格式
GGUF、GPTQ、AWQ……
新手第一次看,像天书。
简单理解:
不同推理框架,用不同格式。
先确认工具,再下载模型。
别几十GB白下。
最后说几句
本地AI这件事,本质上已经不是“能不能玩”。
是你愿不愿意真正拥有自己的AI能力。
它可能不会立刻替代云端。
但在未来,会成为很多人的“标配”。
尤其当AI开始进入工作流、知识库、办公系统之后。
你会发现,真正值钱的,不只是模型本身。
是你能不能把它留在自己手里。
往期推荐
扫描下方二维码进入社群,关注更多精彩。