 夜雨聆风
读这本书读到第 28 章——我心里咯噔一下。
前面 27 章——作者一直在拆解 Claude Code 的精妙设计—— 我读到这里——已经把 Claude Code 当成"AI 工程的标杆"。
第 28 章作者突然换了语气——
"一本严肃的技术分析不能只讲'它做对了什么'——还必须客观审视'它在哪里做得不够好'。"
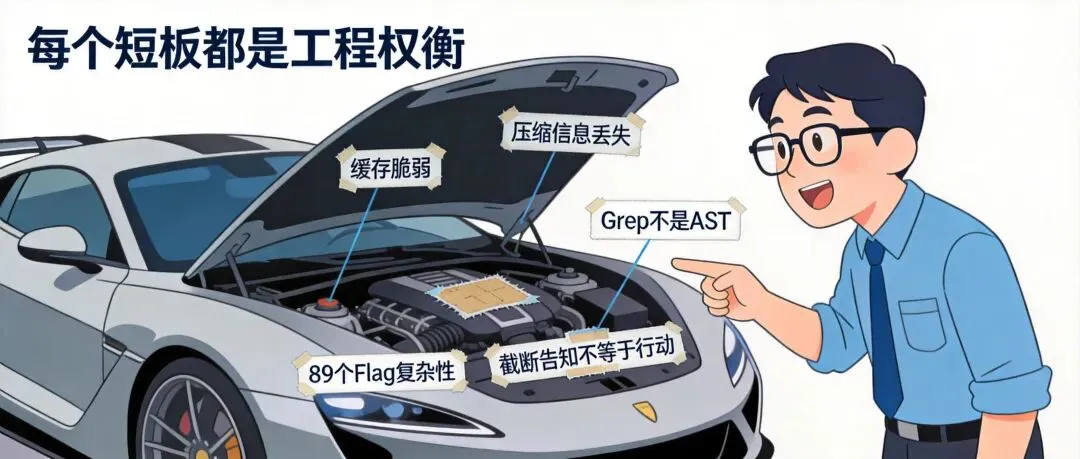
然后他直接列出——Claude Code 的 5 个明显短板。
我读完之后对这本书更敬佩了——
敢说自己分析对象的不足——这才是真正的技术写作。
短板 1:缓存脆弱性——分散注入点的隐患
整本书前面花了好几章讲 Claude Code 怎么把 prompt cache 用得淋漓尽致—— 读到第 28 章你才知道——这套缓存系统其实很脆弱。
为啥?
缓存依赖的核心假设是——SYSTEM_PROMPT_DYNAMIC_BOUNDARY 之前的内容会话中保持不变。
但是——多个分散的注入点都能修改这个区域:
systemPromptSections.ts 的条件性段落 MCP 连接/断开触发的 DANGEROUS_uncachedSystemPromptSection() 工具列表变化导致 Schema 哈希改变 GrowthBook Flag 切换的实时配置变更
任何一处出错——整个系统提示词缓存击穿。
第 14 章讲过的"缓存中断检测系统"—— 追踪近 20 个字段——
它的存在本身就证明缓存不稳定——
如果缓存稳定——根本不需要这套检测系统。
这不是 bug——是工程权衡。
如果集中所有提示词构建(单一中心函数)——缓存稳定但灵活性差 现状的分散注入——灵活但脆弱 Claude Code 选择了"灵活"——代价是要花精力维护检测系统
短板 2:压缩信息丢失——摘要无法保留完整推理
第 9 章讲过自动压缩——9 段结构化模板把对话压成摘要——很精妙。
但第 28 章告诉你——压缩比可达 7:1。
什么意思?
70 万 token 的对话——压缩后 10 万 token 的摘要——
60 万 token 的细节没了。
具体丢失:
失败的方法——只保留"最终方案 B"——方法 A 失败的经验丢了 决策上下文——为啥选 B 不选 A 的推理被简化为结论 精确引用——文件路径和行号被泛化为功能描述
这意味着什么?
长会话中的 AI 会"重复犯错"——
第 30 轮你试了方案 A 失败—— 压缩后摘要只剩"用方案 B 解决了"—— 第 80 轮你又遇到类似问题—— AI 不知道方案 A 失败过——它再推荐方案 A
这是不可避免的代价——
如果不压缩——长会话上下文炸 压缩 → 必然丢信息
Anthropic 的折中——保留"成功方案 + 关键事实"——丢"失败经验 + 推理过程"。
对错误恢复友好——但对长期学习不友好。
短板 3:Grep 不是 AST——文本搜索的语义盲区
第三个让我意外的短板——
Claude Code 的代码搜索完全靠 Grep——没有 AST 能力。
什么意思? 你让 AI"找出 loadConfig 函数被哪些地方调用"——
Grep loadConfig —— 能找到字面匹配 但找不到: 动态导入:require(variableName) 中的 loadConfig 引用 Re-export:export { default as Foo } from './bar' 的链路 字符串注册:name: 'loadConfig' 这种值 TypeScript 类型推断:隐式类型无法反向查询
Grep 是"字面匹配"——不是"语义匹配"。
更扎心的——Claude Code 自己 40+ 个工具——但没有 AST 查询工具。 搜索 feature('KAIROS') 能找到使用点——
但搜索函数 feature 返回所有 89 个 Flag——噪音巨大。
这是工程权衡:
AST 工具需要 LSP 或语言特定解析器——外部依赖 Claude Code 选择"零外部依赖、跨语言通用"——牺牲语义能力
改进方向作者也给了——通过 MCP 服务器接入 LSP—— 社区已经有 TypeScript 和 Python LSP 的 MCP 集成。
短板 4:告知不等于行动——大结果预览的隐形成本
第四个让我笑出声但又服气的短板。
第 12 章讲过——工具结果超 50K 字符——完整内容写磁盘——返回预览。 源码注释自豪地说"告知而非隐藏"——
用户被告知截断发生了,能主动读完整内容。
但第 28 章戳穿了一个事实——
模型可能不会重新读取。
什么意思?
模型基于预览做判断 如果预览"看起来够用"——它就不会主动 Read 完整内容 但关键信息可能恰好在截断点之后
根本原因——注意力经济。
模型的"注意力预算"是有限的——
已经看到预览——大脑里有了"印象" 主动 Read 完整内容——又是一次工具调用——成本 性价比衡量后——多数情况选择不调
告知 ≠ 行动——
这是 AI 应用的一个永恒难题。
改进方向:
结构化预览(摘要、匹配总数、文件分布) 相关性提示(建议何时查看完整) 自动分页(让模型按需继续)
短板 5:89 个 Flag 的组合爆炸——打地鼠模式
最后一个短板让我重新理解前面读过的"89 个 Feature Flag"。
数学上——89 个二值 Flag 理论上产生 2^89 种组合。 即使只有 10% 的 Flag 之间有交互——组合空间也难以管理。
具体例子:
promptCacheBreakDetection.ts 中三个字段都注有——
"should NOT break cache anymore"——"Tracked to verify the fix"。
典型的"打地鼠"模式——
没有系统性解决 Flag 交互问题 逐个修复曝露出来的案例 修一个 Flag 交互——下次又出新的
这是 A/B 测试文化的代价——
89 个 Flag 让 Anthropic 能快速实验 但代价是 Flag 交互的复杂度爆炸
改进方向:
Flag 依赖图显式声明 互斥约束声明 关键组合的自动化测试(至少两两组合) 调试模式下的 Flag 状态可视化
"权衡而非错误"——成熟工程师的视角
第 28 章最让我服气的部分——是作者对这些不足的态度。
每一个不足——他都强调对应一个工程权衡:
关键论断——
"理解这些权衡比单纯批评不足更有价值。"
这句话让我反思自己——
我以前看其他工具的"短板"——总习惯性"嘲讽":
"他们居然没做 X" "他们这个设计太菜了" "明显该用 Y 啊"
读完这一章我意识到——
几乎所有"明显的不足"——背后都是"明显的取舍"。
没人是傻子——不做 X 一定是因为做了 X 会破坏 Y。
这本书的成熟视角——给所有技术写作的启示
整本书读到 28 章——我对它的敬意又上了一个台阶。
它不是 Claude Code 的吹捧文集——
它是 Claude Code 的工程剖析报告——优点和缺点都拆开来看。
这种态度——很难得。
我读过太多技术书——
"X 公司的 Y 系统多牛——你也应该这样" "X 公司的 Y 项目多失败——千万别学他们"
非黑即白。 没有权衡。
没有"为什么他们这么选"的深度。
这本书不一样——
它把 Claude Code 当作一个真实的工程作品——
有精妙的设计,也有具体的缺陷——
告诉你两边都是"选择"——而不是"对错"。
我从这一章学到的最大启发
读完之后我做了一件事——
重新审视自己写的所有 AI 应用。
我以前写复盘——只写"做错了什么"。 现在我换成——"我做了什么取舍——这个取舍的代价是什么"。
具体到工程:
我用了 grep 不用 AST——代价是搜索语义弱——但好处是依赖少 我做了无限重试——代价是出事故烧钱——但好处是用户体验好 我没做缓存——代价是费用高——但好处是代码简单
每个选择都有代价——
承认代价——比假装"我做的就是对的"——更有工程的成熟度。
这是系列第 32 篇
下一篇会讲 ——
Claude Code 后台埋了 860 个事件——Anthropic 在偷偷看什么。