 夜雨聆风
从英文转写、中文字幕、原声音色克隆,到字幕避让和最终质检:这篇文章完整复盘一条 1080P 视频的中文本地化流程。
很多人第一次做“英文视频中文化”,会以为只要完成两件事:翻译字幕、换成中文配音。
真正动手后才会发现,难点恰恰藏在细节里:专业术语容易听错;中文句长和英文不同;配音必须塞回原来的时间窗口;原视频自带的英文字幕还会与中文字幕打架;最后还要兼顾人声、环境声、字幕大小与观看体验。
这次我处理的是一条约 5 分 19 秒、1920×1080、30fps 的英文技术视频。最终完成了:
• 英文语音自动转写与专业术语校正; • 中文翻译与硬字幕压制; • 基于原说话人的跨语言音色克隆; • 逐句时长匹配和音视频重新封装; • 中文字幕缩小、下沉,并避开原英文字幕; • 多时间点抽帧、时长、响度与轨道检查。
下面把全过程拆开讲。
一、先看最终问题:字幕不是“加上去”就结束了
第一版中文字幕信息完整,但字号过大,长句会遮挡人物和画面信息;开头区域还与视频原有的英文动态字幕发生重叠。
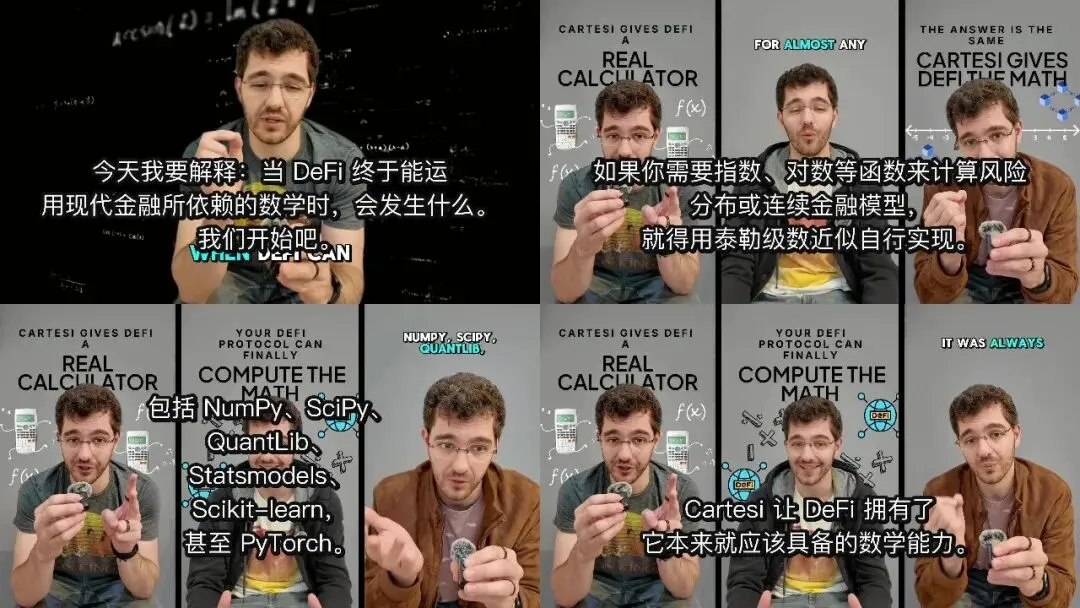
最终版采用 24px 单行字幕,将长句拆分为更短的时间片,并把中文字幕沉到画面最底部。这样既保留了原英文字幕,也不会挡住人物面部和主要视觉元素。
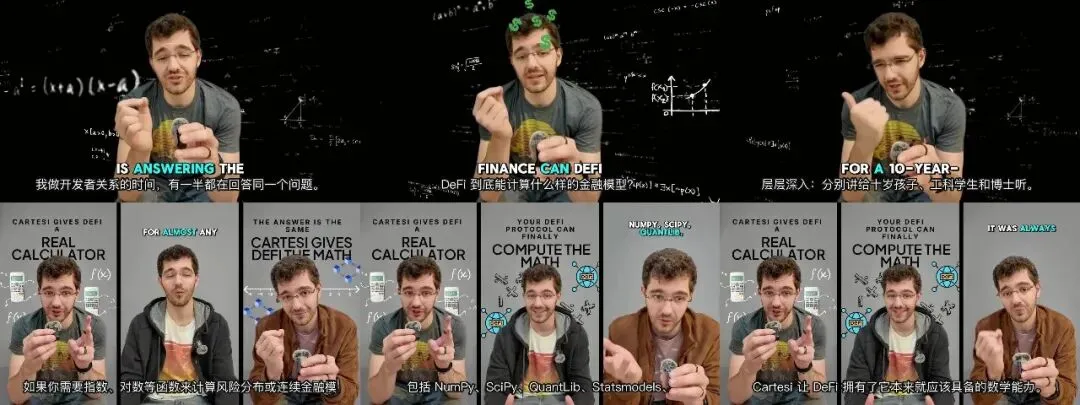
开头的实际对比如下。原视频的英文字幕本身位于下方偏中区域,因此中文字幕不能继续堆在同一高度。
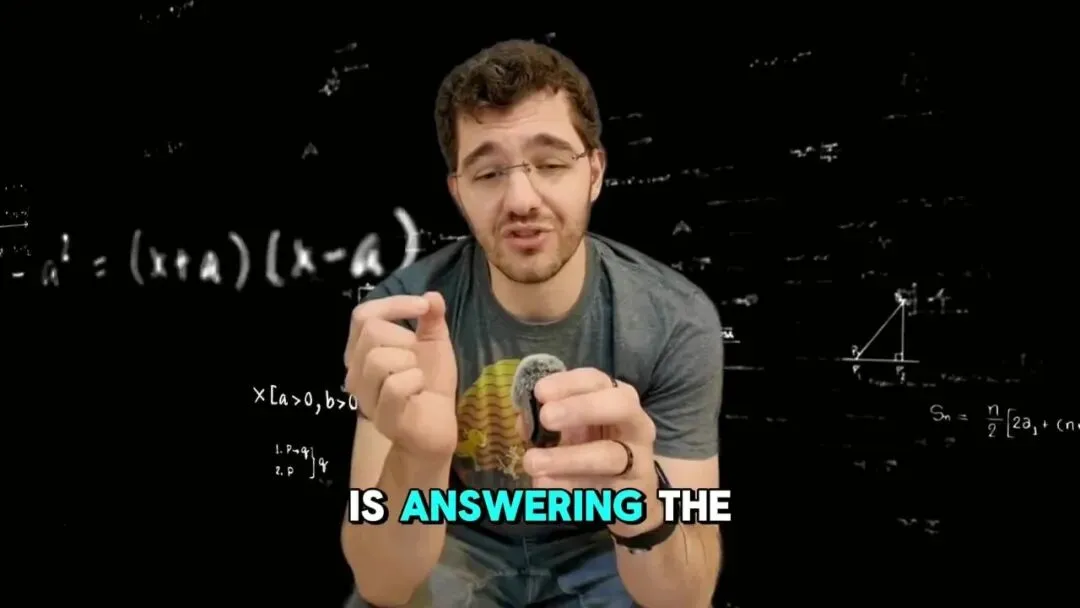
原视频开头画面
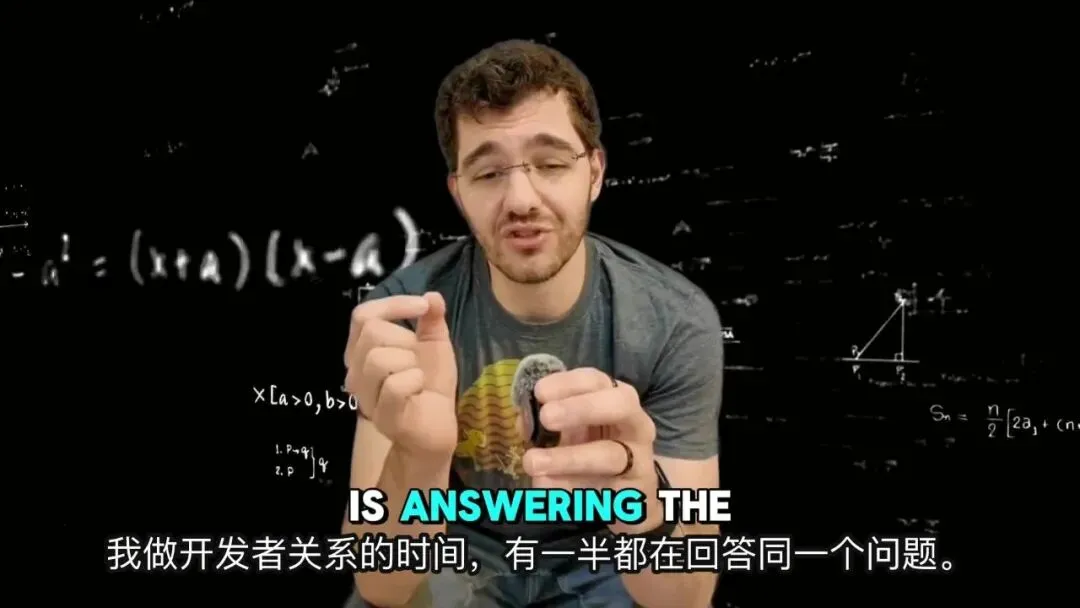
优化后:中文字幕放在英文字幕下方
这个经验很重要:字幕布局必须基于原画面,而不是只看 SRT 文件。
二、整体工作流
整条流程可以概括为:
1. 用 ffprobe检查视频参数;2. 提取 16kHz 单声道音频; 3. 使用 Whisper.cpp 转写英文并输出 SRT/JSON; 4. 翻译成中文,同时人工修正专业术语; 5. 从原视频截取干净的人声片段作为音色参考; 6. 使用 Qwen3-TTS + MLX 在 Apple Silicon 本地克隆音色并生成中文语音; 7. 将每句中文配音伸缩到原英文句子的时间区间; 8. 用 FFmpeg 压制字幕、混合少量环境声并封装 MP4; 9. 抽取多个时间点做视觉和音频质检。
核心原则只有一句:字幕、配音和画面都要回到同一条时间轴上。
三、第一步:检查源视频
先不要急着转写,先确认视频是否包含音轨、分辨率、帧率和总时长。
ffprobe -v error \
  -show_entries format=duration,size:stream=index,codec_type,codec_name,width,height,r_frame_rate,sample_rate,channels \
  -of json "~/Downloads/source.mp4"
后台得到的关键结果如下:
{
"video":{
"codec":"h264",
"width":1920,
"height":1080,
"frame_rate":"30/1"
},
"audio":{
"codec":"aac",
"sample_rate":48000,
"channels":2
},
"duration":319.034
}
这一步能提前发现很多问题,例如:素材只有画面没有音轨、手机视频是可变帧率、音频采样率不统一,或者源文件本身已经损坏。
四、第二步:提取音频并用 Whisper 转写
Whisper.cpp 对 16kHz、单声道、PCM WAV 的兼容性很好,因此先把音频从 MP4 中提取出来:
ffmpeg -y -i "source.mp4" \
  -vn -ar 16000 -ac 1 -c:a pcm_s16le \
"speech.wav"
然后使用英文模型转写:
whisper-cli \
  -m models/ggml-medium.en-q5_0.bin \
  -f speech.wav \
  -l en \
  -osrt -oj \
  -of transcript-en \
  -t 8
后台会连续输出带时间戳的句段:
[00:00:00.000 --> 00:00:04.940] Half of my time as DevRel is answering the same question.
[00:00:04.940 --> 00:00:07.920] What kind of finance can DeFi actually compute?
[00:00:07.920 --> 00:00:10.460] So I answered it three times at once.
模型同时生成:
• transcript-en.srt:用于字幕时间轴;• transcript-en.json:便于后续脚本读取和加工。
为什么转写后还要人工校正?
技术视频里经常出现库名、算法和缩写,语音模型很容易“听起来合理,但实际上错了”。这次就出现过几类典型错误:
• Monte Carlo被识别成Multi-carlo;• math.h被识别成普通英文单词;• SLEEF、QuantLib、MKL等库名被错误拆分;• integer addition被误听成语义完全不同的词组。
所以,自动转写负责完成 90% 的体力活,最后 10% 的术语校对决定了教程是否可信。
五、第三步:翻译不是逐字替换,而是“按时间翻译”
英文和中文的表达长度差异很大。如果只做字面翻译,中文配音很可能在原句结束后还没说完。
我的处理方式是把每条字幕保存成三个字段:
开始时间<TAB>结束时间<TAB>中文文本
例如:
4.940    7.920    DeFi 到底能计算什么样的金融模型?
7.920    10.460   所以,我一次给出了三个版本的答案。
翻译时遵循三条规则:
1. 技术名词准确优先,例如 DeFi、EVM、RISC-V、SciPy 不强行中文化; 2. 尽量使用中文口语,而不是论文式长句; 3. 在不丢失含义的前提下压缩字数,为配音留出呼吸空间。
六、第四步:用原说话人的音色生成中文配音
第一版使用的是系统普通话女声,内容虽然正确,但与原视频里的年轻男性声音差别太大。为了让成片更自然,后续改用了 Qwen3-TTS 0.6B Base 4-bit 做跨语言音色克隆。
运行环境是 Apple Silicon Mac,推理框架使用 MLX。先从原视频截取一段约 8 秒、语音清晰的参考音频:
ffmpeg -ss 0 -t 7.92 -i "source.mp4" \
  -vn -ac 1 -ar 24000 \
"reference-speaker.wav"
再加载模型并生成中文语音:
from mlx_audio.tts.utils import load_model
import numpy as np
import soundfile as sf

model = load_model(
"mlx-community/Qwen3-TTS-12Hz-0.6B-Base-4bit"
)

result = list(model.generate(
    text="我做开发者关系的时间,有一半都在回答同一个问题。",
    ref_audio="reference-speaker.wav",
    ref_text=(
"Half of my time as DevRel is answering the same question. "
"What kind of finance can DeFi actually compute?"
    ),
    lang_code="Chinese",
    temperature=0.7,
    top_p=0.9,
))[0]

sf.write("clone.wav", np.asarray(result.audio), result.sample_rate)
参考音频与中文克隆样本的波形如下。波形不能直接证明音色相同,但可以帮助检查停顿、动态范围和是否出现异常爆音。
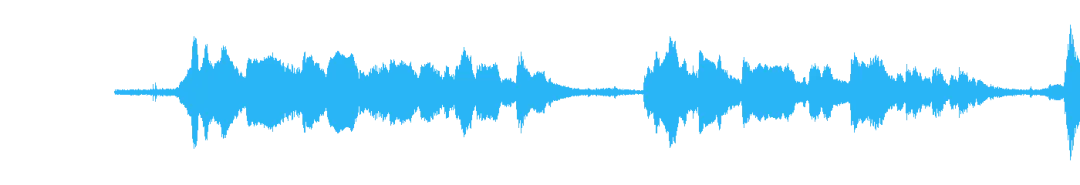
原英文参考音频波形
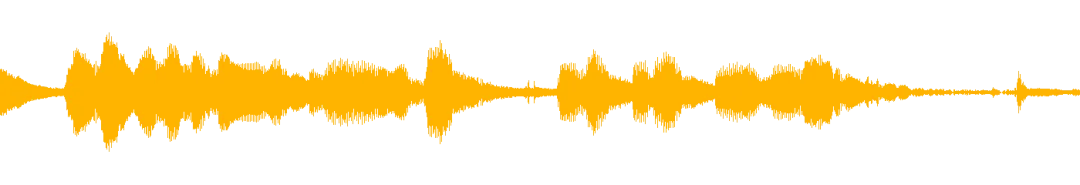
音色克隆后的中文样本波形
后台进一步计算了基频中位数:原声约为 150.9Hz,克隆样本约为 134.1Hz,二者都处于相近的男性音高范围。
提醒:音色克隆应获得声音所有者授权,并明确使用场景。不要把这项技术用于冒充、欺诈或未经同意的商业传播。
七、第五步:让每句中文配音回到原时间窗口
即使音色已经接近,生成的中文语音仍不一定与原句时长完全一致。因此需要逐句测量生成音频的时长,再用 FFmpeg 的 atempo 滤镜做微调。
target = subtitle_end - subtitle_start
speed = generated_duration / target
对应的 FFmpeg 命令如下:
ffmpeg -i raw-clone.wav \
  -af "atempo=1.083,apad,atrim=0:4.940" \
  -ar 48000 -ac 1 -c:a pcm_s16le \
  fitted.wav
这里有两个细节:
• atempo负责调整语速,但不直接改变音高;• apad + atrim确保每个片段的最终长度严格等于字幕区间。
所有片段处理完后,再通过 concat 列表拼成一条完整中文音轨。
ffmpeg -f concat -safe 0 \
  -i concat.txt \
  -c:a pcm_s16le \
  dub-zh.wav
八、第六步:保留环境声,同时尽量压掉英文人声
如果直接丢弃原音轨,成片会变得很“干”,缺少环境感;但如果把原声保留太多,英文和中文又会同时出现。
这次采用了一个轻量方案:利用立体声左右声道相减,弱化通常位于中央的英文人声,再把剩余环境声以较低音量混回中文配音。
ffmpeg -i source.mp4 -i dub-zh.wav \
  -filter_complex "
    [0:a]pan=mono|c0=0.5*c0-0.5*c1,
         volume=0.14,
         highpass=f=80,
         lowpass=f=12000[bg];
    [1:a]volume=1.12[zh];
    [bg][zh]amix=inputs=2:duration=longest:normalize=0,
             alimiter=limit=0.95[aout]
  " \
  -map 0:v:0 -map "[aout]" \
  -c:v copy -c:a aac -b:a 192k \
  output.mp4
这个方法不等于专业人声分离,但对于“人声居中、背景较轻”的素材,速度快、成本低,足以保留一点现场质感。
九、第七步:烧录中文字幕,并解决与英文字幕重叠的问题
最初的中文字幕采用 32px、多行显示。实际抽帧后发现:长句会占据画面中下部,并与原视频的英文字幕重合。
最终的优化策略是:
• 字号缩小到 24px; • 每次只显示一行; • 长句拆成多个短时间片; • 底部边距设为 14px,让中文字幕落在英文字幕下方; • 保留 2px 黑色描边,以适应深浅变化的背景。
压制命令:
ffmpeg -i source.mp4 -i cloned-audio.mp4 \
  -vf "subtitles='subtitles-zh-compact.srt':force_style='
       FontName=PingFang SC,
       FontSize=24,
       PrimaryColour=&H00FFFFFF,
       OutlineColour=&H00101010,
       BorderStyle=1,
       Outline=2,
       Shadow=0,
       Alignment=2,
       MarginV=14'" \
  -map 0:v:0 -map 1:a:0 \
  -c:v libx264 -preset medium -crf 18 \
  -c:a copy -movflags +faststart \
  final.mp4
长句拆分使用“视觉宽度”而不是简单字符数:中文字符按 1 个单位计算,ASCII 字母按约 0.55 个单位计算。这样 QuantLib、Scikit-learn 之类的英文术语不会导致字幕过早换行。
十、最后一步:不要相信“命令执行成功”,要相信质检结果
最终成片至少做四类检查。
1. 检查文件参数
ffprobe -v error \
  -show_entries format=duration,size:stream=index,codec_type,codec_name,width,height,sample_rate,channels \
  -of json final.mp4
确认结果:
• 时长:319.034 秒; • 视频:H.264,1920×1080; • 音频:AAC,48kHz; • 音视频轨道均存在。
2. 检查峰值音量
ffmpeg -i final.mp4 \
  -map 0:a:0 -af volumedetect \
  -f null -
重点查看 mean_volume 和 max_volume,避免明显削波或整体音量过低。
3. 多时间点抽帧
不要只看开头。建议至少检查:开头、技术术语密集处、中段转场、结尾 CTA。
ffmpeg -ss 3   -i final.mp4 -frames:v 1 qc-01.jpg
ffmpeg -ss 125 -i final.mp4 -frames:v 1 qc-02.jpg
ffmpeg -ss 220 -i final.mp4 -frames:v 1 qc-03.jpg
ffmpeg -ss 302 -i final.mp4 -frames:v 1 qc-04.jpg
4. 人工观看
最后仍然要完整播放一遍,重点听:
• 句子是否被强行切断; • 专业名词发音是否可接受; • 中文配音是否提前或滞后; • 英文原声是否残留过多; • 中文字幕是否挡住人物、图表或原英文字幕。
十一、这套流程最值得复用的五个经验
1. 先探测素材,再开始处理。 视频参数不统一,会把问题拖到最后。 2. 转写模型不是术语审校员。 技术名词必须人工检查。 3. 翻译要服从时间轴。 适合阅读的中文,不一定适合在 3 秒内说完。 4. 音色接近只是第一步。 真正决定观感的是语速、停顿、音量和环境声。 5. 字幕必须在真实画面上检查。 SRT 正确,不代表画面布局正确。
结语
这套方案的特点是:转写、音色克隆、配音生成和视频封装都可以在本地完成,适合技术讲解、产品介绍、课程片段和海外内容本地化。
它并不是“一键翻译视频”,而是一条可重复、可检查、可逐步优化的制作流水线。真正高质量的本地化,不是把英文换成中文,而是让中文内容像原视频本来就这样制作的一样自然。
如果你也在做英文视频中文化,建议先从 30 秒素材跑通整套流程,再扩展到完整视频。这样调试字幕、音色和语速的成本会低很多。