 夜雨聆风
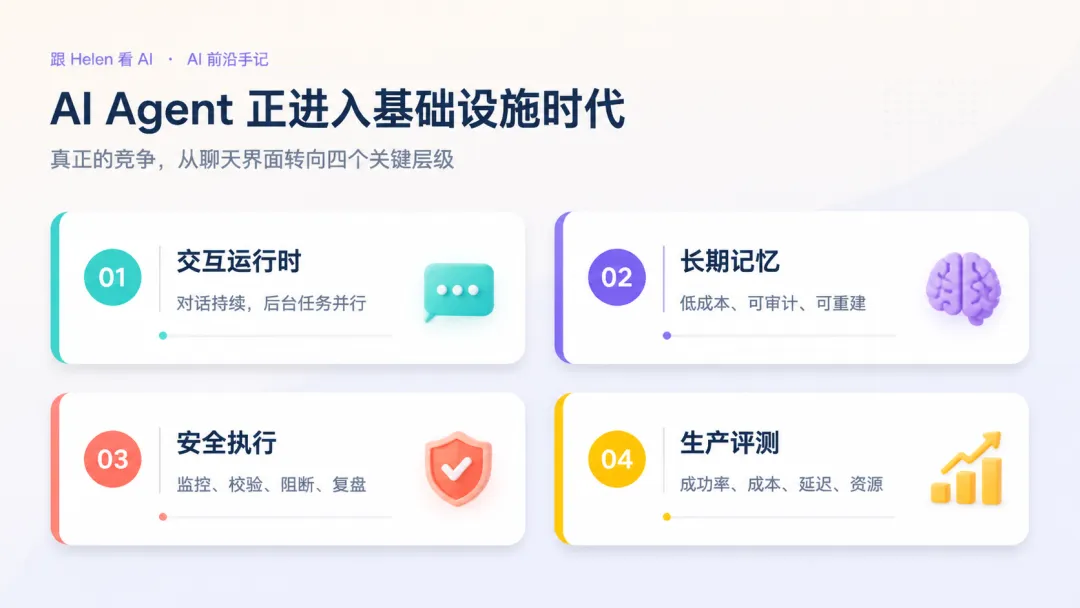
一、Agent 正在从个人助手,变成组织级运行时
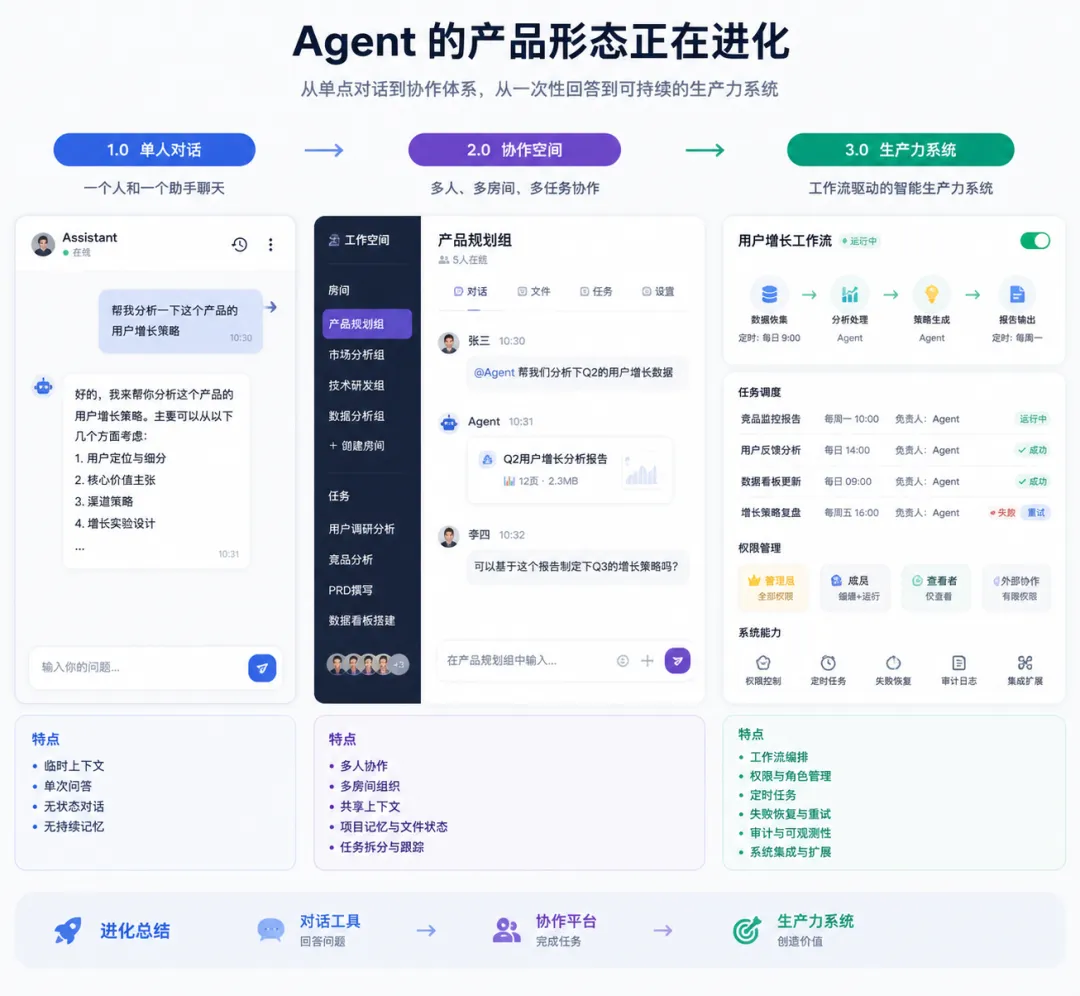
最有代表性的项目是 QM。它不是简单的聊天机器人,而是一个面向团队工作的 multiplayer agent harness。官方仓库显示,QM 为不同员工和房间提供隔离的工作区、文件、权限、记忆、定时任务和持久化沙箱,同时支持切换多种 Agent harness。
这意味着 Agent 的产品形态正在变化:
从“一个人和一个助手聊天”,变成多人、多房间、多任务协作; 从临时上下文,变成可持续的项目记忆和文件状态; 从单次回答,变成带权限、定时任务和失败恢复的工作流。
这条路线为什么重要?因为企业真正需要的不是一个偶尔表现惊艳的 Agent,而是一个不会串数据、不会乱用权限、能够在第二天继续工作的系统。
当然,QM 目前仍是非常早期的开源项目。12,786 Stars 代表强烈关注,不等于生产环境已经验证。更稳妥的试法,是在隔离测试组织里验证三件事:工作区是否真正隔离、定时任务失败后能否恢复、密钥是否遵循最小权限。
二、Agent 运行时的核心能力,正在变成安全与治理
OpenAI Agents SDK 和 Claude Code 的近期版本,给出了同一个信号:运行时工程的重要性正在上升。
Claude Code 2.1.224-226 的更新也很有代表性:加入 self-hosted runner、workspace trust、gateway spend limit、凭据掩码,并修复 MCP OAuth、权限检查绕过和后台任务相关问题。
这些更新背后的共同逻辑是:Agent 越能做事,越需要边界。
一个可以修改代码的 Agent,需要知道哪些目录可信;一个可以调用外部 API 的 Agent,需要知道哪些动作必须二次确认;一个可以长期运行的 Agent,需要能够记录工具调用、解释拒绝原因,并在失败后安全停止,而不是继续重试。
所以,Agent 的安全不应只理解为“给模型加一个内容过滤器”。更完整的安全面包括:
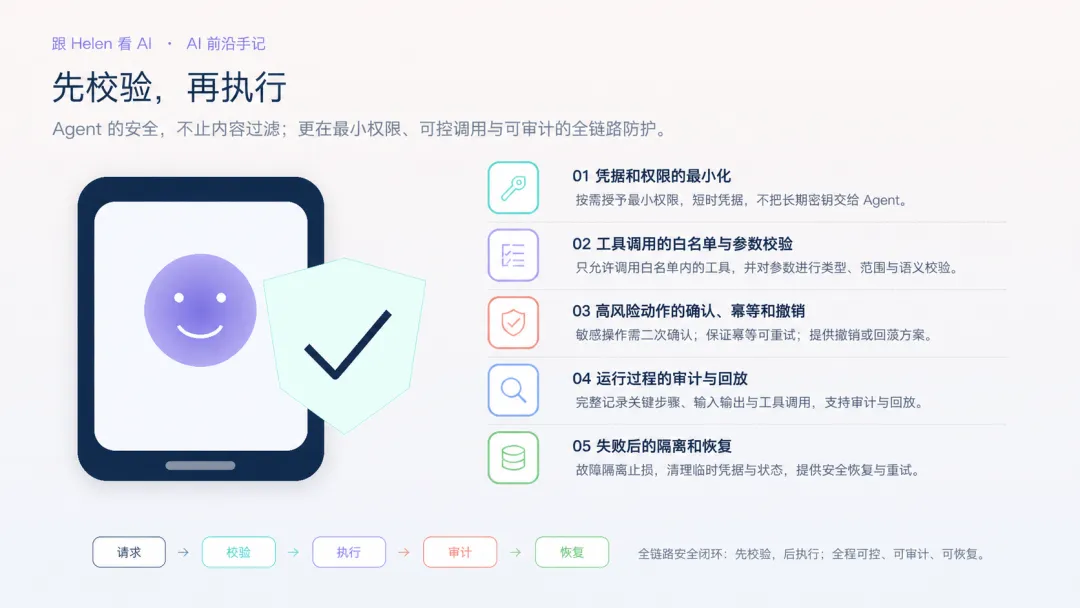
凭据和权限的最小化; 工具调用的白名单与参数校验; 高风险动作的确认、幂等和撤销; 运行过程的审计与回放; 失败后的隔离和恢复。
这也是 MCP Python SDK v2 稳定版值得关注的原因。官方仓库已将 v2 作为新主线,v1.x 转入安全维护。对开发团队而言,协议升级不只是 API 改名,还涉及请求限制、命名校验、OAuth 和生态兼容矩阵。新项目可以直接评估 v2,存量项目则应先准备迁移和回滚方案。
三、Agent 评测正在从“答对一道题”,走向“完成一段真实工作”
这类评测和传统问答测试的区别在于:Agent 不仅要给出一个看似正确的答案,还要在多个步骤中保持状态,正确使用工具,处理异常,并最终完成一个可验证的业务结果。
对企业来说,这比单纯比较模型榜单更有价值。一个客服 Agent 可能第一步回答得很好,但如果它在第三步把客户身份弄混,或者遇到 API 超时后重复提交订单,整体结果仍然是不合格的。
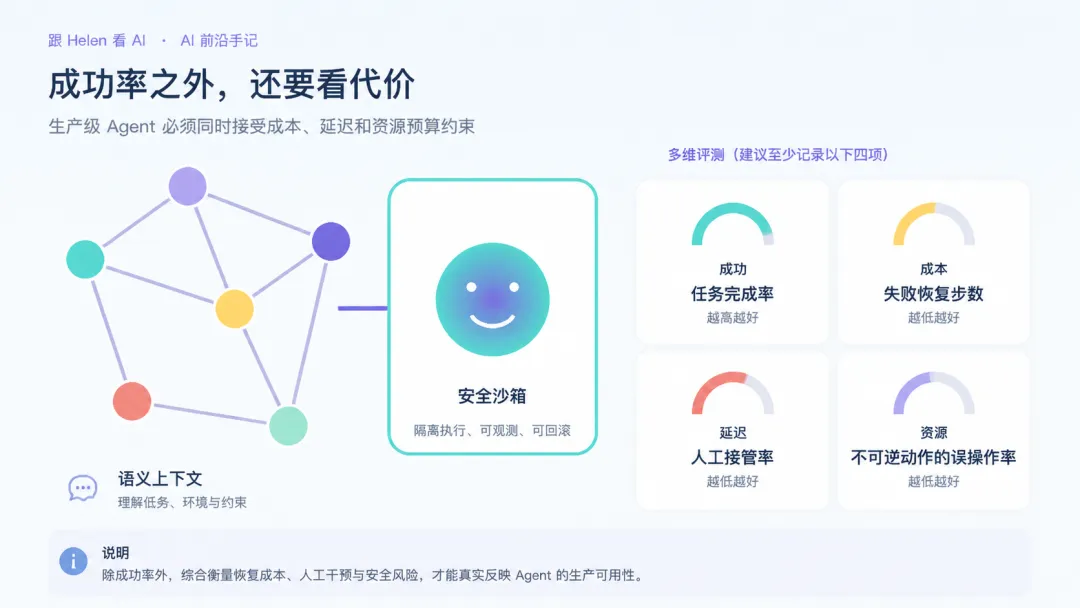
因此,评测 Agent 时,建议至少记录四个指标:任务完成率、失败恢复步数、人工接管率、以及不可逆动作的误操作率。
写在最后:先测可靠性,再追求复杂度
今天的 Agent 生态并不是缺少框架,而是缺少经过真实工作流验证的可靠性。
QM 代表组织级运行时,OpenAI Agents SDK 和 Claude Code 代表治理能力进入产品核心,RealReplicaBench 则提醒我们:Agent 的价值必须在长任务、有状态和可恢复的环境里验证。
Agent 的下一阶段,可能不是“更像人”,而是“更像一个可靠的同事”:知道自己能做什么,知道什么时候应该停下来,也能把每一步工作交代清楚。