ARTICLE · 978891
AI助手正在消失,“AI同事”开始上岗
近期 AI 热点观察
AI助手正在消失, “AI同事”开始上岗
从豆包工作、Claude记忆到OpenAI自研芯片:过去一周的7个关键信号
资料截至 2026年8月27日 | 原创趋势解读
当AI能记住你、调用工具并持续执行任务,它就不再只是一个聊天框。
核心判断 / 过去一周,看似是七条互不相干的新闻。但把它们连在一起,你会看到同一个转向:AI公司已经不满足于让模型“回答得更好”,而是开始争夺记忆、工具、企业数据、芯片和工作流。
8月25日,豆包工作正式发布;同一天,Claude宣布让聊天与Cowork共享记忆;再往前一天,汤森路透推出自有行业大模型,英伟达则把Agent时代的算力账单摆上了桌面。
而OpenAI的两则消息更像是一组对照:一边公布首款自研推理芯片,追求更低成本和更高效率;另一边又因新模型可能达到“关键网络安全能力”门槛,主动放慢训练。
这不是普通的产品更新周。更像是AI行业的一次集体转身。
01 国内AI办公,从“帮你写”卷到“帮你做”
先看最贴近国内用户的一条消息。
8月25日,豆包正式发布面向生产力场景的Agent产品“豆包工作”。它的定位很直接:不只生成文档、表格或PPT,而是围绕一个目标自主拆解任务、调用工具,并把复杂流程持续推进下去。
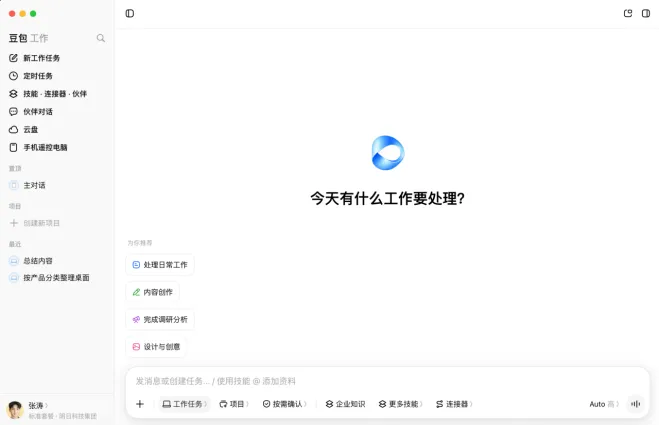
豆包工作产品界面:从单次对话转向任务式交付。 | 图源:新华网 / 豆包工作发布信息
真正关键的是两个能力。
第一,它能动手。在获得用户授权后,Agent可以操作浏览器和电脑,跨软件查资料、处理数据、填写表单,长时间任务还可以放在云电脑里继续跑。
第二,它能读懂组织。与飞书打通后,它可以在权限范围内读取聊天、文档、会议纪要和日程,产出的结果又会回流为企业知识。
这也暴露了AI办公的新门槛:以后的竞争不只是模型谁更聪明,而是谁能安全地接入企业上下文,谁能把工作流跑完,谁能对结果负责。
02 Claude开始“记住你”,一次性问答正在过时
豆包工作强调的是企业上下文,Claude补上的则是个人长期记忆。
Anthropic在8月25日宣布,Claude在普通聊天与Claude Cowork中开始使用同一套记忆。用户可以看到AI记住了什么,也可以修改、删除或暂停。健康、信仰等敏感主题默认不保存。
Claude用同一套记忆连接聊天与Cowork。 | 图源:Anthropic / Claude官方博客
这听起来只是“少重复一次背景”,但它改变的其实是人机关系。
以前的AI对话像每次都换了一位新实习生;现在的AI开始记得你的项目、目标、偏好和过去的决策。当记忆再与电脑操作、浏览器、文件和企业技能结合,AI才真正有可能成为一个能持续协作的“同事”。
聊天框不会马上消失。但它会逐渐从产品主体,变成只是给AI交办任务的一个入口。
03 OpenAI开始造芯,模型公司也要掌握“水电煤”
AI要长时间干活,首先要解决一个很现实的问题:成本。
8月25日,OpenAI公布了首款定制推理芯片Jalapeño的首批实测结果。按照OpenAI自身披露的数据,它在GPT-OSS 120B公开测试中实现了更高的单位功耗吞吐量和更低的Token延迟,对DeepSeek R1与Kimi K2也表现出跨模型适配能力。
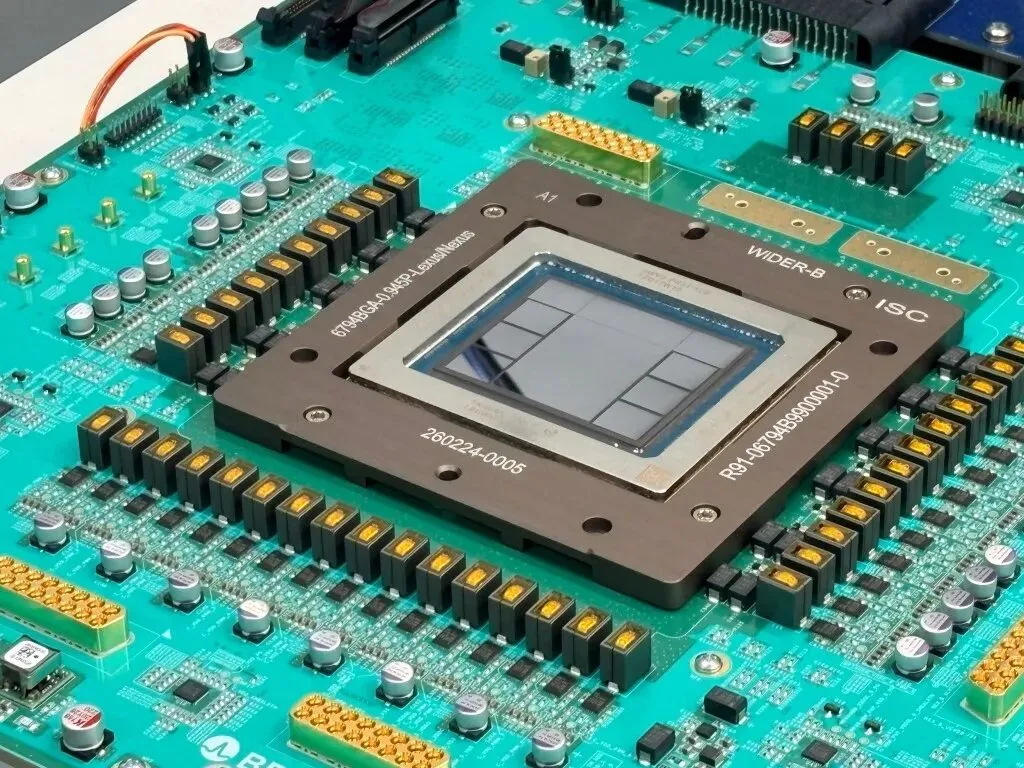
OpenAI公布的Jalapeño推理芯片实物图。 | 图源:TechCrunch / OpenAI
这些跑分目前主要来自OpenAI,仍需更多独立验证。但产业信号已经很清楚:OpenAI不再只想做一家模型公司,它想同时控制数据中心、芯片、服务软件、模型和应用。
原因不难理解。每当AI Agent学会一项新能力,它就会使用更多步骤、调用更多工具、维持更长的上下文。如果算力成本降不下来,“一人一个AI同事”就只会是一个昂贵的口号。
04 Agent的账单,可能是普通聊天的15倍
英伟达在8月24日给出了一个更直观的数字。
它援引OpenRouter数据称,Agent工作负载消耗的Token可以达到简单聊天的15倍。一个负责公司研究的Agent,可能先查财务数据库,再搜索新闻和公告,接着召唤子Agent做同行对比,最后才整理出结论。每走一步,上下文都在继续变长。
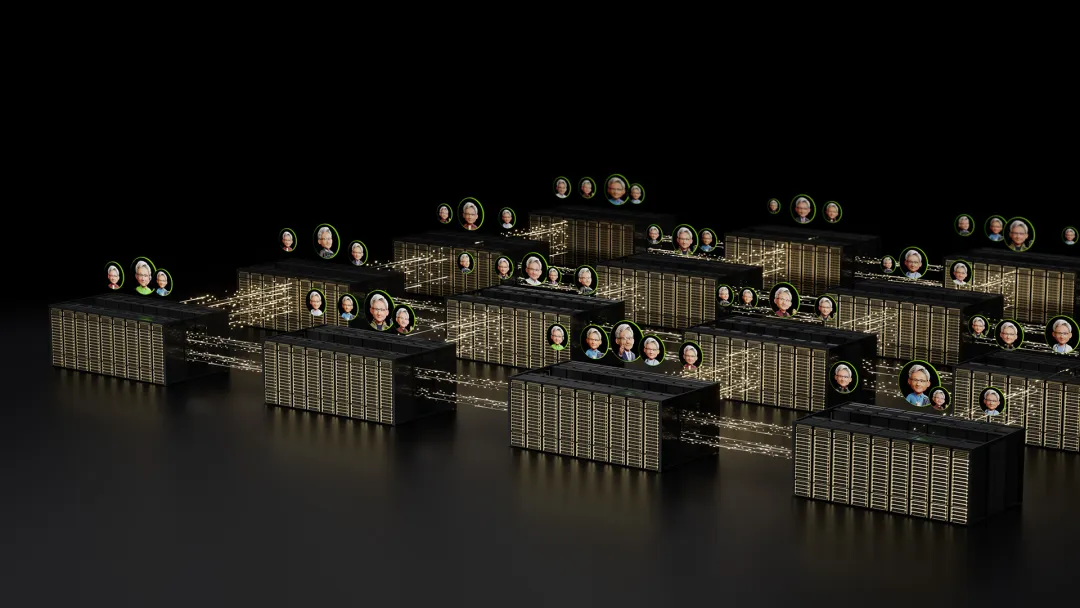
英伟达用“大规模长时间运行”来描绘Agent算力需求。 | 图源:NVIDIA官方博客
英伟达据此宣称,Vera Rubin NVL72在特定Agent负载下,每兆瓦吞吐量最高可达上一代GB300 NVL72的30倍,每百万Token成本最高可降低35倍。同样,这是供应商自报的早期结果,不能直接当成普遍性能结论。
但它解释了为什么所有公司都在谈“每瓦特完成多少工作”。未来最重要的指标,可能不是单次回答的成本,而是成功交付一个完整任务的总成本。
05 4000万美元训一个法律模型:行业数据正在变成新护城河
当通用模型越来越强,企业还有没有必要训练自己的模型?
汤森路透用一次真金白银的投入给出了答案。8月24日,公司宣布推出首个自主大语言模型Thomson。它不是从零开始训练,而是以强开源模型为基础,投入4000万美元,再把Westlaw、Practical Law、Checkpoint和Reuters等数十年的专业内容与行业专家经验融进去。
汤森路透将模型能力与法律、税务等专业数据绑定。 | 图源:Thomson Reuters官方新闻稿摄影图
首个落地场景是CoCounsel Legal中的表格化法律文档审查。汤森路透宣称,早期评估中Thomson在多类专业任务上可与前沿模型竞争,但目前仍以企业披露和有限外部评测为主。
真正值得关注的是它提出的路线:企业未必需要与OpenAI、Google比拼万亿参数,但可以用“开源底座+独家数据+专家流程”做出更懂具体工作的模型。
通用模型解决“会不会”,行业模型解决“能不能在这家公司可靠地做完”。
06 阿里的数字表明:AI正在从烧钱故事变成收入故事
模型、Agent和芯片最终都要回到同一个问题:有没有人为它们付费?
阿里云在8月21日披露,当季AI云与计算服务收入同比增长45%,云业务收入增速创22个季度新高;AI相关产品收入则连续第12个季度实现三位数同比增长。阿里同时称,Qwen系列全球累计下载量已超过30亿次,衍生模型超过30万个。
阿里巴巴园区标识摄影图。 | 图源:Alibaba Group / Alibaba Cloud
这组数字提供了一个值得观察的商业闭环:先用开源模型获得开发者与生态影响力,再把训练、部署、Agent平台和算力需求转化为云收入。
大模型的战争不会只有一个赢家。模型层可以免费,但企业为稳定、安全、数据管理和工作流付费的意愿,可能才是更持久的生意。
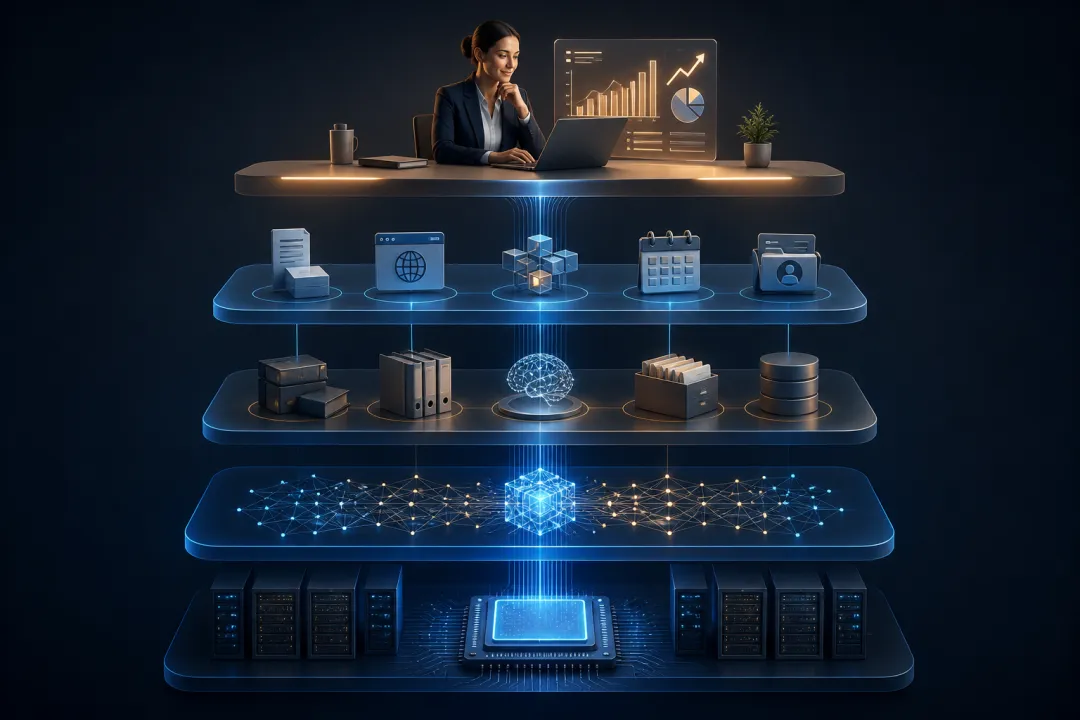
一个真正可用的数字同事,背后是芯片、模型、记忆、工具与业务结果的整体协同。
07 能力越强,OpenAI反而踩了一脚刹车
如果前六条新闻都在说AI如何变得更像一名员工,最后一条新闻则提醒我们:员工拿到的权限越大,安全的代价就越高。
OpenAI在8月18日表示,正在开发的Astra在初步评估中可能达到其《准备框架》中的“关键网络安全能力”门槛。为加固研究环境、扩大监控和红队测试,公司曾暂停两周面向部署模型的强化学习训练,规模最大的计划任务仍在等待更多对齐和安全证据。
OpenAI办公楼外观摄影图。 | 图源:CSO Online / Shutterstock / doomu
这与过去“发现漏洞、发一个补丁”的软件思路不同。当模型会写代码、调用工具、访问互联网并持续运行时,研发过程本身就已经可能成为风险场景。
真正的AI同事不能只有能力清单,还必须有权限边界、操作记录、人工审批和失败恢复。
真正的拐点:不再比谁“说得像人”,而是比谁“能把事做成”
现在再回头看这七条新闻,它们其实在描绘同一幅产业地图。
豆包工作,要拿下国内企业工作流和飞书上下文。
Claude,要让记忆跨越对话与长任务。
OpenAI与英伟达,在争夺每一度电、每一颗芯片和每一个Token的经济性。
汤森路透,在证明专业内容和行业流程也能训出差异化模型。
阿里,在尝试把开源生态与云收入连成闭环。
而Astra的安全问题,则告诉所有人,能力、权限与风险必须一起扩展。
所谓“AI助手正在消失”,并不是说ChatGPT、豆包或Claude会离开屏幕。而是它们会慢慢融进每一个工作流:起草、调研、审批、填表、编程、分析、备忘和跟进。
你未必每次都在“使用AI”。你只是在完成工作,而AI已经成为了工作的一部分。
对普通人来说,现在最值得准备的不是“神级提示词”
第一,学会清楚地交代目标、约束和验收标准。AI越会执行,含糊的任务就越危险。
第二,积累高质量的个人与组织资料。模型可以越来越同质化,但你的文档、案例、流程和判断标准不会。
第三,建立权限意识。让AI看文件、发邮件、改代码和操作业务系统,从来都不只是“方便”,还意味着责任。
最后一句 / 下一阶段的赢家,很可能不是拥有某个单项跑分第一的模型,而是最早把模型、记忆、工具、数据、芯片和安全连成一个系统的人。
当AI真的可以记住你、了解你的公司,并且代替你操作电脑时, 你最希望把哪一项工作交给它?
信息来源与核查说明
本文基于官方新闻稿、产品博客与主流新闻平台公开资料整理。涉及性能和商业数据时,已尽量标明“公司披露”或“供应商测试”,避免将企业宣传性数据直接当作独立结论。
新华网:豆包工作正式发布:让AI从生成内容到完成工作
Anthropic:Claude's memory works everywhere, and you decide what's in it
Anthropic:Build production agents with computer use, the Skills API, and the Files API
OpenAI:The full stack behind abundant intelligence
NVIDIA:Vera Rubin NVL72 sets a new efficiency standard for AI agents
Thomson Reuters:Thomson Reuters launches its own proprietary large language model
Alibaba Cloud:Alibaba's full-stack AI accelerates monetization with 22-quarter-high cloud growth
OpenAI:Pacing model development in an era of cyber-critical capabilities
TechCrunch:Jalapeño芯片实物图,图片信用标注为OpenAI
CSO Online:OpenAI办公楼摄影图,原页标注Shutterstock / doomu