ARTICLE · 979214
scansci-pdf 更新 | 大批量下载任务应对机制
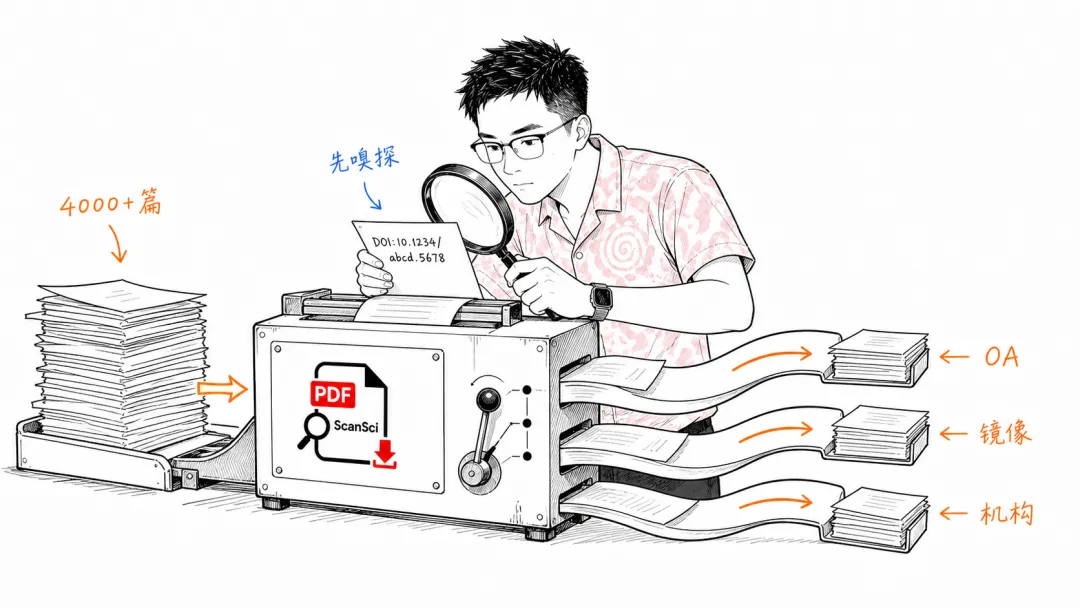
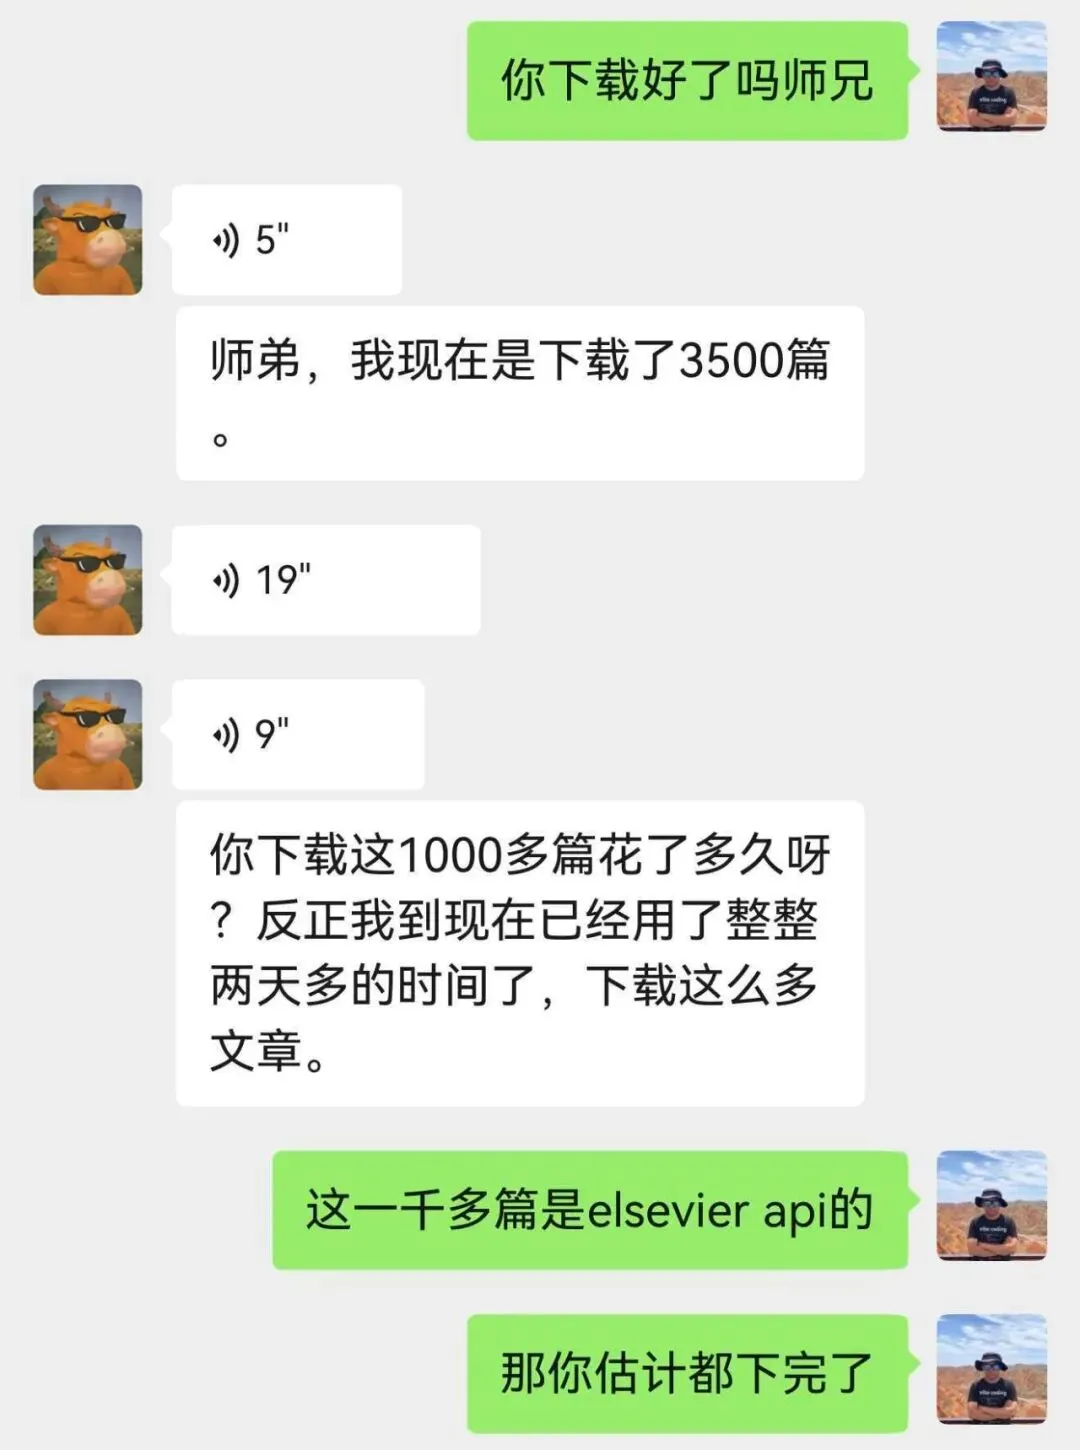
师兄发给我一份 4000 多篇文献的清单,问我:大概多久能下完?
我盯着表格看了一会儿,突然想到,scansci-pdf 以前有一个设计上的问题。
它采用的是多层竞速下载。拿到一个 DOI 后,公开源、镜像源、机构通道按不同策略尝试,哪个先拿到 PDF 就结束。下载一篇或者几十篇时,这个办法很有效,少等一会儿就能拿到结果。
可一旦任务变成几千篇,情况就变了。每篇论文都先进入竞速,能直接通过 HTTP 获取的 OA 论文,也会和需要登录、人机验证的论文一起消耗浏览器、网络请求和登录状态。
我之前一直在优化“怎么把一篇论文下得更快”。看到这份清单以后,我才意识到,几千篇任务首先需要解决的,是每篇论文应该走哪条路。
还有一个同样现实的问题:任务开始跑以后,我得知道它现在跑到哪里了。
几千篇论文可能要运行很久。只看终端日志,很难判断它卡在公开版本嗅探、浏览器登录,还是人机验证。于是这次我连任务状态也一起重新做了,增加了一个独立的桌面悬浮进度条。
大任务宁愿花一点时间嗅探
所以这次我把流程重新排了一遍:
清单 → DOI 清洗 → 公开版本嗅探 → 分流 → PDF 下载 → SI 抓取 → 失败清单下载之前,先用免费的 API 请求查询 OpenAlex,找不到时再用 Unpaywall 兜底,判断这篇论文有没有公开获取的版本。
有,就直接走 HTTP;确实没有,再进入镜像或机构通道。下载失败以后,也不把它混在一堆错误日志里,而是单独记录失败原因,方便后面继续处理。
这一步看起来多了一道工序,实际给后面的批量下载省掉了大量无效尝试。
师兄要下载的文章足足有 4566 篇,这个数量挺吓人的,但分流结果出来我松了一口气。真正麻烦费事的文献原来不过 600 余篇:
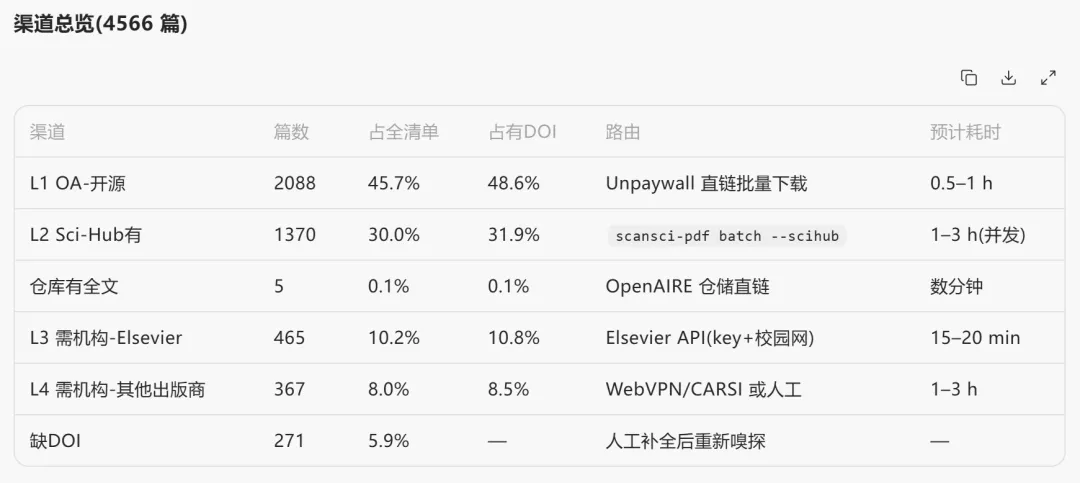
- 2088 篇(45.7%)命中开放获取:出版社提供了公开 PDF,或者落地页里可以提取到 PDF 链接;
- 1370 篇(30.0%)命中灰色数据源,Sci-Hub 的镜像站立大功了;
- 465 篇(10.2%)走 Elsevier API,下载速度跟坐火箭一样。
- 剩下的需要机构权限或暂时待定,这部分才需要更多时间。
用过 scansci-pdf 的朋友应该知道,前面这些渠道不需要排队等待浏览器登录,他们往往在短时间内就能下载完成。
以前的 Skill 升级成了插件
分流流程确定以后,我又想到一个问题。
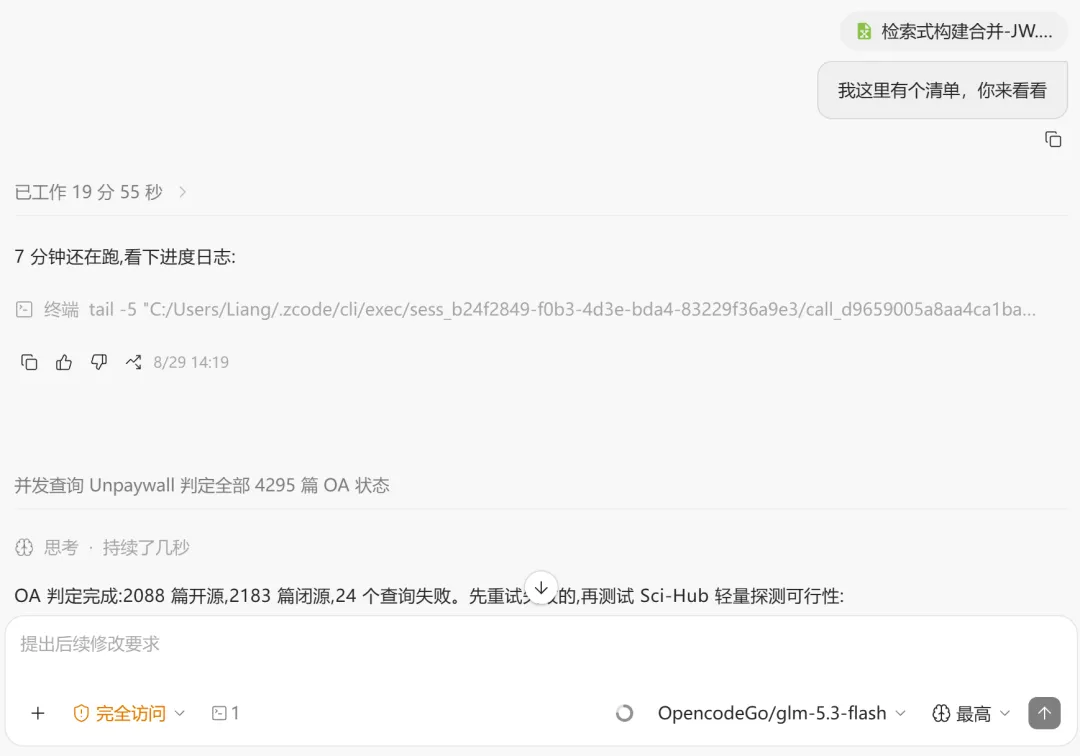
如果这些步骤只写在一份 Skill 说明里,Agent 可以照着固定流程执行;遇到不同规模、不同来源的清单时,它很难根据现场结果动态调整。几千篇文献的任务,恰好需要这种判断:先看嗅探结果,再决定调用哪个工具、哪条通道,以及什么时候停下来请求人工处理。
所以我把以前的 scansci-pdf Skill 升级成了 Agent 插件。
插件给 Agent 提供了嗅探、分流、下载、进度和检查等可调用入口。以后想把清单清洗、元数据补全、去重、失败巡检等 Skill 接进来,也有了统一的入口。1.13.1 先把文献下载这条链路做好,后面的能力可以继续往上接。
这次还把 MCP 工具从 45 个缩到了 17 个。工具说明少了约 60% 的 schema token,Agent 每次开工前需要阅读的说明书也少了,更容易选对工具,更快开始工作。
对你来说,使用方式就变成了一句话:
把这个表格里的文献分批下载。
Agent 会先看清单,再判断每篇论文该找公开版本、调用浏览器,还是走机构通道。
分流之后,才轮到下载引擎
前面的规划确定以后,真正需要跑浏览器的那部分,又暴露出几个老问题。这次我主要改了三件事。
第一,浏览器从按篇启动改成常驻工作池。
之前下载一篇论文就启动一个浏览器。一次 4 分钟的测试里,浏览器闪开了 22 次,大部分时间花在了启动和关闭上。
现在整批任务共享一个浏览器,在里面按任务打开标签页,完成后再回收。终验全程只用了 1 个浏览器,0 次中途关闭。
第二,让登录状态真正留下来。
之前 WebVPN 的会话 cookie 没有过期时间,浏览器一重启就丢;Agent 每个任务使用不同目录,浏览器 profile 也跟着变化。
修完以后,我用最直接的方式验收:强制登录,关闭浏览器,再重新打开。2 秒恢复登录状态,全程不需要手动再来一遍。
第三,给 Elsevier 论文单独开一条快车道。
10.1016 开头的 DOI 走 Elsevier API,实测速度达到 85 篇/分钟。1346 篇论文在 16 分钟内完成,成功率从 95% 提升到 99.4%,冷却和重试也加进了流程。
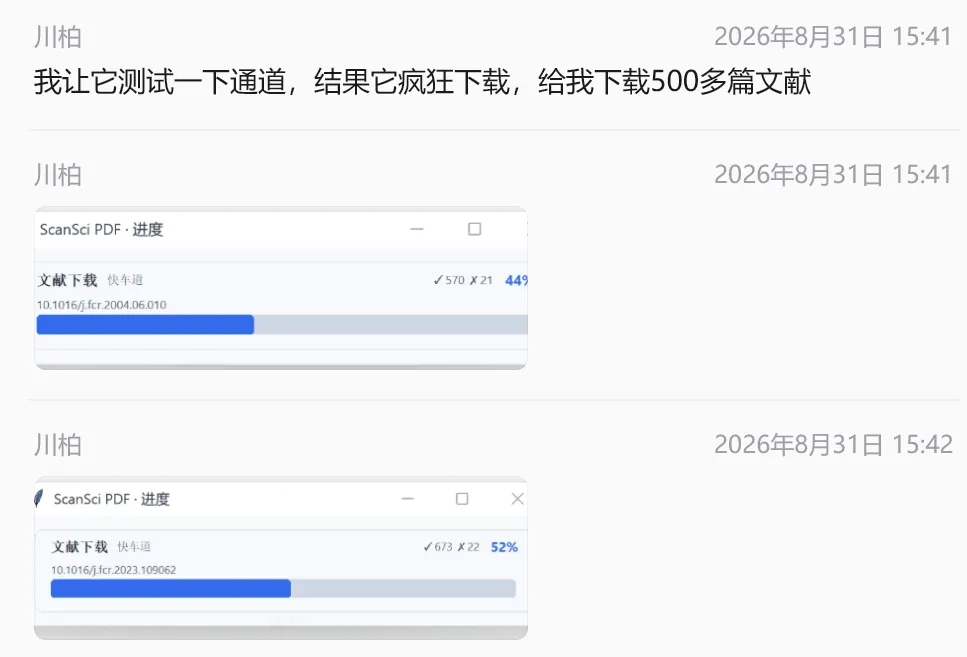
另外,我用纯查询的方式探测了 1460 篇论文的权限矩阵,结果显示 99.7% 可以通过双路由获得结果。这里统计的是权限探测结果,正文下载仍然会受到具体网络和账号状态影响。
PDF 下完以后,SI 也顺手抓了
很多论文的关键信息不只在正文里,数据表、补充实验和额外图表会放在 Supplementary Information,也就是大家常说的 SI 里。
所以这次我又给 scansci-pdf 加了 SI 抓取。PDF 下载完成后,插件会继续尝试寻找这篇论文对应的补充材料,并把结果纳入同一批任务的记录里。
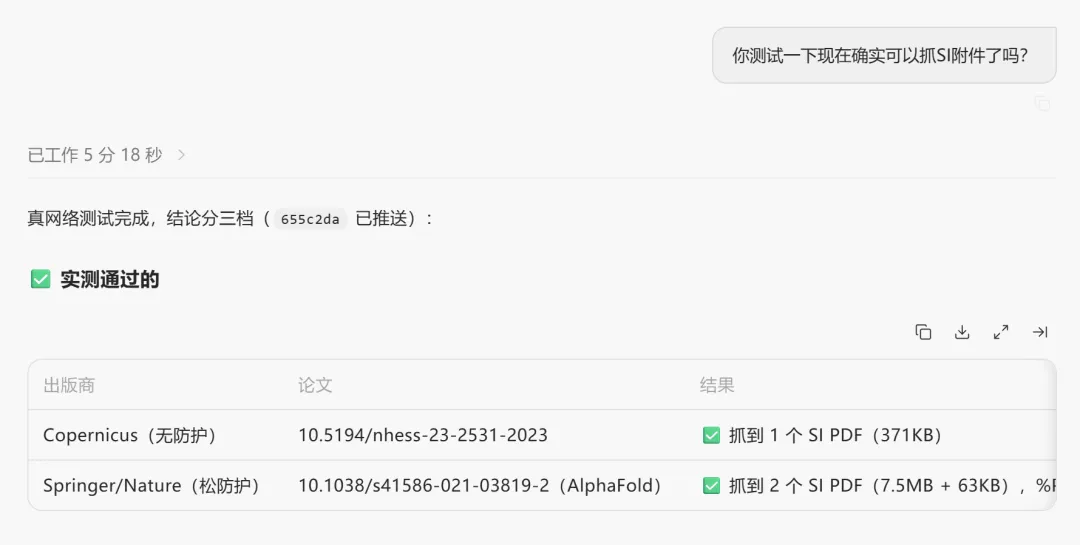
这部分目前的情况比较实在:大多数 SI 的页面结构比较清楚,抓取起来很顺利;也有一些出版社把补充材料放在异步接口、特殊下载地址或额外验证后面,当前版本仍然可能抓不到。
我没有把它写成“SI 全自动收齐”,插件能做的是尽量尝试,并把没有抓到的任务留下记录。后面继续补充站点适配时,也可以沿着这条链路往上接。
先规划,还要看得见进度
分流解决了资源该往哪里投,进度条解决了任务进行到哪一步。
任务量一大,最让人焦虑的事情就是看不见状态:当前处理到哪一篇,卡在公开获取、登录,还是人机验证?
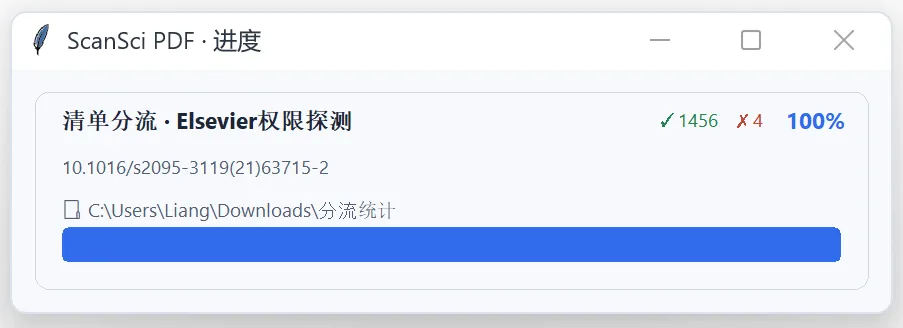
所以这次还加了一个独立的悬浮进度条:
scansci-pdf progress它会常驻桌面顶层,显示当前处于哪条车道、正在处理的 DOI,以及成功和失败的数量。输出目录也可以直接打开。
碰到人机验证时,它会把提示显示出来:
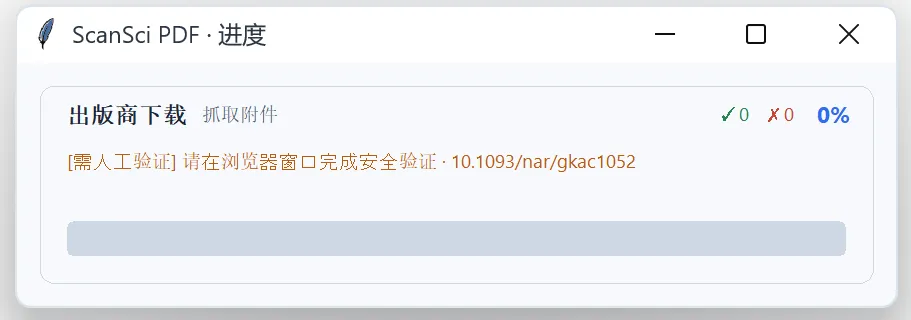
你完成一次验证后,同一网站后面的任务可以继续自动跑。遇到出口 IP 限速时,进度条也会把状态显示出来,方便你及时处理。
如果你使用时没有显示,可以对你的 Agent 说:“显示进度条”。
分流不是万能的
分流能解决走错通道的问题。它解决不了源站没有文件、镜像当天不可用,或者论文需要机构权限的情况。
付费论文依然需要你自己的机构账号。第一次碰到人机验证或 SSO 时,可能需要你手动点一下;完成以后,会话通常可以继续复用。
公开获取情况、镜像状态、网络出口和 Agent 的选择都会影响最终结果。今天的成功率,也不会自动等于下个月的成功率。
所以我对 scansci-pdf 的定位一直很简单:先把文献分流,再把能自动完成的部分交给 Agent,把需要权限、验证或人工判断的部分明确标出来。
以后我还想把它和更多文献处理 Skill 串起来,让它不只负责把 PDF 放进文件夹,也能继续处理清单、元数据和失败任务。但第一步得先把下载这件事规划好:先嗅探,先分流,再下载,失败有记录,进度看得见。
现在怎么用
如果你使用 Agent,直接告诉它:
帮我安装或更新这个插件:https://github.com/Rimagination/scansci-pdfZCode 用户也可以在插件市场搜索 scansci-pdf。
命令行用户:
pip install -U scansci-pdfscansci-pdf check可惜,师兄等不到我完成更新,已经用旧版 scansci-pdf 下载了 3500 篇了。
总之,如果你手里也有几千篇文献清单,可以先装上插件,然后把任务交给 Agent。它会先分流,再处理;跑完以后,你能清楚看到哪些论文已经下载,哪些需要机构权限,哪些还需要人工介入。
问题反馈
如果你在批量下载时遇到问题,带上一个可以复现的 DOI 或清单来群里,或者直接提 Issue。
经常有人问我:为什么我的学校 VPN 不行?为什么 Elsevier 一定要机构 intoken?为什么我总是过不了人机验证?
这些情况通常都有具体原因。毕竟不同用户的机构认证方式、机构权限、浏览器会话、出口 IP 和站点策略不尽相同,每一项都可能影响结果。
我没有办法把每种情况都测一遍,但这不代表您遇到问题就只能放弃:开源插件保留了针对具体环境微调配置和路由的空间。
试试让 Agent 自己解决这些问题,相信我,PUA 它会出奇迹。
写在最后
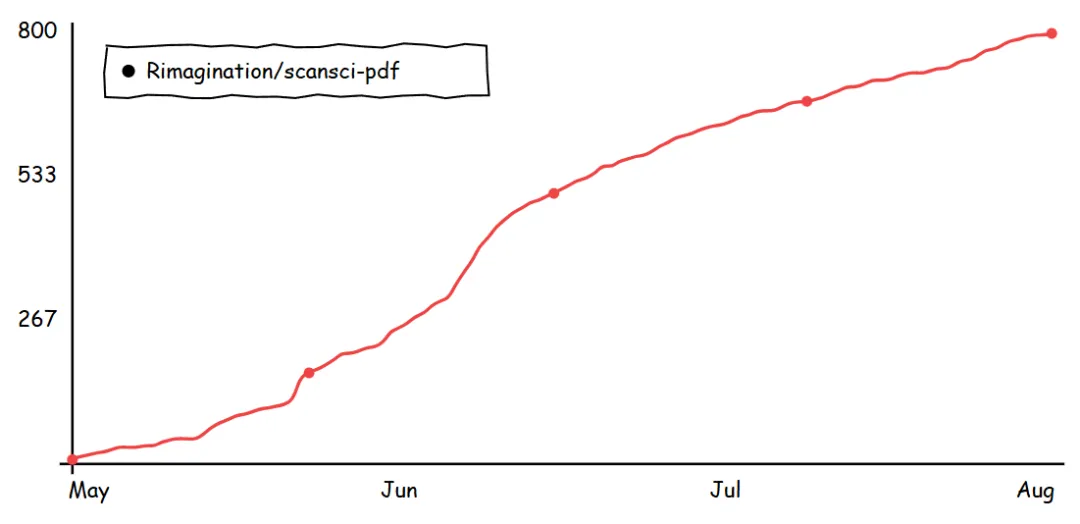
最后,恳请各位大佬帮我的项目点个 star,您的支持就是我更新的动力:
https://github.com/Rimagination/scansci-pdf