ARTICLE · 979377
拆了七大开源 Agent 的源码,最高分竟然不是 Codex
7个开源 Agent 项目综合评估报告
本文由AI解读7个开源项目代码后生成,总共花费token1.5亿
这篇文章通过源代码解读对比了 7 个开源 Agent 项目:codex(OpenAI)、gemini-cli(Google)、qwen-code(阿里通义)、opencode(Anomaly)、kimi-code(月之暗面)、deepseek-harness(DeepSeek)、oh-my-pi/omp(Stencil Labs,fork 自 Pi)。对比维度包括架构、上下文管理(压缩策略,记忆与跨会话)、会话管理(持久化,崩溃恢复)、工具调用、重连与容错、系统提示词与指令遵循、思维链与工作流编排(plan 模式,子代理,工作流引擎),以及性能、可扩展和安全。评估过程是对每个项目由独立分析任务逐文件取证(README/核心源码/配置/测试/文档),关键论断经源码抽样复核。
本文适合 Agent 开发者(技术选型、架构设计、功能实现参考),或需要给项目嵌入 Agent 功能的人员。
1. 摘要
七个项目都是「编码 Agent / Agent Harness」类工具:都以 ReAct 式主循环驱动 LLM 与工具协作,都支持 MCP、子代理与某种 plan 模式,但在架构哲学、上下文治理、安全纵深、生态绑定上已经分化出四种流派:
| 原生内核派 | ||
| 事件溯源平台派 | ||
| 产品生态派 | ||
| 标准工程派 |
五条关键结论(详见后文论证):
- 上下文压缩是同质化最高、差异最隐蔽的维度
:7 个项目全部采用「LLM 摘要 + 尾部保留」范式,但触发阈值从 50%(gemini-cli)到 85%(kimi-code/qwen-code)不等;只有 oh-my-pi 有真 tokenizer(原生 BPE),其余全是字符启发式估算,中文场景下压缩时机的系统性偏差是集体盲区。 - 安全纵深两极分化
:codex(三平台原生沙箱 + 网络代理 + MDM 配置栈)与 gemini-cli(五级 TOML 策略引擎 + 四后端沙箱)构成第一梯队;opencode 在 SECURITY.md 中明确声明不提供沙箱,oh-my-pi/kimi-code 默认审批姿态宽松。 - 事件溯源正在成为新一代架构的事实标准
:deepseek-harness 的「Model-visible ⟺ logged」不变量、opencode 的 durable 事件 + projector、kimi-code v2 的 DI×Scope + 生成契约,都指向同一方向,会话日志是唯一事实源,UI/恢复/遥测全部从中派生。 - 没有任何项目内置向量 RAG
:跨会话记忆普遍是「文件 + 工具化访问」(codex memories、gemini-cli MEMORY.md、omp mnemopi 可选嵌入),检索靠 grep/LSP。把 RAG 嫁接到这些 harness 上是明确的机会点。 - 选型第一决定因素是模型生态绑定
:codex 只认 Responses API、qwen-code 深度适配 DashScope、kimi-code 独占 Kimi prompt_cache_key,先定模型,再选 harness,反之则付出适配层成本。
AI 按九个维度加权打分并排名:架构与工程质量(12%)、上下文管理(15%)、会话管理(8%)、工具调用(12%)、重连与容错(10%)、提示词与指令(8%)、CoT 与编排(12%)、安全与权限(12%)、可扩展性(11%)。
deepseek-harness 4.62 ███████████████████████▏ 能力密度最高,但 developer previewoh-my-pi 4.56 ███████████████████████ 工程纵深最强,默认安全宽松codex 4.37 █████████████████████▊ 安全与持久化标杆,生态收紧qwen-code 4.33 █████████████████████▋ 全端生态最全,复杂度失控风险gemini-cli 4.19 █████████████████████ 工程护栏最完备,Gemini 绑定opencode 3.93 ███████████████████▋ 架构先进,安全/记忆短板明显kimi-code 3.78 ██████████████████▉ 工程化密度高,上下文手段单一
AI 对 deepseek-harness 的评价很高,尤其欣赏它的架构和思路。
下面是每个板块的摘要对比结论,详细信息单独文章放出。
2. 项目基本盘对比
语言、版本与许可证
代码与测试规模
社区活跃度
3. 总体架构对比
架构风格与插件化程度
| 极高 | ||
主循环与事件机制
codex-rs/core/src/session/turn.rsrun_turn | ResponseEventEventMsg 推送 | |
core/src/agent/legacy-agent-session.ts:183 | GeminiEventType | |
core/src/core/client.tsGeminiClient | ServerGeminiStreamEvent | |
opencode/src/session/prompt.tsrunLoop | ||
loop/run-turn.ts / v2 loopService | ||
packages/core/agent-loop/src/agent.tsReactLoopAgent | ||
packages/agent/src/agent-loop.ts |
耦合风险点:
codex: session/mod.rs4,273 行,God Object 苗头gemini-cli: Config3,600+ 行服务定位器;新旧双轨并存qwen-code:单文件巨大(scheduler 6,496 行)、命名漂移 opencode:V1/V2 双栈迁移中期 kimi-code:v1/v2 双引擎双份维护 deepseek-harness:概念词汇表庞大(seam/profile/bundle) oh-my-pi:coding-agent 单包 84.6k 行,内核与产品同包
结论均出自源码取证,引证形如
file:line。
架构风格分化的根源
七个项目都是「编码 Agent / Agent Harness」类工具,主循环都是 ReAct 式的「采样 → 工具批执行 → 结果回灌」,但架构风格已经分成了四类,根源在于三个初始约束不同:
- 运行时与语言选型决定了能做什么
,codex 与 oh-my-pi 选 Rust/原生内核,于是沙箱、tokenizer、shell 能编进进程,工具执行零 fork;其余五家用 TypeScript,工具执行必经子进程,但换取了更快的迭代与更宽的生态。 - 「谁是事实源」决定了持久化层级
,把模型可见内容做成 append-only 事件日志(dsh、opencode、kimi-v2)才能做到 fork/resume/审计/回放同源;快照式(gemini-cli)或转录式(codex/qwen/omp)则 resume 语义受限。这是从「个人 CLI」走向「可审计平台」的分水岭。 - 宿主数量决定了是否需要 DI/Scope 与 client/server 分裂
,只跑一个 TUI 的项目(codex、gemini-cli、omp)可以把循环、状态、UI 揉在一个进程;要同时服务 TUI/Web/IDE/ACP 的项目(kimi-code、opencode、dsh)就必须把内核与宿主切开,于是出现 DI 容器、作用域生命周期、SSE/事件投影这一整套机制。
三种架构原型(Mermaid)
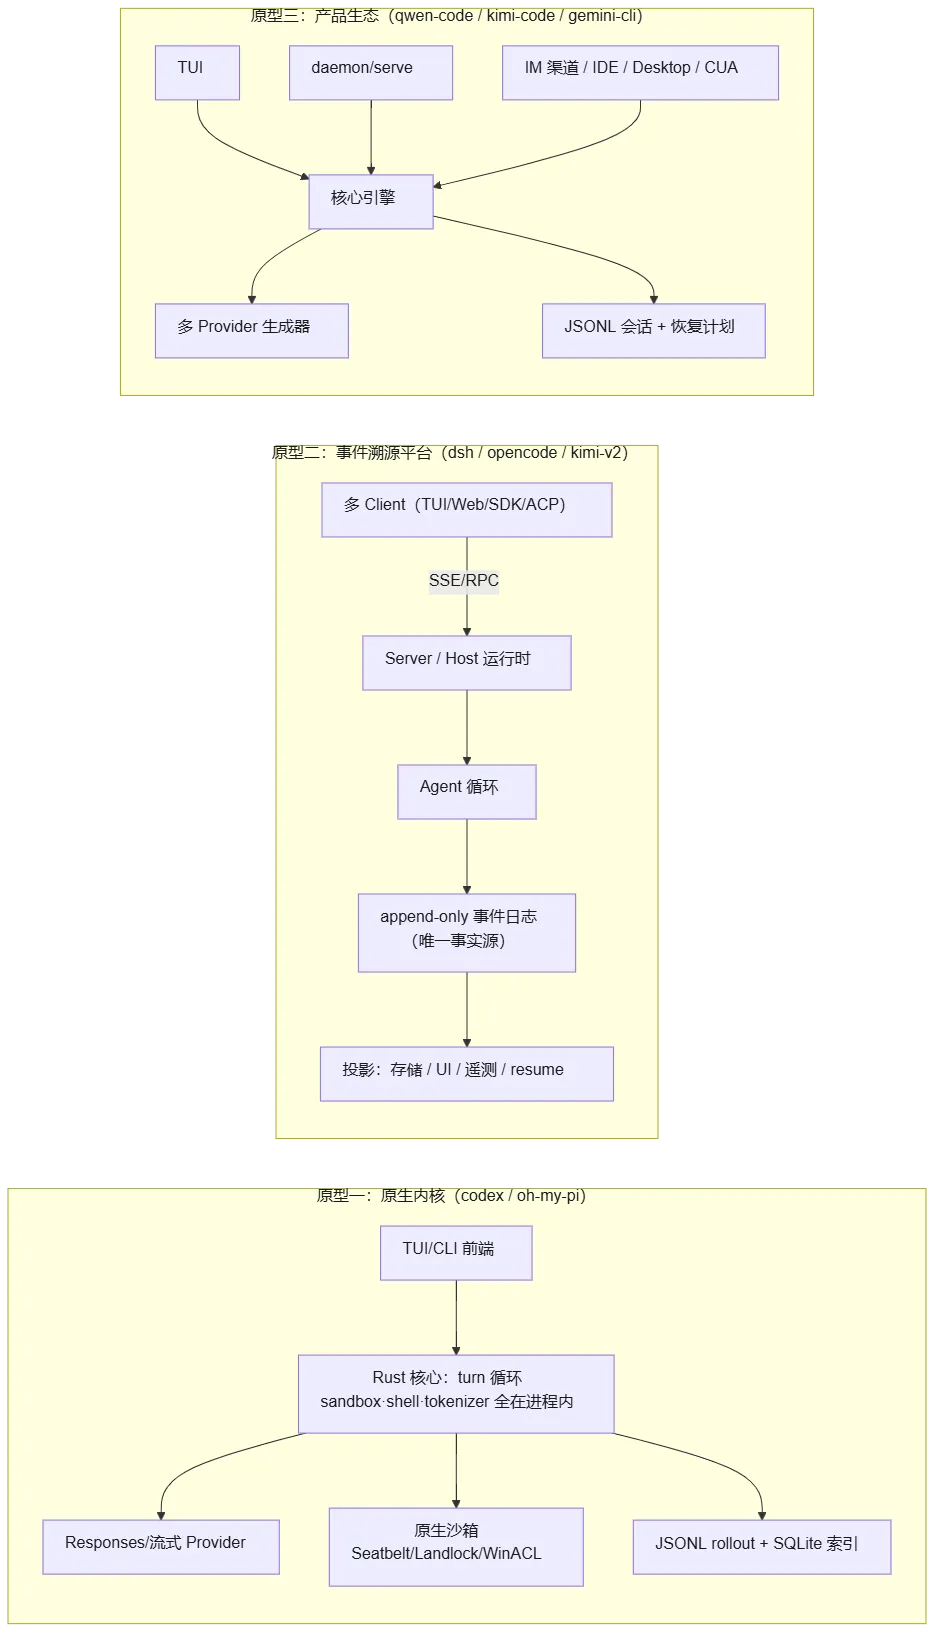
点评:
- 事件溯源在可审计场景占优
:dsh 把「模型可见内容必须可从日志重建」写成运行时不变量, request/header全量快照意味着任何一次模型请求都能离线复现,fork、压缩、UI 回放、遥测全部是同一份日志的不同 fold。opencode 的 projector 同思路但粒度到 message/part。代价是写路径复杂度(dsh 的日志锁事件、崩溃孤儿锁检测)。相比之下 gemini-cli 的 JSON 会话记录是「快照式」的,rewind/resume 语义受限。 - 原生内核在性能上占优
:omp 把 ripgrep 引擎、brush bash、58 个 coreutils 编译进进程,grep/bash 零 fork/exec,Windows 无需 WSL,对「编程 Agent 的 90% 操作是文件与 shell」的现实是降维打击。codex 的 musl 静态二进制同理。纯 TS 项目(gemini-cli/qwen/opencode/kimi)的工具执行全部经过子进程开销。
4. 上下文管理
压缩策略对比(核心表)
codex
触发阈值: model_auto_compact_token_limit(模型目录/配置,scope=Total 或 BodyAfterPrefix)摘要方式:本地 LLM 摘要(handoff 提示词)+ 服务端 remote v2 + Memento/PrefixCompaction 策略 尾部保留:初始上下文按注入语义重注入 特色机制: new_context_window工具(模型自开新窗口不摘要);PreCompact/PostCompact hooks;fallback buffertoken 计数:bytes/4 启发式(自认粗略)+ API usage 回传
gemini-cli
触发阈值:50% 窗口(可远端 flag 调) 摘要方式:LLM 摘要(专用压缩模型别名)+ 二阶段 Probe 自校验 尾部保留:30% 尾部;工具输出 50k token 预算,超额落盘 特色机制:切分点避开 functionCall/Response 对;失败降级纯截断不烧钱;新 ContextManager 管线(8 processors,默认关闭) token 计数:ASCII 0.33/字、CJK 1.5/字 启发式;媒体才调 countTokens API
qwen-code
触发阈值:85% + 13k buffer(对照 claude-code 三级阈值) 摘要方式:LLM 摘要 <analysis>+<state_snapshot>尾部保留:未明示比例(保留最近意图) 特色机制:microcompaction(旧工具结果清空,无需 LLM);压缩失败熔断器;压缩后附 subagent 快照 token 计数:ASCII/4 + 非 ASCII×1.1(注释自认 ±30%)
opencode
触发阈值: tokens.total ≥ limit.input − reserved(reserved=min(20k,maxOutput))摘要方式:LLM 摘要,强制结构化模板(Objective/Important Details/Work State) 尾部保留: preserve_recent_tokens(2k~15k,窗口的 25%),turn 内可切分特色机制:prune:40k token 保护区外的旧工具输出标记清空;溢出时剥离媒体重放;插件可替换摘要 prompt token 计数: length/4(全文件 3 行)
kimi-code
触发阈值:85% 或剩余 <50k 摘要方式:LLM 摘要(第一人称 handoff note,用会话语言) 尾部保留:保留的用户消息原样 + 摘要 特色机制:摘要请求 5 次重试、128k 输出预算、溢出→缩窗→再压缩最多 3 轮;microcompaction 已禁用成死代码 token 计数: ceil(ascii/4)+nonAscii;measured/estimated 策略枚举
deepseek-harness
触发阈值:80%(pressure)+ overflow 失败触发 摘要方式:LLM 摘要(可独立 summarizationProvider)+ 确定性工具结果裁剪(pruner 先行) 尾部保留:16% 尾部,tool-call/result 配对边界 特色机制:摘要是带 surfaceOp:replace的日志事件;maxTokens:8192;per-model 策略覆盖;spill:超大工具结果溢出到文件只留首尾预览token 计数:token-meter,优先复用上次真实 usage 作锚点,否则启发式重估价
oh-my-pi
触发阈值:六种触发(手动/溢出/length 截断/回合后/回合中/空闲) 摘要方式:方法链:LLM 摘要、shake(机械省略为 artifact:// 引用)、snapcompact(历史渲染成 PNG 位图给视觉模型读)、预裁剪 尾部保留: firstKeptEntryId之后全部保留特色机制:帧形状按 provider 计费调优;显示转录与 LLM 上下文分离 token 计数:原生 BPE(tiktoken-rs),按模型族切编码器,唯一真实 tokenizer
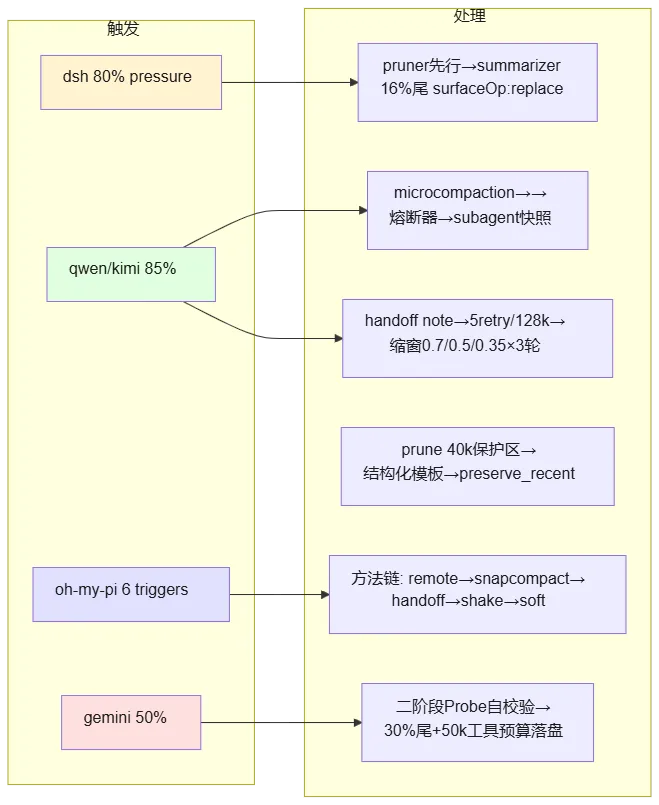
七个项目的上下文压缩都遵循同一骨架:估算 token → 触发 → 摘要/裁剪 → 重注入保留段,差异集中在三处:
- 触发阈值
:从 gemini-cli 的 50% 早压缩到 qwen/kimi 的 85% 晚压缩,本质是「摘要次数 vs 单次摘要成本/溢出风险」的取舍。 - 裁剪与摘要的先后
:dsh 与 opencode 走「确定性裁剪先行」路线(零成本削减工具输出),qwen 走「microcompaction 独立通道」,gemini/opencode 把超大工具输出落盘保留可找回性。 - token 计数
:除 oh-my-pi 外全是字符启发式,且系数各异(0.25~1.5 token/字符),CJK 文本上系统性偏移。
记忆与跨会话
codex
指令文件层级:AGENTS.md 项目根→cwd 全拼接 + override + 用户级 跨会话记忆: ~/.codex/memories文件系统 + list/read/search/add 工具向量/RAG:未发现
gemini-cli
指令文件层级:GEMINI.md 四层(global/extension/project/userProjectMemory) 跨会话记忆:saveMemory 工具 + memoryService 后台 LLM 抽取(3h 空闲门槛、30 分钟节流)+ JIT 子目录上下文 向量/RAG:未发现(ragLogger 仅旁观服务端 grounding)
qwen-code
指令文件层级:QWEN.md/QWEN.local.md/AGENTS.md/.qwen/rules,支持 @import 跨会话记忆:auto-memory 体系:extraction/recall/dream(离线记忆整理)/forget/secret-scanner/team-memory git 同步;mem0 外接集成 向量/RAG:模型选择性检索(200 候选→5 注入),非向量库
opencode
指令文件层级:AGENTS.md/CLAUDE.md 首类命中 + 就近目录动态挂载 跨会话记忆:未发现持久记忆 向量/RAG:未发现
kimi-code
指令文件层级:AGENTS.md 用户级+项目层级(不读 CLAUDE.md) 跨会话记忆:未发现(仅 session resume/fork) 向量/RAG:未发现
deepseek-harness
指令文件层级:AGENTS.md/CLAUDE.md + local 覆盖,字节预算与去重 跨会话记忆:session-reference(跨会话日志提取)+ session-query 工具 + MCP 外接记忆示例 向量/RAG:未发现
oh-my-pi
指令文件层级: .omp/AGENTS.md+ 继承 8 种外部约定(CLAUDE/CODEX/GEMINI/opencode/copilot…)+ sticky rules跨会话记忆:mnemopi:SQLite 记忆引擎,可选本地 ONNX 嵌入;local/hindsight 后端生成项目摘要注入 向量/RAG:可选嵌入检索(唯一带向量能力的,但非默认代码检索路径)
七个项目的「跨会话记忆」能力差距远大于压缩策略。可分三档:
- 成体系
:qwen-code(auto-memory:extraction/recall/dream/forget/secret-scanner/team-memory/mem0 外接)、oh-my-pi(mnemopi SQLite + 可选 ONNX 嵌入)、gemini-cli(memoryService 后台 LLM 抽取 + saveMemory 工具)。 - 文件系统级
:codex(memories 工具 + SQLite 整合)、deepseek-harness(session-reference 跨会话引用)。 - 基本无
:opencode、kimi-code(仅指令文件,无持久记忆)。
指令文件层面则普遍支持 AGENTS.md/CLAUDE.md 类约定,差异在层级数与是否读 CLAUDE.md。
点评:
- 阈值差异的本质是取舍
:gemini-cli 50% 早压缩 = 摘要次数多、信息损失早但永不溢出;kimi/qwen 85% 晚压缩 = 尽量保留原文、但单次摘要更贵(kimi 摘要预算高达 128k token)且溢出风险留给恢复链;dsh 80% + 失败兜底 + 裁剪先行是折中。对长对话的实际影响:早压缩项目在第 N 轮就依赖摘要保真度(gemini 用二阶段 Probe 补救),晚压缩项目在临界点的单次摘要失败会直接触发 overflow 恢复(qwen 用熔断器防死循环)。 - dsh 的「裁剪先于摘要」更优
:工具输出(日志、文件内容)通常占历史 60% 以上且高度可裁剪;确定性裁剪零成本、零信息歧义,能把相当一部分 pressure 在不烧摘要 token 的情况下化解。opencode 的 prune(40k 保护区)是同类思路。gemini-cli 的 50k 工具输出预算落盘是第三种形态,把大输出移出上下文但保留可找回性,比直接截断信息损失小。 - token 计数是集体软肋
:除 omp 外全部是字符启发式,且各家系数不同(0.25~1.5 token/字符)。CJK 文本上 gemini 的 1.5 系数会高估(提前压缩),kimi 的 +1/字会低估(压缩滞后)。压缩决策建立在估算之上,意味着中文重度用户的压缩时机系统性偏移。改进建议:接入各模型官方 tokenizer(或 omp 式的原生 BPE)成本不高,收益直接。 - 跨会话记忆的分水岭是 qwen-code
:dream(离线记忆整理)+ recall(选择性注入)+ secret-scanner(防密钥入库)+ 团队同步,是唯一成体系的「自写笔记」设计;其余项目的记忆基本停留在「手工维护的 Markdown」。若做长期项目助理,这是关键差异。
5. 会话管理
codex
持久化格式:JSONL rollout(按日期目录)+ SQLite 索引 + zstd 冷压缩 resume/fork:resume/fork/revert/archive/分页历史;fork 记录血缘 并发控制:单写者后台任务 + mpsc 命令通道 恢复/容错:revert 保 thread ID 新建不可变文件;写入失败 terminal_failure 复现
gemini-cli
持久化格式:JSON 记录(~/.gemini/tmp//chats) resume/fork:–resume + /resume save/resume <tag>+ checkpointing(影子 git 仓库文件快照,默认关) + /rewind并发控制:shell 不活动超时;未发现会话写锁 恢复/容错:磁盘满降级提示
qwen-code
持久化格式:JSONL 转录 + checkpoint 记录 resume/fork:–continue/–resume/–fork-session + /restore(文件级检查点回滚)并发控制:session-writer-lease 文件锁单写者租约(O_NOFOLLOW、锁 schema v2、转录哈希校验) 恢复/容错:buildSessionRecoveryPlan:clean/interrupted-prompt/interrupted-turn/degraded-history 四类修复计划 + 孤儿 tool_use 修复
opencode
持久化格式:SQLite WAL(session/message/part 表,ULID) resume/fork:–continue/–session/–fork/–replay;share 上传云端 并发控制:每 session Runner + BusyError;WAL 支撑多进程 恢复/容错:无状态循环重推导 + 中断 tool_use 标记 interrupted 防 provider 报错
kimi-code
持久化格式:wire.jsonl 事件流 + state.json;minidb(自研 KV:WAL+快照+全文索引含 CJK bigram) resume/fork:–continue/–session/fork(fork 不继承 goal) 并发控制:index append 串行化 + O_APPEND 原子性;wire 无跨进程锁 恢复/容错:records 重放重建(「只重建内存状态」契约)
deepseek-harness
持久化格式:append-only SessionEvent 日志;JSONL(zstd) / SQLite 双后端 resume/fork:load/inspect/fork/seed;crash 补合成 turn/end 并发控制:coordinator LRU + 活会话权威快照等待 恢复/容错:Model-visible ⟺ logged 不变量;格式版本拒绝策略
oh-my-pi
持久化格式:JSONL 树(每条 parentId)+ blob 内容寻址仓 resume/fork:fork 只移 leaf 指针不改写历史;/tree 导航;导入 Claude/Codex 会话 并发控制:AgentBusyError 禁并发 prompt;SQL/Redis 存储适配器预留 恢复/容错:终端 breadcrumb + continueRecent;分支摘要
总述:持久化模型的三个层次
七家的会话持久化可归入三个递进层次,层次越高,resume/fork/审计能力越强,但实现复杂度也越高:
- 快照式(snapshot)
,代表:gemini-cli。把「当前对话状态 + 工具调用点」整体序列化成 JSON 文件,必要时另存影子 git 快照。恢复=读回最近快照。优点是简单;缺点是历史不可分叉、不可重放,每次回滚靠外部 git commit。 - 转录式(transcript)
,代表:codex、qwen-code、kimi-code、oh-my-pi。把会话写成追加式(append-only)日志(JSONL),每条记录一个事件/消息。恢复=从日志重放。codex/kimi 是线性日志;oh-my-pi 是带 parentId的树形日志,分支零成本。转录式已能 resume/fork,但状态投影仍需调用方现场重建。 - 事件溯源式(event sourcing)
,代表:deepseek-harness、opencode。日志即唯一真相(source of truth),所有可读状态(消息、部件、上下文、UI)都是日志的投影(projection)。写入只追加事件,读取由 projector 折叠事件流。这一层天然支持审计、重放、双后端、不变量断言,代价是要维护投影机与事件 schema 版本。
另有两个中间态/变体:
- oh-my-pi 的树形 JSONL + leaf 指针
:仍是转录式,但每条记录 parentId,整条日志是一棵树;fork=移动 leaf 指针、不改写任何历史,是七者中分支成本最低的设计,也比 qwen 的 fork-session 复制更省。 - deepseek-harness 的双后端事件日志
:同一份 SessionEvent流可落地为 JSONL(zstd) 或 SQLite,靠「格式版本拒绝 + 中断尾合成 turn/end」保证可恢复,并设了一条 repo 级不变量「Model-visible ⟺ logged」。
点评:
- qwen-code 的 writer-lease 与 session-recovery-plan 是被低估的工程
:多进程写同一会话转录是真实痛点(daemon + TUI 并存),文件锁 + 哈希校验 + 四类恢复计划的组合在七个项目中独一份。相反 kimi-code 的 wire.jsonl 无跨进程锁,隐含「单进程持有会话」假设,其 kap-server 多会话场景依赖进程边界而非锁。
6. 工具调用(Function Calling)
机制对比
codex
注册机制: ToolExecutortrait +ToolExposure(Direct/Deferred/Hidden)Schema/校验:JSON Schema + strict 标志(校验在 API 侧);apply_patch 用 lark freeform 语法 并行调用: parallel_tool_calls:true恒开;FuturesOrdered边流边执行;per-toolsupports_parallel_tool_calls;执行闸门 RwLock错误处理: RespondToModel(回传继续)/Fatal(终止)二分审批门控:UnlessTrusted/OnRequest/Granular 五开关/Never;guardian 评审器;审批缓存
gemini-cli
注册机制: BaseDeclarativeTool+BaseToolInvocation两阶段;按模型家族差异化声明Schema/校验:JSON Schema + Ajv 并行调用:Scheduler 状态机批量并行; wait_for_previous参数让模型显式控制串行;tail-call 替换错误处理:ToolErrorType 分类;错误以 functionResponse 回传;STOP_EXECUTION 终止流 审批门控:shouldConfirmExecute → MessageBus → 策略引擎;「Always Allow」可收窄为命令前缀/参数模式
qwen-code
注册机制:tool-registry + 懒注册(computer-use 35 工具) Schema/校验:JSON Schema 并行调用: partitionToolCalls:安全工具合批并行、非安全串行([Read,Read,Edit,Read]→[[R,R],E,R])错误处理:tool-error/guard/xml-tool-call-fallback(解析模型 XML 方言) 审批门控:五档 ApprovalMode,默认 AUTO = LLM 分类器三层过滤,自修改面强制过分类器
opencode
注册机制: Tool.defineEffect Schema + 本地.opencode/tool/*+ 插件工具Schema/校验:Effect Schema(可附 JSONSchema7);InvalidArgumentsError 自动生成改写指引 并行调用:AI SDK step 内并发(unbounded),每 callID 独立 Deferred 错误处理:repairToolCall 大小写纠正 → invalid 靶工具;doom_loop 检测触发 permission ask 审批门控:三层通配规则 last-match-wins;ask→UI;always 会话内解锁排队;reject 带 feedback 回传模型
kimi-code
注册机制:builtin 工厂 + zod schema → JSON Schema;描述 .md?raw 导入 Schema/校验:zod 双向 并行调用:ToolAccesses 资源冲突感知调度:无冲突并发、冲突等待、结果按 provider 序回传 错误处理:每 call 必有配对 result;失败回传要求先诊断 审批门控:manual/yolo/auto + DSL 规则( Bash(rm *))+ 18 策略链;session-runtime 记忆
deepseek-harness
注册机制: defineTool(schema DSL + render 投影);工具目录由代码生成(启动每个插件读 schema)Schema/校验:JSON Schema DSL;白名单只给模型 name/description/parameters 并行调用:独占屏障 + 有界滚动池(默认 10) + 启动前重分类 + 模型序提交 + 取消补合成结果 错误处理:管线:pre-execute→守卫→approval→execute(超时/重试 around 包装)→post-execute(accept/block/replace) 审批门控:per-session ask/never,fail-closed(缺席即拒绝);permission-presets
oh-my-pi
注册机制:BUILTIN_TOOLS 工厂 + omptype schema + markdown 描述注入 Schema/校验:自研 omptype(TypeBox 风格) 并行调用:per-tool concurrency: shared/exclusive:exclusive 串行屏障、shared 并行;跳过调用补合成结果错误处理:ToolError/ToolAbortError 区分超时与取消;未配对调用合成结果保 provider 配对 审批门控:三层(工具 tier + 参数级 policy + 用户覆盖);全局 always-ask/write/yolo(默认)
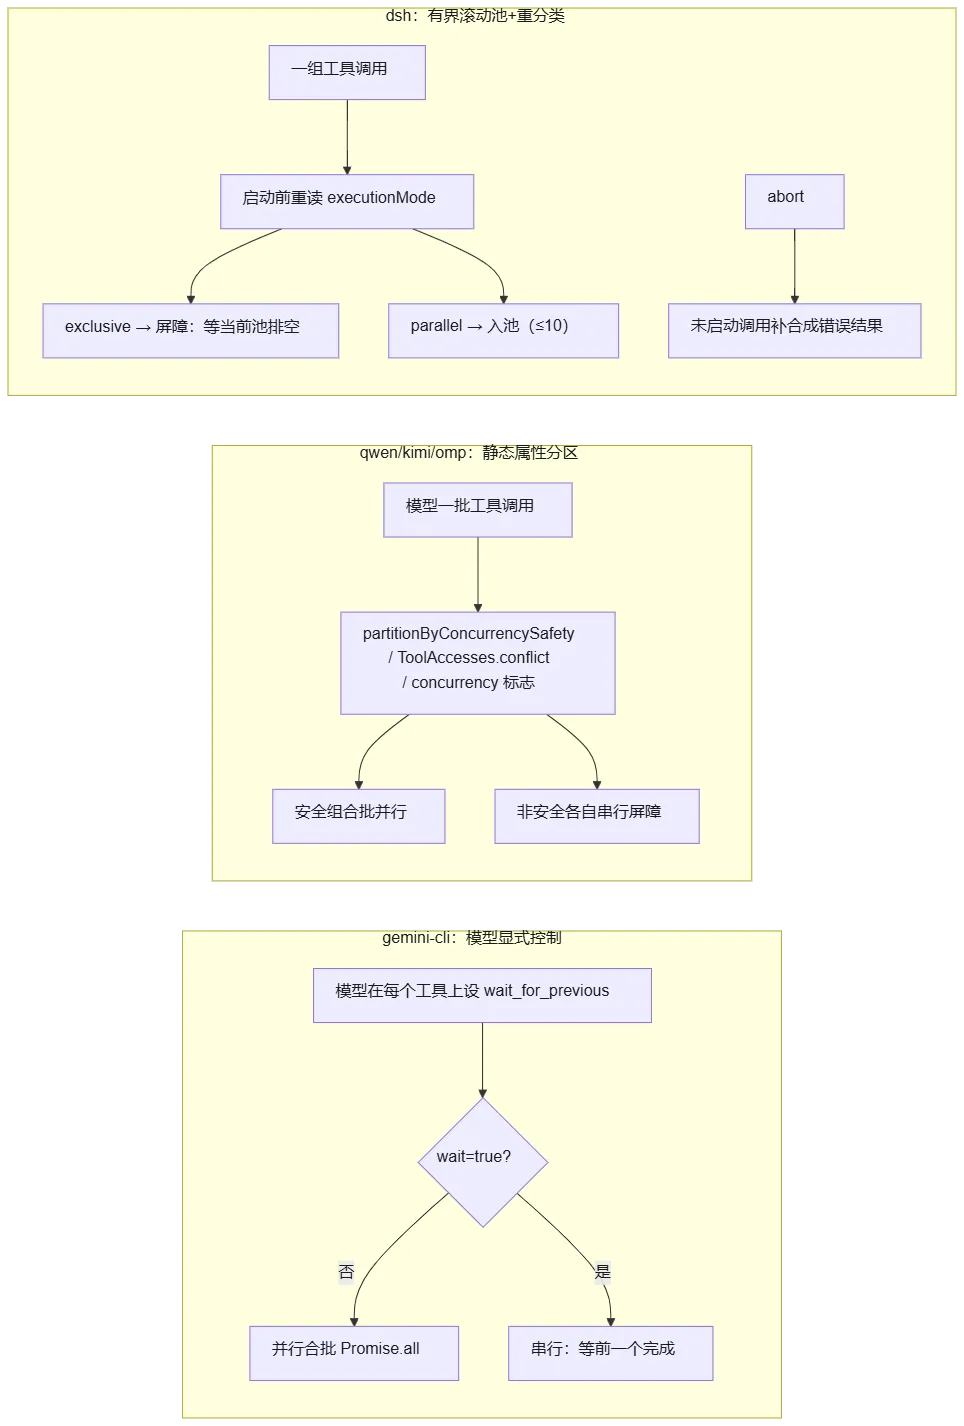
七家在工具调用上的分化集中在三个轴线上:
注册与可见性,「模型一次能看见多少工具」被各家当作核心治理问题。codex 用
ToolExposure把「声明 / 可发现 / 隐藏」三态做成 trait 方法,让工具能按 surface 差异化暴露;dsh 用defineTool的 schema DSL + render 投影,把「给模型看的白名单」与「运行时完整定义」分开;omp / kimi 用工厂 + schema(omptype / zod)在构造时定型;opencode 用 Effect Schema 把校验内建进Tool.define。共同点:都意识到「把全部工具一次性塞给模型」会污染 prompt 与降低调用准确率,于是演化出 deferred / 白名单 / 工具搜索等机制。并行调度,这是分歧最大的一轴,存在四种范式:
- 模型显式控制
(gemini-cli wait_for_previous):把串/并的决定权交给模型,灵活但依赖模型自觉。 - 静态属性分区
(qwen partitionToolCalls、kimiToolAccesses、ompconcurrency):按工具的资源/副作用属性静态归类,安全合批并行、不安全串行,可预测、可证明无冲突。 - 流式边到边执行
(codex FuturesOrdered):工具一从流里析出就tokio::spawn入队,边收边跑,结果按入队序回传。 - 有界滚动池 + 重分类
(dsh):并行度有界(默认 10),每个调用启动前重新读 executionMode,独占调用形成屏障、并行调用滚动入池,取消时为未启动调用补合成结果。 审批门控,分化的轴是「缺省即放行还是缺省即拒绝」(fail-open vs fail-closed):
- fail-closed
:dsh( ask缺审批支持即转 deny)、codex(UnlessTrusted默认对未受信项目要求审批)。 - fail-open
:omp(默认 yolo)、kimi(hooks fail-open)、gemini-cli(OnRequest模型自觉)。 - 中间态
:qwen 的 AUTO模式用 LLM 分类器在「自动放行只读」与「人工确认危险」之间动态裁决,是七者中唯一把审批决定权部分外包给一个独立 LLM 调用的设计。
并行工具三种语义对比(mermaid)
内置工具面广度(大类计数)
为便于手机浏览,七家拆成两张表。
| LSP 6.7k 行 | |||
| cron/loop/monitor | |||
| image_gen/CUA 35 工具/mobile | |||
| LSP 14 ops + DAP 28 ops | ||||
| cron(抖动防齐射) | schedule(事件日志原生) | |||
上面两张表按九大能力大类横比七家。多数大类(文件/搜索、shell/PTY、计划/待办、网络)各家都有,差异在「特色标注」,即某家在该类上做了独有的深化。下文只解释带特色标注或有数字的项;普通「✔」不赘述。
文件/搜索类
- omp ✔(+AST 编辑/ast-grep)
:omp 除 read/edit/write 外,有 ast_grep(tools/ast-grep.ts,基于 ast-grep 的结构化代码搜索/重写)与ast_edit(tools/ast-edit.ts,AST 级编辑),比文本级 edit 更精确,不依赖 LSP。codex 的 apply_patch 是 freeform diff(见 §1.3),omp 的 ast_edit 是 AST 投影,路线不同。
shell/PTY 类
- codex ✔ unified_exec
:见 §1.10,交互式进程执行框架,带审批/沙箱/重试编排。 - gemini-cli ✔ + 后台 shell
:见 §2.10,shell 不活动超时转后台,配套 list/read background 工具。 - kimi ✔(超时自动转后台)
:kimi 的 bash 工具超时后转后台进程(类似 gemini-cli),让长跑命令不阻塞 turn。 - dsh ✔ bash/pwsh/持久 PTY/terminal
:dsh 支持 bash、PowerShell、持久 PTY、terminal 工具。 - omp ✔ brush 内嵌 + PTY
:见 §7.8,vendored brush-core Rust shell,内嵌而非 spawn 外部。
代码智能类
- codex tool_search
:codex 的工具搜索工具,让模型按需发现 deferred 工具(见 §1.2 的 Deferred exposure),避免一次性塞满工具列表。 - qwen LSP 6.7k 行
:见 §3.7,统一 lsp工具,12 ops,代码量 7270 行(NativeLspService 1650 + lsp.ts 1224 + types.ts 646 等)。 - opencode lsp(实验)
:见 §4.9,9 ops,无 diagnostics/rename/codeActions。 - dsh lsp
:dsh 有 LSP 工具。 - omp LSP 14 ops + DAP 28 ops
:见 §7.9,LSP 14 ops(含 rename_file/code_actions/raw request)、DAP 28 ops(七者唯一)。
计划/待办类
- kimi Plan + TodoList + Goal 状态机
:kimi 有 Plan、TodoList 工具,外加 Goal 状态机(goal 是 kimi 独有的长期任务抽象,有状态迁移)。 - dsh plan/todo/goal
:dsh 也有 goal。 其余各家 plan/todo 普遍有,不赘述。
子代理类
- codex multi_agents(实验)
:codex 的多 agent 工具,实验性。 - gemini-cli invoke_agent + A2A 远程
:gemini-cli 的 invoke_agent工具 + A2A(Agent-to-Agent)远程协议。 - qwen agent/team/arena
:qwen 的子代理有 agent、team、arena 三种形态。 - opencode task(general/explore)
:opencode 的 task 工具,分 general 与 explore 两种子代理类型。 - kimi Agent/AgentSwarm×128
:见 §5.7,AgentSwarm 单批最多 128 个子代理,批独占。 - dsh 5 provider 子代理接缝
:dsh 支持 5 个 provider 的子代理接缝。 - omp task + hub + advisor + IRC
:omp 有 task、hub(子代理中心)、advisor(只读顾问子代理)、IRC(IRC-backed 并行协调)。
定时/自治类
- qwen cron/loop/monitor
:qwen 有 cron、loop、monitor 三种自治工具。 - kimi cron(抖动防齐射)
:见 §5.8,确定性 per-task 抖动防 thundering herd。 - dsh schedule(事件日志原生)
:见 §6.8,schedule 走共享会话持久化屏障, schedule/change是原生会话事件。
网络类
- omp web_search 23 provider 链
:见 §7.10,23 个 provider,按 SEARCH_PROVIDER_ORDER链式 fallback。 其余各家 web_search/web_fetch 普遍有(1-3 个 provider),不赘述。
多模态类
- codex view_image
:codex 的图像查看工具。 - qwen image_gen/CUA 35 工具/mobile
:qwen 有 image_gen(图像生成)、CUA 35 工具(见 §3.1)、mobile(移动端自动化)。 - kimi ReadMediaFile(视频)
:kimi 的 ReadMediaFile 支持视频。 - dsh read_image
:dsh 的图像读取。 - omp browser/computer/tts/语音
:见 §7.11,browser + computer + tts + WebRTC 语音 + inspect_image,七者多模态面最广。
记忆类
- codex memories(ext)
:codex 的记忆工具(扩展)。 - gemini-cli save_memory
:gemini-cli 的 save_memory 工具。 - qwen memory 体系
:qwen 的记忆体系。 - dsh session_ 5 工具
*:dsh 的 5 个 session_* 记忆工具。 - omp retain/recall/reflect/learn
:omp 的记忆四件套,retain(存)、recall(取)、reflect(反思)、learn(学习),是七者中最结构化的记忆工具集。
7. 重连与容错
codex
重试策略:200ms×2^n×jitter;默认 request 4 次/stream 5 次;尊重 Retry-After 流中断处理:流关闭未 completed 显式报错;连接级无限重试(5s 起翻倍封顶 60s) 超时:stream_idle 300s、ws connect 15s 特色:WebSocket→HTTPS 传输降级; x-codex-turn-statesticky routing
gemini-cli
重试策略:maxAttempts 10、5s 起 30s 封顶、±30% jitter;不重试 400;SSL 错误码谱系 流中断处理:mid-stream 4 次重试 + RETRY 事件让 UI 丢弃半截渲染;InvalidStreamError 9 类 超时:shell 不活动超时 特色:持续 429 → 自动降级 Flash 模型;配额错误分类
qwen-code
重试策略:1.5s 起 30s 封顶;持久模式:6 小时绝对上限 + 30s 心跳 流中断处理:InvalidStreamError 6 类内容级重试(协议标签泄漏/畸形工具调用/降级响应…) 超时:流不活跃超时设计文档 特色:Qwen 配额耗尽检测;模型降级事件;循环检测
opencode
重试策略:2s 起×2×0.25 jitter、30s 封顶、5 次;retry-after(-ms) 优先;5xx 全重试 流中断处理:onInterrupt 收尾 + 孤儿 tool 清理 超时:MCP 30s、bash 参数级 特色:重试状态对用户可见(session status=retry 倒计时)
kimi-code
重试策略:10 次、0.5s 起 32s 封顶、25% jitter(设计意图:扛过典型过载窗口 2~3 分钟) 流中断处理:溢出→缩窗→压缩→重试循环(3 轮熔断) 超时:subagent 2h、hook 30s fail-open 特色:Retry-After 优先;x-trace-id 全链归因;goal 技术失败统一 paused
deepseek-harness
重试策略:maxRetries 2、0.5s 起 10s 封顶、10% jitter;五类可重试码;另有无限档 流中断处理:流空闲看门狗 5 分钟映射 TIMEOUT;EMPTY_RESPONSE 视为错误 超时:streamIdleTimeoutMs 300s 特色:重试本身落会话日志(llm/retry 事件可审计);MCP 独立退避重连
oh-my-pi
重试策略:分类重试(AIError.classifyMessage);8s 封顶×75~100% jitter 流中断处理:replay 安全判定:已产出可见内容的流禁止盲目重试 超时:工具级 timeout 模块 特色:凭据轮换重试 + fallback chains(降级链 delay=0 获全新预算);MAX_PAUSED_TURN=8 防失控
七个项目都会重试,重连/容错策略的差异在于为谁优化,可分三类:
- 配额毛刺友好型
(qwen-code、gemini-cli、kimi-code),服务对象是免费/配额型 API 的真实工况。特征是大预算(10 次起)、长封顶(30s~6h)、专门处理配额耗尽/模型输出协议污染,并把「模型本身降级输出」也当成可重试错误。它们假设后端会持续 429 若干分钟,所以宁可等也不让用户看到失败。 - 严格短重试型
(codex、deepseek-harness、opencode),假设后端是自建/付费稳定服务,重试预算小(2~5 次)、封顶短(10~30s),失败快速上抛。但各自有「逃生阀」:codex 给连接级错误开无限重试 + 传输降级;dsh 把重试审计化;opencode 把重试状态透传给用户。 - 副作用安全型
(oh-my-pi),唯一把「流已产出可见内容时能否盲目重试」当成一等问题处理的项目,并引入凭据轮换/降级链让重试跨「凭据边界」获得全新预算。
一个共性:没有项目实现 turn 内断点续跑(原报告点评已指出),重试都是「整请求重发」,所以「重试是否安全」取决于「重发会不会产生重复副作用」。omp 的 replay 安全判定解决的就是这个问题,其余项目处理较粗。
8. 系统提示词与指令遵循
codex
组装方式:base_instructions(Responses instructions 字段)+ 模型目录下发指令 指令文件层级:AGENTS.md 根→cwd 全拼 + override 动态注入: <environment_context>XML(cwd/shell/网络域名/沙箱)+ 30+ context fragment覆盖/定制:base_instructions/compact_prompt 可配;规范版按模型族指令模板由服务端下发,仓库仅持 fallback(详见下文订正) 安全姿态:guardian 评审 + sandbox tags 多语言:英文
gemini-cli
组装方式:PromptProvider 分 section(可开关)+ modern/legacy 双份 指令文件层级:GEMINI.md 四层 + MEMORY.md 动态注入:日期/git/IDE 差分上下文/topic/技能/子代理清单 覆盖/定制:GEMINI_SYSTEM_MD 整体替换 + 导出 安全姿态:注入消毒(去换行/括号)+ safety checker 多语言:英文
qwen-code
组装方式:分层 layers + interaction mode(interactive/headless/acp) 指令文件层级:QWEN.md 层级 + rules 动态注入:IDE 上下文、hook 输出标签、记忆召回前后插 覆盖/定制:QWEN_SYSTEM_MD/IDENTITY_MD 覆盖 安全姿态:「Denied Tool Calls 不得绕道」条款 + 标签转义 多语言:UI 9 locale + 输出语言文件(核心提示词英文)
opencode
组装方式:agent.prompt 或按模型族 14 份 base prompt(claude/gpt/codex/gemini/kimi…)+ 折叠两段利缓存 指令文件层级:AGENTS.md/CLAUDE.md 首类命中 + 就近目录挂载 动态注入: <env>块、MCP instructions、skills、SessionReminders覆盖/定制:自定义 agent frontmatter 安全姿态:content-filter 转错误(无主动过滤) 多语言:英文
kimi-code
组装方式:system.md 模板 + {{变量}} + profile 体系(coder/explore/plan) 指令文件层级:AGENTS.md 用户级+项目级(不读 CLAUDE.md) 动态注入:contextInjector 对账重放 + appendSystemReminder 两通道(其余注入被约束) 覆盖/定制:agent.yaml extends 派生 安全姿态: <system-reminder>权威性声明 + 拒绝绕行多语言:语言跟随用户
deepseek-harness
组装方式:PromptSection 按 order 组装 + waterfall 指令文件层级:AGENTS.md/CLAUDE.md + local 覆盖,字节预算 动态注入:PromptContext 缓存安全快照 + agent.inject() 覆盖/定制:persona 段遮蔽、preset 组合、complete 段独占 安全姿态:未发现内容安全过滤(guard 是循环卫生) 多语言:英文模板 + UI locale
oh-my-pi
组装方式:Handlebars 模板 + personality 三套 + 块级去重 指令文件层级:.omp/AGENTS.md + 继承 8 种外部约定 + sticky rules 动态注入:日期/plan 状态/aside 消息/magic keywords(代码块内不触发) 覆盖/定制:模板文件直接可改 安全姿态:反注入声明(XML 标签语义 + system-directive 保护)+ secrets 混淆(可选)+ Harmony 泄漏检测 多语言:英文
七家的系统提示词组装方式可归入四类递进范式,越往后「可组合性 / 可审计性」越强,但实现门槛也越高:
- 单串拼接 + 服务端下发(codex)
,一个 instructions字段(Responses API 的instructions)承载整段系统提示词;该字段的「规范版本」由模型目录(服务端)按模型族 + personality 下发instructions_template,本地仅持 fallback。运行期上下文以 30+ 个 fragment 各自带 XML 标签注入。这是最「贴近 API 原语」的范式:系统提示词就是一个字符串,所有动态信息靠追加 fragment 实现。 - 分 section 组装 + 可开关(gemini-cli / qwen-code / opencode)
,把系统提示词拆成若干命名 section,每个 section 有 guard(条件渲染)或 order(排序),由一个组装函数统一拼接。gemini 的 withSection(key, factory, guard)、qwen 的SystemPromptLayers、opencode 的provider()按模型族分派都是这一类。优点是单点持有 section 顺序、条件渲染成本低。 - 模板变量({{var}})+ profile 体系(kimi-code)
,系统提示词是一个带 {{ KIMI_* }}占位符的system.md模板,变量值由运行期上下文(OS/shell/now/workdir/AGENTS.md/skills/plugins)填充;profile 体系(agent/coder/explore/plan)通过extends派生不同人格与工具集。模板化让「同一段提示词在不同部署形态下复用」。 - DSL 组装 + waterfall(deepseek-harness)
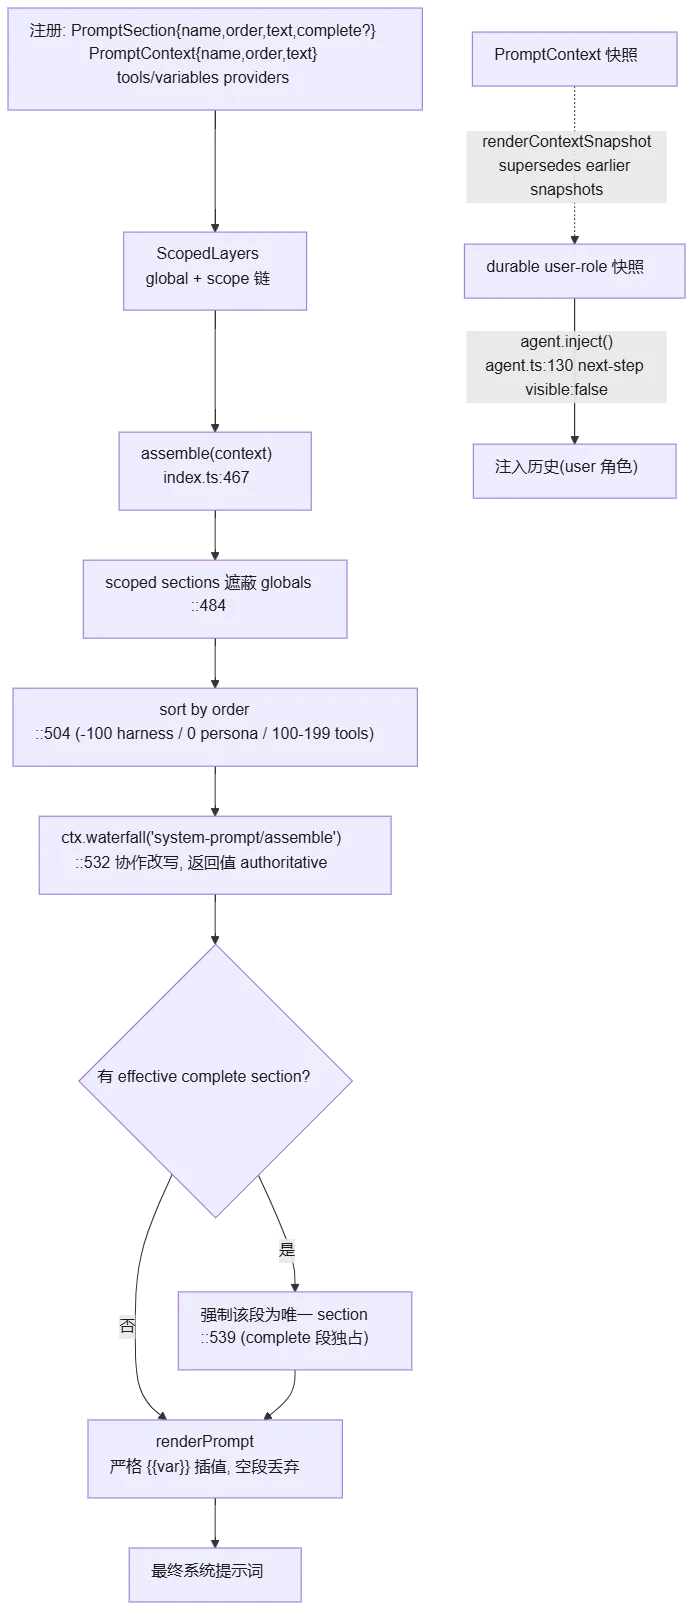
,提示词是一个注册表: PromptSection(带 order)+PromptContext(动态快照)+ 工具 provider + 变量 provider,由assemble()排序后跑一个 Cordiswaterfall协作事件让插件改写,最后renderPrompt插值。这是最「框架化」的范式:提示词本身是一个可被插件横切的数据结构。
注入防御的谱系则是三层递进,但没有一家做到独立的提示注入检测模型层:
- 变量消毒(被动)
:gemini 对注入路径上的字符串做 \n/]替换(防止伪造[...]marker)、qwen 对<system-reminder>标签做零宽字符归一 + 转义、kimi 对 goal 文本包<untrusted_objective>+escapeUntrustedText。本质是「用户内容进 prompt 前先消毒」。 - 契约声明(主动)
:omp 在系统提示词里写明「XML 标签语义 + <system-directive>在 user turn 仍为系统指令」、qwen/kimi 写明「<system-reminder>是权威系统指令,优先级高于用户输入」、codex guardian 写明「transcript delta 当作 untrusted evidence 对待」。本质是「用提示词契约教模型区分系统内容与用户内容」。 - 运行时拦截(事后)
:omp 的 Harmony 泄漏检测(扫描 assistant 消息里泄漏的带内协议标记并恢复)、qwen 的 Denied Tool Calls 条款(拒绝绕道)、各家的 loop guard(dsh 的 repeat-tool-reminder、omp 的 thinking-loop-redirect)针对的是「行为漂移」而非「注入」。没有任何项目在「工具结果入历史前」插独立注入检测层,这是共同敞口。
附:两张机制图
opencode 按模型族分派 base prompt + 折叠两段利缓存
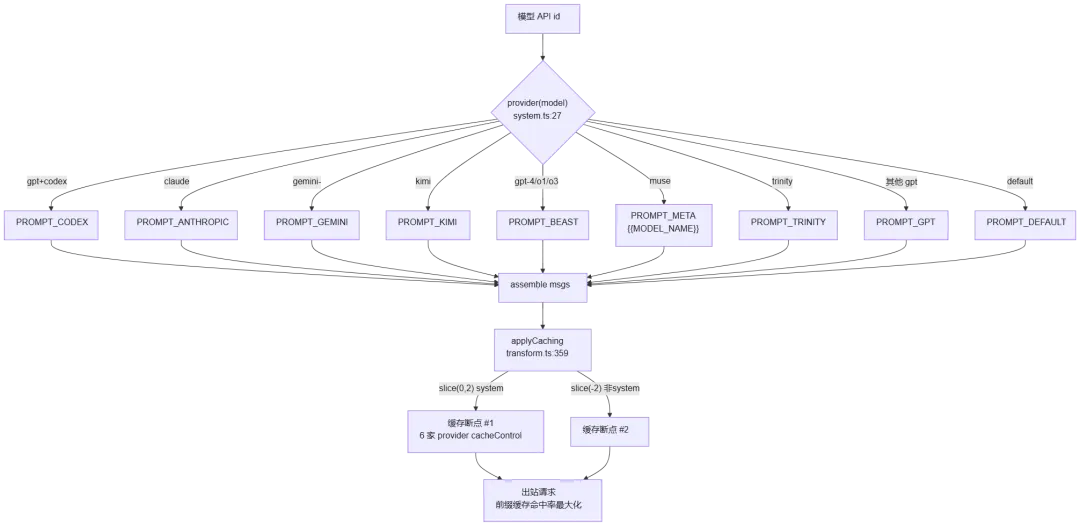
图 2:deepseek-harness 的 PromptSection order + waterfall 组装
9. 思维链与工作流编排
codex
thinking 支持:ReasoningEffort 9 档 + 加密思维链跨请求保持 Plan 模式:Plan mode + update_plan(展示/追踪型) 子代理:multi_agents v2(实验,继承父 turn 全套策略) 工作流引擎:codex exec/app-server 协议 + cloud-tasks;无声明式工作流 可观测性:OTel + tracing span + analytics
gemini-cli
thinking 支持:thinkingConfig per-model + Thought 事件 Plan 模式:plan ApprovalMode + 只读工具集 子代理:invoke_agent + 内置 4 agent + A2A 远程子代理 工作流引擎:hooks 8 事件(可阻断/改参);next-speaker/loop-detector 双 LLM 裁判 可观测性:OTel 全家桶 + GCP exporter + 分角色记账
qwen-code
thinking 支持:enable_thinking/thinking_budget/vLLM 逐分支 + 5 档统一 effort Plan 模式:enter/exit_plan + 批准计划历史打码 子代理:subagent(CC parity)+ Agent Teams(mailbox+权限桥) + Arena 多模型竞技 工作流引擎:workflow orchestrator(预算/journal 重放/stall 自愈)+ Goals + cron 可观测性:OTel 全套 + daemon metrics + event-loop-lag
opencode
thinking 支持:reasoning part 流式 + 独立计数 Plan 模式:plan mode(实验,只写 plans 目录) 子代理:task(general/explore)+ background(实验) 工作流引擎:自定义 slash command + ACP;无引擎 可观测性:结构化日志 + OTLP + SSE 事件流 + debug 命令组
kimi-code
thinking 支持:thinking effort + keep;Kimi extra_body 适配 Plan 模式:EnterPlanMode/ExitPlanMode + plan 模式写保护(只能写 plan 文件) 子代理:Agent + AgentSwarm(模板批量×128、爬坡并发) + tower(实验) 工作流引擎:Goal 状态机(active/paused/blocked/complete)+ 三维预算 + cron 可观测性:wire.jsonl 内嵌请求 trace + vis 回放 + kimi-inspect
deepseek-harness
thinking 支持:reasoning effort 选择 + replayState Plan 模式:plan 模式(log-only 状态,软引导)+ exit_plan_mode 审批 子代理:6 provider 接缝(含 codex/claude-code 子代理)+ report 回传 + 深度预算持久化 工作流引擎:workflow:模型编写 JS 编排脚本(worker+vm) + ralph 迭代 + schedule 可观测性:40+ 运行时不变量 + OTel + request/header 可重建
oh-my-pi
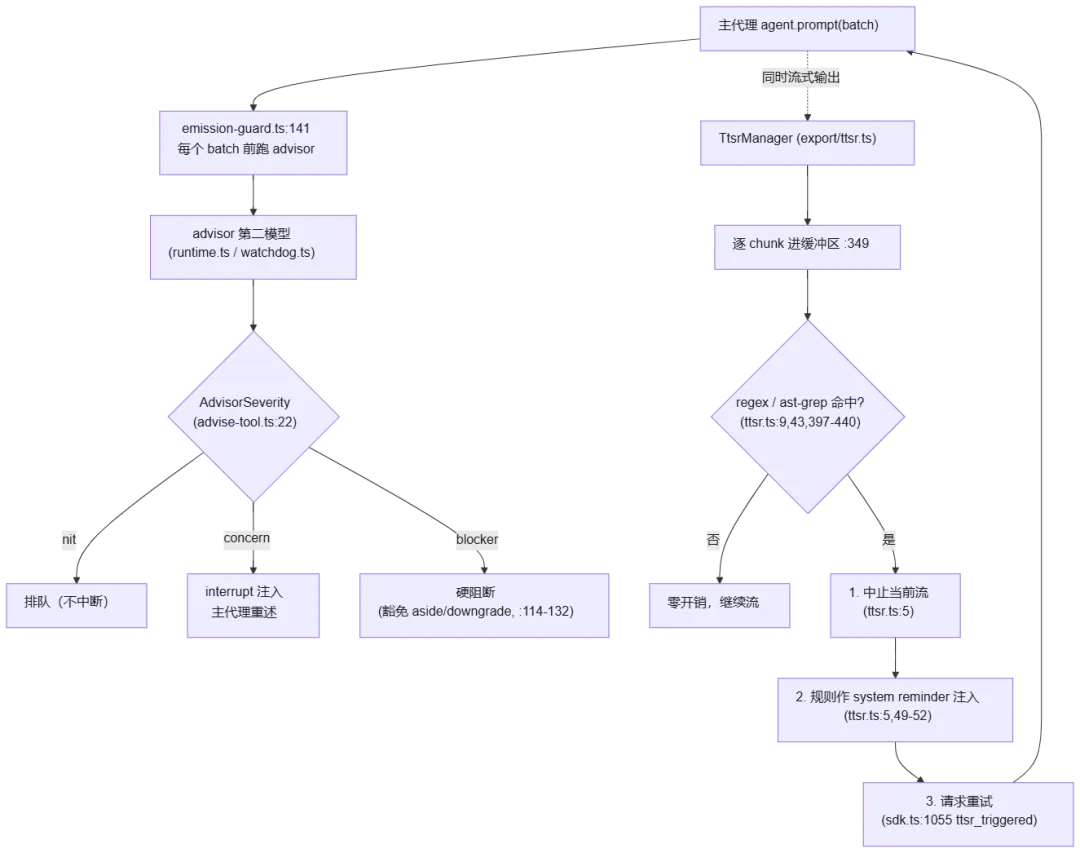
thinking 支持:ThinkingLevel 8 档 + ultrathink 关键字 Plan 模式:plan 模式 + 独立 plan 模型角色 + handoff 子代理:task(worktree/pi-iso 隔离 + 结构化输出 schema 校验)+ hub 名册 工作流引擎:advisor(第二模型逐轮监督可硬阻断) + IRC + workflowz(agent/parallel/pipeline DSL)+ TTSR(流内命中即中止-注入-重试) 可观测性:OTel GenAI span + 本地 stats 看板 + 火焰图 profiler
七家在「让模型怎么想、怎么计划、怎么分工、怎么编排」这四件事上的谱系分化很清晰,越往右「运行时对模型行为的约束与纠偏」越强:
思维链(thinking)的暴露与续接,三类范式:
- 服务端加密、客户端续接(codex)
:请求里带 include: ["reasoning.encrypted_content"],把模型上一轮的加密思维块原样回传,跨请求续接但客户端不可读。 - 协议字段 + 事件流(gemini-cli / qwen-code / kimi-code)
:用 thinkingConfig/enable_thinking/thinking.keep等协议字段开关与定档,思维以Thought事件 / reasoning part 流式吐给前端并独立计 token。 - 统一档位 + 关键字越级(dsh / omp)
:把各家 provider 不同的 effort 字段归一成一个内部档位阶梯,再用 ultrathink这类 magic keyword 让用户一句话顶到最高档。 Plan 模式的两种语义,沿「软引导 → 硬隔离」递进:
- 软引导(dsh / qwen)
:plan 状态只是注入一段 guidance 提示词 + log-only 会话状态,沙箱/审批策略独立运作,计划本身不强制执行。 - 工具层硬隔离(opencode / kimi)
:plan 模式在权限策略层 deny 所有编辑工具,只放行 plan 文件目录;kimi 更精确到「只能写当前 plan 文件」。 - 展示/追踪型(codex update_plan)
:plan 是一个 TODO/checklist 工具,模型调用它更新步骤状态、UI 展示,但不参与执行约束(且在 codex 自己的 Plan mode 里反而被禁用)。 子代理的隔离与治理,从「同一进程继承父策略」到「独立上下文第二模型监督」:
- 继承型(codex multi_agents v2)
:子代理全盘继承父 turn 的模型/provider/effort/审批/沙箱策略。 - 协议型(gemini A2A / dsh 6 provider 接缝)
:把子代理抽象成可插拔 provider,含远程 A2A agent、claude-code/codex 子代理。 - 隔离型(omp task / kimi AgentSwarm)
:子代理在 CoW 工作区副本上干活,产物 diff 回主区;kimi 批量拉到 128 个 + 爬坡并发。 - 监督型(omp advisor)
:第二模型逐轮审主代理输出,可发 blocker硬阻断,七家中唯一的「独立上下文监督」设计。 工作流引擎的成熟度,从「无引擎」到「模型自己写编排脚本」:
- 无声明式工作流(codex / opencode)
:只有 exec/app-server 协议或 slash command + ACP,没有 DAG/pipeline 引擎。 - 运行时编排器(qwen / kimi)
:journal 重放 + stall 自愈 + 三维预算 + Goal 状态机 + cron 的「准工作流」。 - 模型即编排者(dsh)
:模型用 eval/Cordis 写 JS 编排脚本,跑在node:vm沙箱 + worker 线程里,ralph 负责迭代执行,能力上限最高、调试门槛也最高。 - DSL + 流内纠偏(omp)
:workflowz 关键字触发确定性多子代理工作流(eval 里 agent()扇出),TTSR 在流内用 regex/AST 命中即中止-注入-重试,实现「按需上下文」纠偏。
附:两张机制图
kimi-code 的 Goal 状态机 + 三维预算
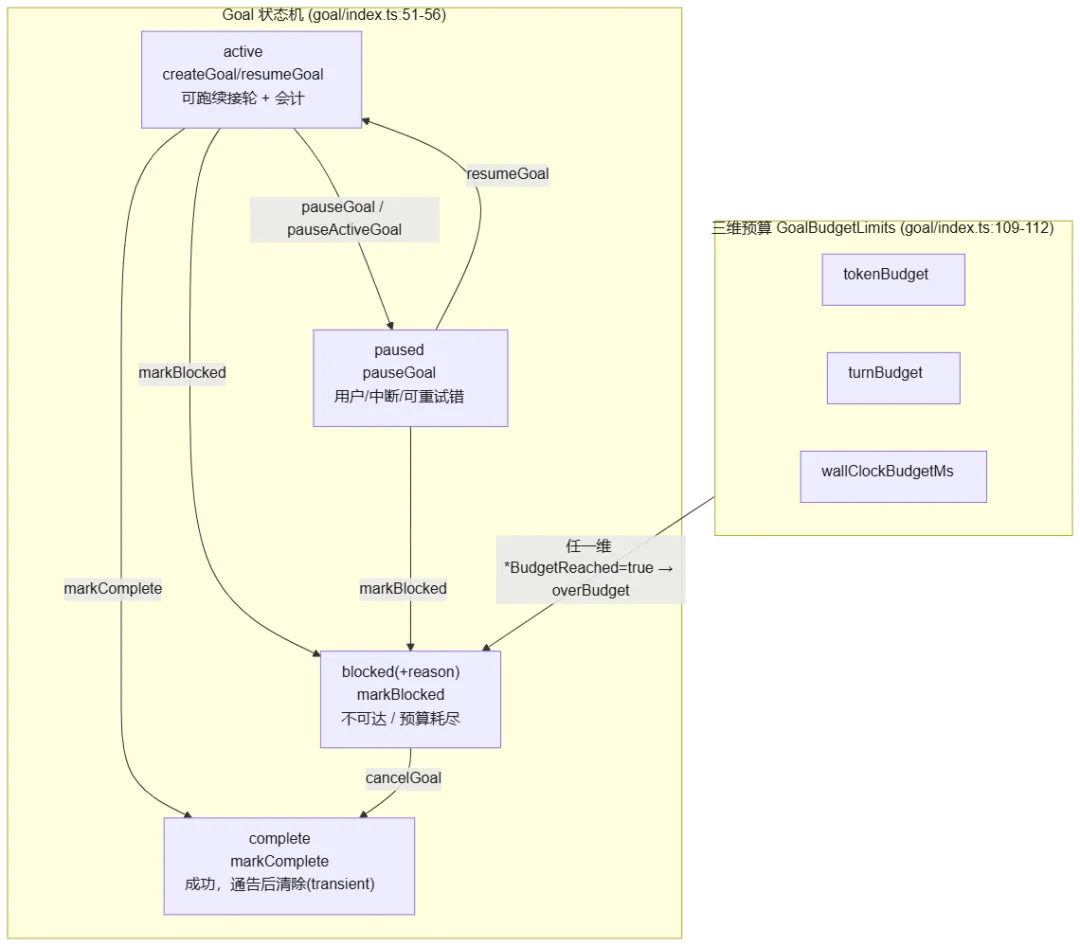
注:kimi GoalStatus 是 4 态(active/paused/blocked/complete);qwen 的 GoalStatus 是 5 态(多一个
usage_limited,goals/goal-protocol.ts:49-54)。两者状态机同源但档位不同。
oh-my-pi 的 advisor 逐轮监督 + TTSR 流内纠偏
10. 其他关键维度
性能设计
| 6 家 provider 显式缓存断点 | |
| prompt_cache_key 会话亲和(Kimi/OpenAI/Anthropic 全注入) | |
七家在「让长会话的每一轮都命中前缀缓存」这一工程问题上分化为三档:
- 把缓存断点放置当一等工程问题
(opencode、oh-my-pi):opencode 在协议无关层写统一的 CachePolicy,omp 专门设计 append-only 上下文 + fork 缓存身份继承,把「稳前缀」做进数据结构。 - 吃 provider 原生缓存但做会话亲和
(codex、kimi、qwen):用 prompt_cache_key/metadata.user_id把同一会话的请求钉到同一缓存槽,再加 fork 探针或断点标记。 - 只读不写
(gemini-cli、deepseek-harness):gemini 吃 Gemini 隐式缓存只读 cachedContentTokenCount;dsh 连断点都不碰,只把 provider 返回的 cache 字段透传进账本。
点评:opencode 与 omp 把「缓存断点放置」当成一等工程问题(opencode 跨 6 家 provider 写断点策略、omp 为缓存命中率设计 append-only 上下文与 fork 缓存身份继承),这类优化的 ROI 在长会话中可观(缓存读价通常 10%)。gemini-cli 只吃隐式缓存、dsh 完全不碰断点,是明显的优化空间。性能评测注意:gemini-cli 是唯一有公开 perf 基线回归框架的(冷启动/CPU/长会话恢复),其余项目的性能数字均不可横向引用。
可扩展性
codex
MCP:client(3 传输+OAuth)+ 自身即 MCP server 自定义工具:extension tools/hooks/plugins/skills 多 provider:仅 Responses API 兼容(chat wire 已移除) SDK/API:Python + TS SDK(包装 app-server) 独特扩展面:execpolicy 策略语言、connectors、marketplace
gemini-cli
MCP:client(4 传输+OAuth/SA 冒充) 自定义工具:MCP/SDK 注册/扩展 discovered 多 provider:Gemini 中心(OpenAI 兼容有限) SDK/API: @google/gemini-cli-sdk独特扩展面:a2a-server(自身作为 A2A agent)、ACP 模式、devtools
qwen-code
MCP:client 3 传输 + OAuth + 连接池 + daemon 动态增删 自定义工具:extensions(含 claude/gemini/qoder 格式转换器)+ hooks + skills 多 provider:4 套生成器:OpenAI 兼容/Anthropic/Gemini/Qwen OAuth + 12 provider 预设 SDK/API:TS/Python/Java 三 SDK 独特扩展面:channels 9 IM、desktop、CUA、mobile-mcp、audio
opencode
MCP:client 3 传输 + OAuth + roots + 状态机 自定义工具:npm/本地插件 15 钩子 + .opencode/tool/*多 provider:models.dev 目录 75+(文档数)+ 自定义 provider 配置 SDK/API:OpenAPI 生成 SDK + Effect client + 嵌入式 sdk-next 独特扩展面:HttpApi 单源生成全端、share 云服务
kimi-code
MCP:client 3 传输 + 进程级共享 OAuth + 脱敏投影 自定义工具:plugins(manifest+GitHub zip 安装)+ skills + hooks 多 provider:6 协议(kimi/anthropic/openai×2/google/vertex)+ models.dev 导入 SDK/API:node-sdk + klient 契约 facade 独特扩展面:kap-server REST/WS(experimental)、ACP 双实现
deepseek-harness
MCP:仅 client(无 server 侧) 自定义工具:defineTool + extensions 运行时自修改(opt-in) 多 provider:DeepSeek 官方 + pi-ai 第三方目录 + OpenAI 兼容 SDK/API:JSON-RPC SDK(TS/Python)+ ACP server + API gateway 独特扩展面:skill 6 级目录链、hooks 兼容 CC/Codex、e2b 云沙箱
oh-my-pi
MCP:client 完整 + 发现 5 家 IDE 的 MCP 配置 自定义工具:custom tools 工厂 + extensions + marketplace 多 provider:13 wire API + 69 provider 目录 + owned dialect 兜底(无工具调用模型走带内协议) SDK/API:Bun/Node SDK(createAgentSession) 独特扩展面:ACP、browser-relay、语音(WebRTC live)、collab 加密直播
点评:provider 开放性排序:omp > opencode > qwen > kimi > gemini-cli > dsh > codex,codex 砍掉 chat wire_api 后,接第三方模型必须自建 Responses 兼容代理,这是明确的生态收紧信号。omp 的 owned dialect(给无原生工具调用的模型伪造带内工具协议 + 伪造结果检测)是独家能力,意味着它能把任何会聊天的模型变成 agent。dsh 的反向问题是第一方只有 DeepSeek 路由,跨生态要靠 pi-ai 第三方库(其依赖治理中被特别豁免)。
生态与社区
- 提交强度
:dsh(8.8k/月)≫ omp(4k)> codex(1.2k)≈ qwen(1.1k)> opencode(396)> kimi(310)≫ gemini-cli(75)。dsh/omp 的高强度与少数核心贡献者组合,意味着路线图高度受控于单一团队,对使用者是双刃剑(演进快但方向不可控)。 - Issue 治理
:gemini-cli(556 open/442 贡献者)最健康;codex 13k open 是规模问题;opencode 4k open 需关注;dsh 0 open 是强清理策略。 - 文档国际化
:opencode(README 22 语言 + docs 16 语言 + locale 同步 CI)与 dsh(双语 blob-hash 配对门禁,中文文档与英文同等权威)是标杆;qwen 中文文档主源在外部站点;codex 文档外迁到官网(离线不友好)。
文档与上手难度
codex doctor;用户低 / 开发者高(100+ crate) | ||
| 97 篇结构化 docs + settings schema 代码生成 | ||
| 生成目录(tool-catalog 1873 行等)+ cookbook + postmortem | ||
| 80+ 篇子系统级文档 |
点评:文档与代码同步机制上,dsh(生成目录 + 门禁校验)> gemini-cli(schema 生成)> opencode(openapi 生成),生成式文档是大型 agent 项目的必然选择,手写目录(omp 80+ 篇)的维护成本会随版本漂移。上手难度最低的是 gemini-cli/kimi-code(开箱即用、概念少),最高的是 dsh(需理解 profile/bundle/seam 词汇表)。
安全与权限控制
codex
OS 沙箱:Seatbelt / Landlock+seccomp / Win 受限令牌(三原生) 网络管控:MITM 代理 + 域名 allow/deny + 凭据代理 审批模型:Granular 五开关 + guardian 企业管控:10 层配置栈 + MDM + requirements.toml 敏感数据保护:keyring 加密凭据 + process-hardening 安全文档:SECURITY.md(Bugcrowd)
gemini-cli
OS 沙箱:Docker/Podman/sandbox-exec/bwrap/Win 原生 四后端 网络管控:沙箱内网络策略 审批模型:四档 + 五级 TOML 策略引擎 + Always-Allow 收窄 企业管控:Admin>User>Workspace>Extension>Default 策略带 敏感数据保护:路径 checker 硬编码屏蔽 .git/.env 安全文档:SECURITY.md(Google VRP,5 日响应)
qwen-code
OS 沙箱:Docker 镜像 + macOS .sb 六套 网络管控:— 审批模型:五档(默认 AUTO 分类器)+ allow/ask/deny 规则 企业管控:trusted folders + daemon trust policy 敏感数据保护:memory secret-scanner + team secret-guard 安全文档:SECURITY.md(阿里云盾)
opencode
OS 沙箱:无(SECURITY.md 明示) 网络管控:— 审批模型:通配规则三层 + reject-feedback 企业管控:enterprise 策略包(存在但轻量) 敏感数据保护:.env 读取需确认(默认) 安全文档:SECURITY.md 含威胁模型
kimi-code
OS 沙箱:无 OS 沙箱 网络管控:kap-server loopback+token 审批模型:manual/yolo/auto + 18 策略链 企业管控:workspace trust 门控 MCP 敏感数据保护:敏感文件硬过滤(.env/密钥/凭据,防注入外泄) 安全文档:SECURITY.md
deepseek-harness
OS 沙箱:bwrap/Landlock、Seatbelt、Win ACL(仅文件效果,不管网络/进程) 网络管控:明确不在词汇表 审批模型:ask/never fail-closed + 审计事件 企业管控:credentials 引用化(值不落配置) 敏感数据保护:凭据每次操作重解析 + describe 不暴露 安全文档:无独立 SECURITY.md(有 sandbox 子系统文档)
oh-my-pi
OS 沙箱:pi-iso 工作区隔离(APFS CoW/overlayfs/ProjFS),隔离对象是工作区,不约束系统调用 网络管控:— 审批模型:三层 tier,默认 yolo 企业管控:profiles 敏感数据保护:secrets 混淆(默认关) 安全文档:无 SECURITY.md
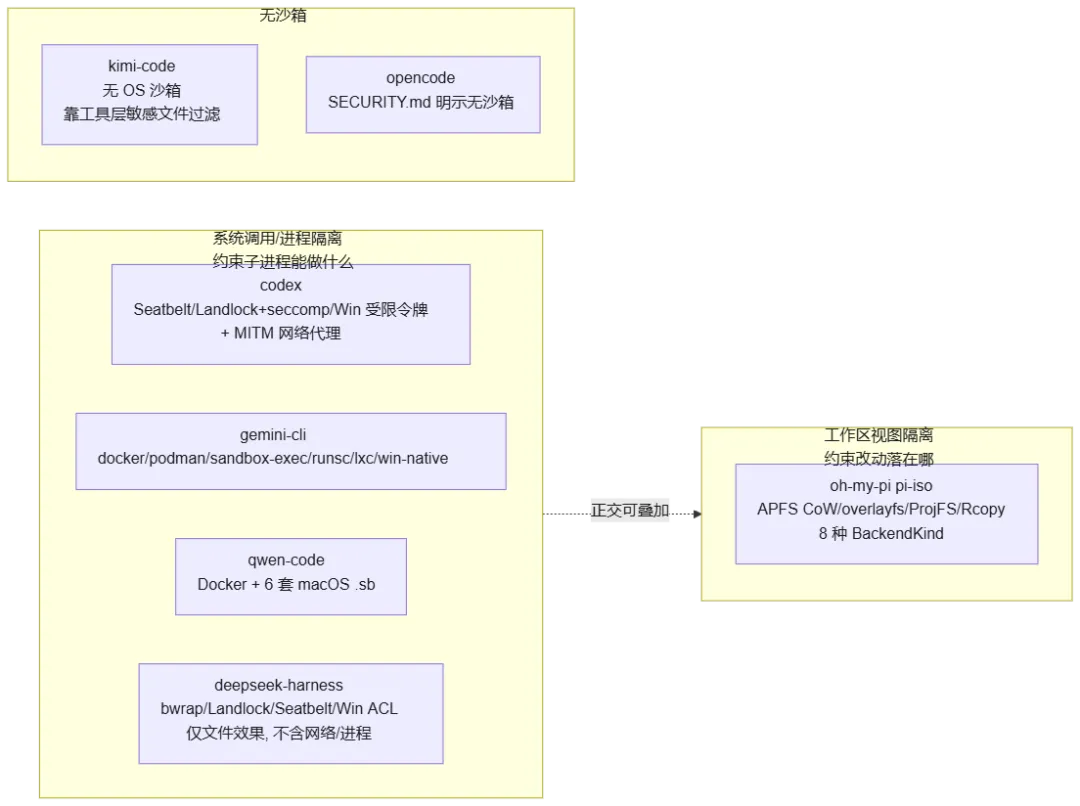
七家的「沙箱」实指两种正交的隔离:
- 系统调用/进程隔离
(codex、gemini-cli、qwen、dsh):用 OS 原生机制(Seatbelt/Landlock/seccomp/Win 受限令牌/Docker/bwrap)约束子进程能做什么,能调哪些 syscall、能访问哪些文件路径、能连哪些网络。目标是「agent 逃逸到系统」。 - 工作区文件系统视图隔离
(oh-my-pi 的 pi-iso):给子代理一个工作区的 CoW 副本干活,产物 diff 回主工作区。约束的是「agent 改坏本地仓库」,不约束子进程系统调用,子代理在副本里仍能任意执行命令,只是改动被隔离在副本里。
两者正交,理想方案是叠加(omp 补上 Landlock 层就完整)。
点评:
- 默认审批姿态谱系
:fail-closed(dsh)→ ask 默认(codex OnRequest、opencode、gemini default)→ AUTO 分类器(qwen)→ yolo 默认(omp)。给非专家用户的产品必须改默认值,omp/kimi 的 yolo/auto 适合开发者自用,不适合托管服务。 - kimi-code 的敏感文件硬过滤
值得点名:它直接在工具层阻止读写 .env/私钥/凭据文件,注释明说目标是「被注入的 prompt 无法外泄凭据」,这是七个项目中唯一把「防提示注入外泄」落到工具策略的代码。其余项目要么靠沙箱(codex 网络 deny)要么没有。
11. 评分卡与综合对比总表
维度权重与评分(1–5 分,基于 §3–§10 证据)
为便于手机浏览,评分表拆成两张。
| 5.0 | ||||
| 5.0 | ||||
| 5.0 | 5.0 | |||
| 5.0 | ||||
| 5.0 | ||||
| 5.0 | 5.0 | |||
| 5.0 | ||||
| 加权总分 | 4.37 | 4.62 | 4.19 | 4.33 |
| 5.0 | |||
| 5.0 | |||
| 5.0 | |||
| 4.5 | |||
| 5.0 | |||
| 5.0 | |||
| 加权总分 | 3.78 | 3.93 | 4.56 |
能力 × 成熟度象限
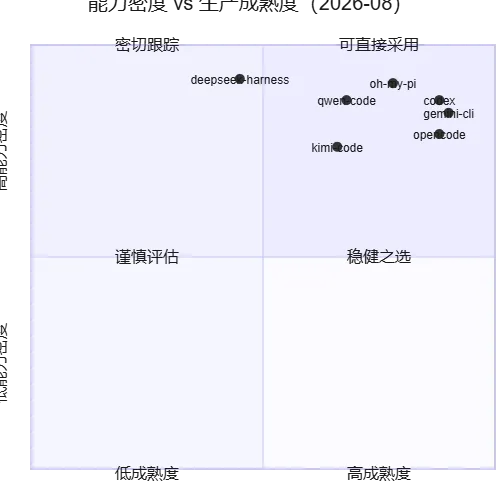
成熟度依据:版本阶段与兼容承诺(dsh 明示破坏性变更、SESSION_FORMAT_VERSION=0;kimi v2 刚转默认;opencode/codex/gemini 已长期迭代)、生态规模、文档完备度。
综合对比总表(全维度速查)
同样拆成两张表。
| auto-memory 体系 | ||||
| SQLite 事件溯源 | ||||
| 6h 持久档 | ||||
| 三平台原生 | ||||
| 事件日志双后端 | |||
| 有界滚动池 | |||
| Swarm×128 | |||
| 13 API+69 目录 | |||
| fail-closed | |||
12. 共性模式提炼
七个项目高度趋同的部分(可视为 2026 年 Agent Harness 的事实标准):
- ReAct 主循环 + 类型化事件流
:无论 Rust/TS,都是 loop { 采样 → 工具批执行 → 结果回灌 },UI 经事件流解耦。差异仅在事件粒度(dsh 到 chunk、gemini 到 turn event)。 - LLM 摘要压缩 + 尾部保留
:全部实现,差异在阈值(§4.1)与摘要提示词(qwen 的 <state_snapshot>、dsh/opencode 的结构化模板、kimi 的第一人称 handoff)。 - AGENTS.md 分层指令
:7/7 支持 AGENTS.md 或同族文件,用户级 → 项目级层级合并是标配;CLAUDE.md 兼容 5/7。 - MCP 作为通用扩展总线
:7/7 实现 MCP client(stdio/HTTP/SSE 变体),工具名空间 mcp__server__tool一致;仅 codex 同时是 MCP server。 - plan 模式 + 子代理
:7/7 有 plan 概念,6/7 有子代理;差异在隔离与预算治理(§9)。 - JSONL/SQLite 持久化 + resume/fork
:会话可恢复是底线能力。 - OTel 可观测性
:7/7 集成(kimi 默认开启需注意隐私)。
细微差异如何改变结果(选型时要盯住的三个「魔鬼细节」):
- token 估算系数
:决定压缩时机在中文场景偏移方向(gemini 高估偏早、kimi/qwen 低估偏晚、opencode/dsh 居中)。 - 并行工具的取消语义
:用户中断时,dsh/omp 会为未执行调用补合成结果保证历史可重放;gemini/qwen 依赖事后修复。长会话稳定性差异由此而来。 - 审批 fail-open/closed 与默认档位
:决定它能否直接放进托管服务(只有 dsh/codex 的默认姿态可托管)。
结语
这七个项目展示了开源 Agent Harness 的三条演化路线:向系统要纵深(codex/omp 的 Rust 化与沙箱)、向架构要可审计性(dsh/opencode/kimi-v2 的事件溯源)、向生态要覆盖面(qwen/kimi 的全端产品线)。没有全能冠军:
要当下可用的最强综合:deepseek-harness(接受 preview)或 oh-my-pi(接受宽松默认安全)。 要生产稳妥:codex / gemini-cli / opencode 三选一,按模型生态定夺。 要特定模型的最优体验:跟着模型走(Qwen→qwen-code、Kimi→kimi-code、Gemini→gemini-cli)。
对 Agent 开发者的三条通用启示:其一,上下文治理决定长任务上限,优先选择有「裁剪/落盘/多方法链」的项目,纯摘要方案在超长会话中信息损失不可逆;其二,事件溯源值得作为自研架构的默认选择,fork/resume/审计/UI 回放全部免费获得;其三,安全默认值必须显式设定,七个项目的默认审批姿态从 fail-closed 到 yolo 不等,托管部署前务必逐项核对。