ARTICLE · 979411
AI 算力网络拓扑与光模块:科普图解
AI 算力网络拓扑与光模块:科普图解
一份功能部件图 + 相关性图 + 连接注释的入门手册
原文是一份 AI 算力网络课程的口播纪要,核心话题是:"为了把成千上万颗 AI 芯片连成一台超级计算机,行业正在用什么拓扑?"这会直接决定每个芯片需要几根线、用铜还是用光、以及光模块厂能接到多少订单。
下面用 5 张图把这些抽象概念拆开:每张图先讲「它是什么」,再讲「它跟别的部件怎么连」。
一、5 张功能部件图 + 连接注释
图 1 3D Torus 机柜:64 颗芯片怎么放进一个柜子
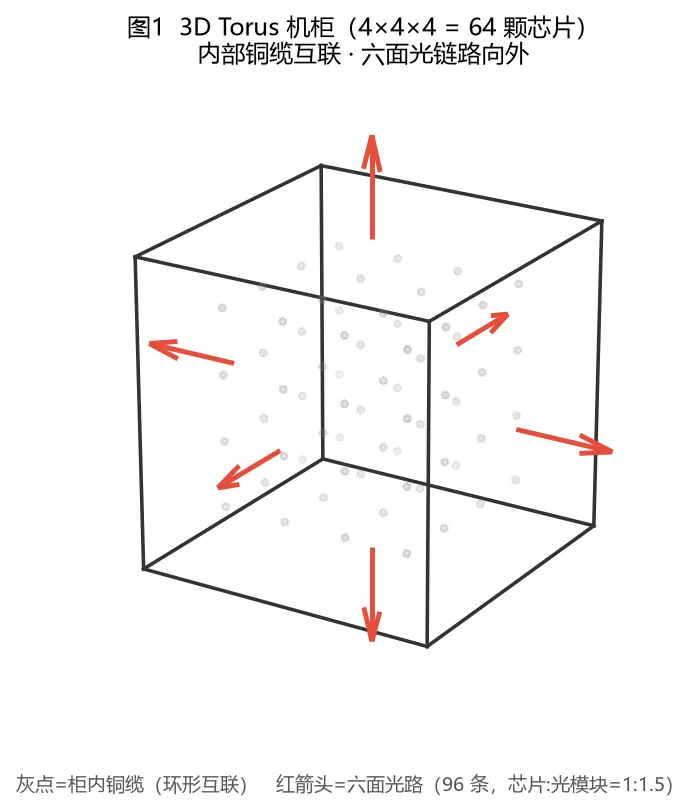
把芯片排成 4×4×4 的「小立方体」,相邻芯片用灰色铜缆相连;柜子六个面各有红色光路伸出去,跟别的柜子继续连。这就叫「柜内铜、柜间光」的 3D Torus 最小单元。
→ 连接逻辑:拓扑(怎么排)决定了每个芯片能直接说上话的邻居数量和方向;方向越多,柜外光路越多。
图 2 6D Torus:柜子之间也走 Torus,全光
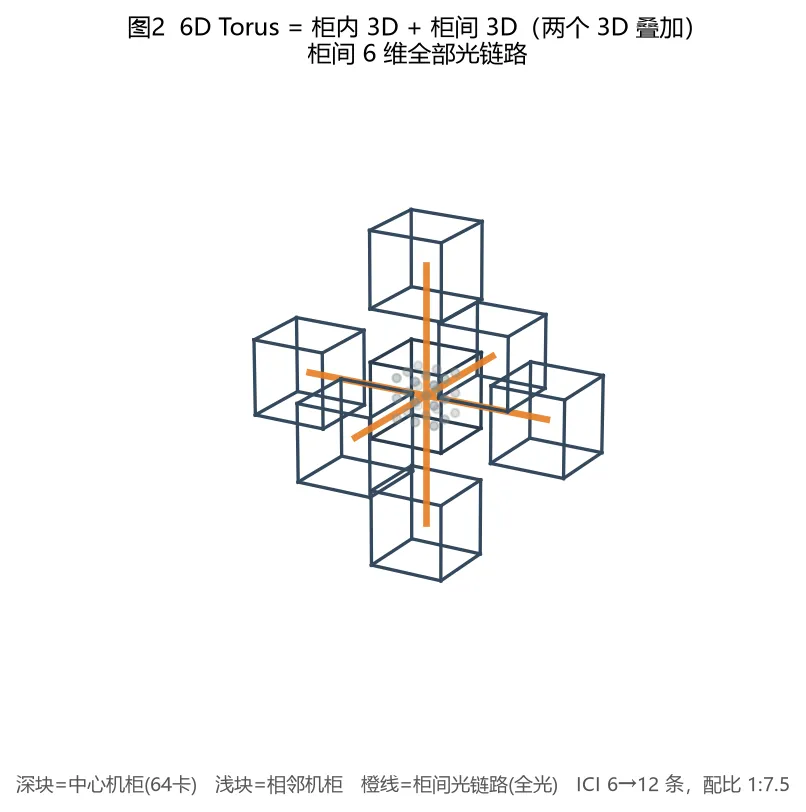
6D 相当于「柜内 3D + 柜间 3D」两个立方体叠在一起。中心机柜和 6 个方向上的相邻机柜用橙色全光链路相连;柜内灰色铜缆密集互联,柜间只能走光。
→ 连接逻辑:维度从 3 升到 6,芯片的「邻居」从本柜扩展到隔壁柜;柜间距离远、损耗大,必须用光模块代替铜缆。
图 3 芯片与光模块的配比关系
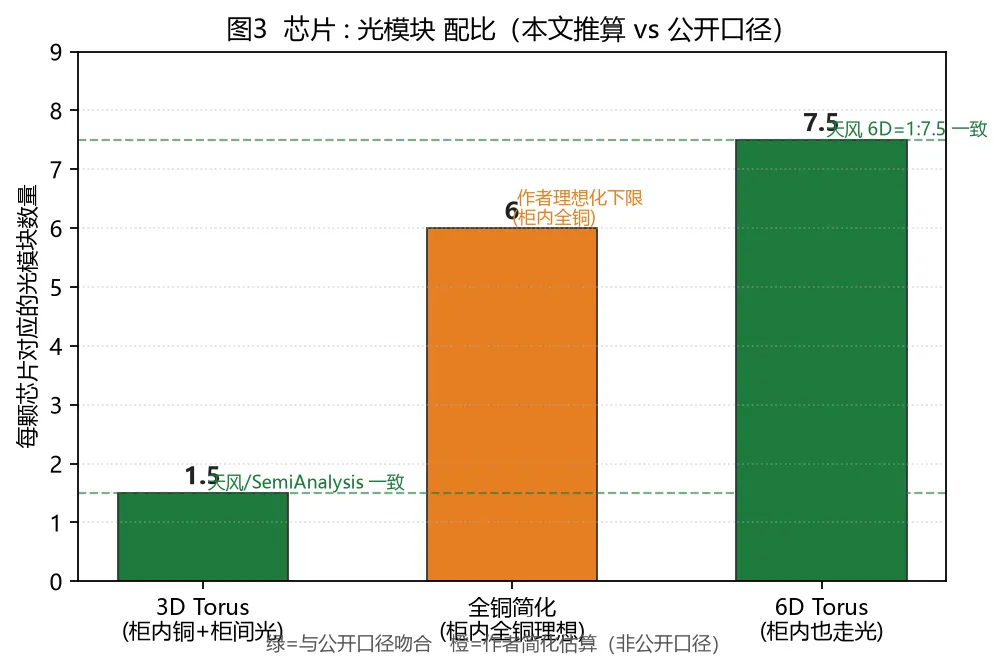
3D Torus 时,每颗芯片对应 1.5 个光模块;如果柜内也全走光,理想化下限是 1:6;6D 全光时,比例上升到 1:7.5。配比越高,光模块厂订单越肥。
→ 连接逻辑:拓扑升维 → ICI 链路数增加 → 芯片:光模块配比提高 → 光模块需求放大。
图 4 OpenAI 自研芯片的供应链与定位
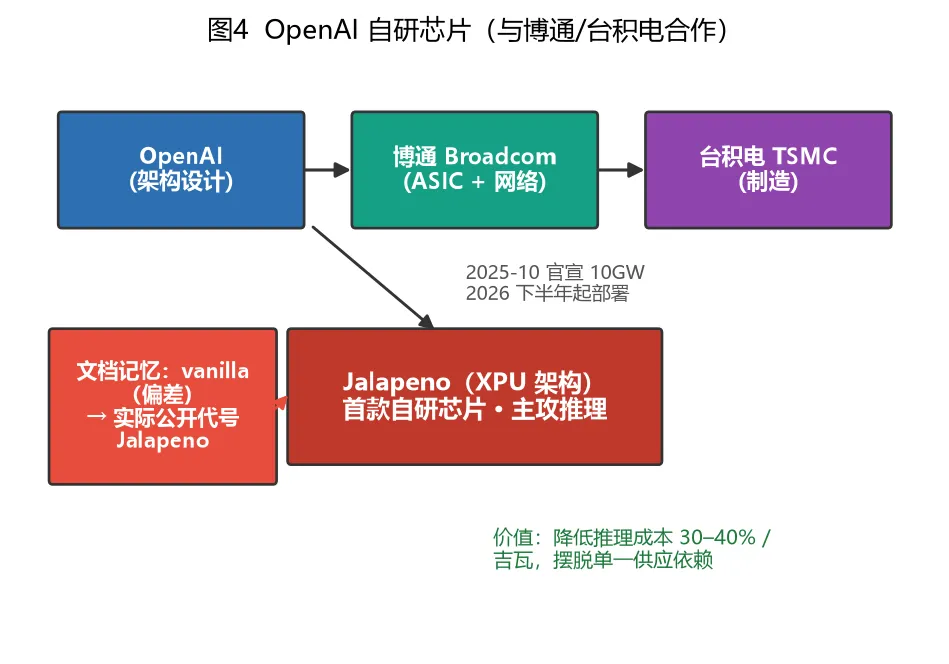
OpenAI 做自研芯片(公开代号 Jalapeno,XPU 架构),由博通做 ASIC 和网络、台积电制造,主攻推理侧降本;文档里提到的 vanilla 属于记忆偏差。
→ 连接逻辑:自研芯片是巨头降低对英伟达依赖的并行路线;无论英伟达还是自研芯片,只要做大规模集群,都需要拓扑、铜缆、光模块这一套。
图 5 功能部件相关性总图
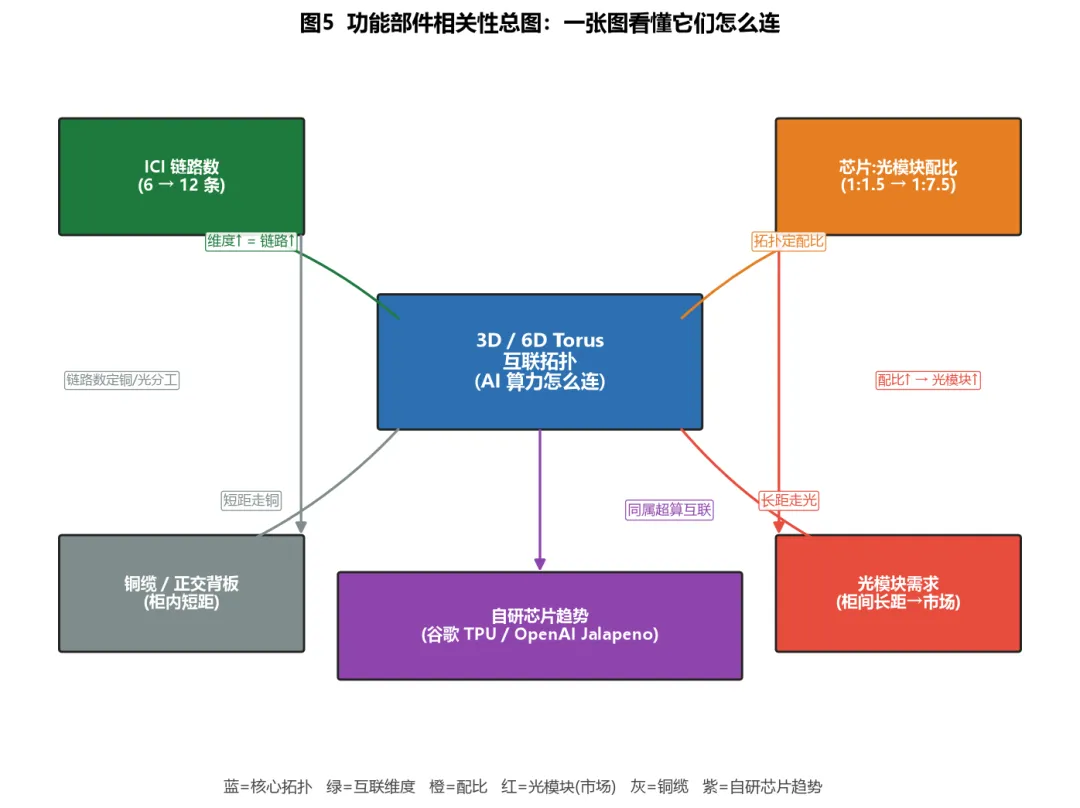
把前 4 张图串成一张关系图:拓扑是起点,链路数、配比、铜/光分工、光模块需求、自研芯片趋势都被它串起来。
→ 连接逻辑:看不懂这张图时,回到这句话——「拓扑决定每颗芯片要和谁说话、走多远、用什么介质」。
二、串讲:从一张卡到一座数据中心
1. 一张 AI 加速卡(GPU/TPU/XPU)本身只会算,要组成超级计算机,必须先解决「怎么连」的问题。
2. 连线方式就叫「拓扑」。3D Torus 是先在机柜内部把 64 张卡排成立方体,相邻用铜缆连;6D 是再把这个立方体往外复制一层,柜子之间用光纤连。
3. 拓扑升维带来最直接的后果:每颗芯片需要维护的「邻居」变多。在 3D 里,一颗芯片主要和本柜 6 个方向邻居说话;到 6D,还要再加 6 个跨柜方向,ICI 链路从 6 条变 12 条。
4. 链路变多,芯片:光模块配比就抬高。3D 铜+光是 1:1.5;6D 全光会到 1:7.5——意味着同样的芯片数量,6D 集群要消耗 5 倍的光模块。
5. 为什么是「铜」和「光」?铜便宜、省电,但只能跑短距离(柜内厘米级);光贵、耗电,但能跑长距离(柜间几十米到百米)。所以拓扑越往外扩,光模块越多。
6. 光模块配比最终影响产业链:谷歌 TPUv9、OpenAI Jalapeno 等自研芯片只要做大集群,都要买大量光模块,光模块厂成为拓扑升维的直接受益者。
7. 怎么判断这类信息靠不靠谱?记住三条:是不是官方数字?专家口径有没有前后打架?数字是「已发生」还是「预估」?原文是单一信源口播,应只作参考,不能单独下注。
三、相关性一览表
把图 5 里的箭头换成文字,方便快速查阅:
A(因) | B(果) | 连接关系 |
拓扑 | ICI 链路数 | 维度越高,每个芯片要维护的邻居链路越多(6→12) |
拓扑 | 芯片:光模块配比 | 拓扑直接决定每颗芯片需要几个光口(1:1.5→1:7.5) |
ICI 链路数 | 铜缆/正交背板 | 短距离、柜内、低功耗场景优先走铜 |
ICI 链路数 | 光模块需求 | 长距离、柜间、低损耗场景只能走光 |
芯片:光模块配比 | 光模块需求 | 配比越高,同样芯片数下光模块总需求越大 |
自研芯片趋势 | 拓扑/光模块 | TPU/Jalapeno 做大集群同样要走这套互联方案 |
四、10 个名词速查(小白版)
名词 | 一句话解释 |
Torus(环面) | 把芯片/服务器排成首尾相连的环或立方体,每个点都能快速找到邻居。 |
3D/6D | D 指 Dimension(维度)。3D = 长×宽×高;6D = 把两个 3D 网络再嵌套一层。 |
ICI | Inter-Chip Interconnect,芯片之间的互联通道,越多维度链路越多。 |
光模块 | 把电信号转成光信号、让光纤传输的小盒子;算力集群的「长距离高速公路」。 |
铜缆/背板 | 柜内短距互联,便宜省电,但距离一长信号就衰减,只能近距离用。 |
配比(芯片:光模块) | 一颗芯片配几个光模块。1:1.5 就是 64 颗芯片配 96 个光模块。 |
正交背板 | 机柜内部把芯片和连接器交叉连起来的高密度铜连接板。 |
OCS | 光电路开关,谷歌 TPU 集群里用来动态改变光路的交换设备。 |
XPU | 行业对非英伟达 AI 加速芯片的统称,如 TPU、Jalapeno 等。 |
流片/量产爬坡 | 芯片设计完成后先做测试片(流片),再逐步提高产量(爬坡)。 |
五、看这些图时要注意什么
• 本文所有数字来自产业链调研/专家预估,非英伟达、谷歌、OpenAI 官方指引。
• 光模块配比会随具体机型、走线方式、是否用 OCS 而变,1:1.5 和 1:7.5 只是某一路径的简化口径。
• OpenAI 自研芯片公开代号是 Jalapeno;原文中 vanilla 属于记忆偏差,方向对、名字错。
• 6D Torus 目前主要是谷歌 TPU 路线;英伟达 GPU 机柜用的是 NVLink/NVSwitch,配比逻辑不能直接套用。
• 单一信源口播纪要只能作为「产业体感」参考,投资或决策请交叉多源信息。