ARTICLE · 980336
免费试用|本地个人全文数据库软件“拾光书栈 ”发布
一、《拾光书栈》概述
个人私藏在电脑中的很多电子文档,却始终没有真正利用起来?查找翻阅文献费时费力,试试把个人藏书变成可检索的知识网络。想找一句曾经读过的话,只记得大概意思,却不知道它在哪一本书、哪一页?面对扫描版文献、民国文献和繁体竖排资料,普通PDF阅读器无法搜索,手工整理又耗时费力?
拾光书栈,就是为这些真实问题而设计的一款Windows本地文献管理与阅读工具。它把本地文献导入、OCR识别、文字校对、全文检索、文本阅读、笔记和关联发现放进同一个系统,让散落在硬盘里的资料逐渐成为一座真正可以使用的个性化全文数据库。
与通行的公开AI、智能体、软件不同,本软件所有数据均留在本地,不用担心您珍贵的数据会外泄或变成公有!
二、构建你的个人数据库:功能介绍
1、文件夹批量导入、重复文件识别
从“保存了一份PDF”到“拥有一份可用的文献”很多扫描版文献只有一页页图片。它们可以翻阅,却不能检索,也无法快速定位内容。拾光书栈建立了一套完整的文献处理流程:
批量导入 → OCR 识别 → 人工校对 → 全文检索 → 阅读与研究
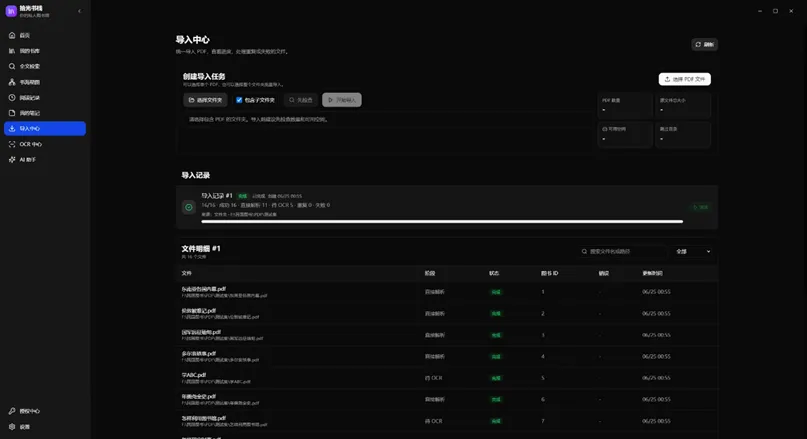
用户可以选择单个PDF,也可以直接选择文件夹批量导入;文件夹内有多级目录时,还可以选择是否包含子文件夹。即使面对几千本、上万本资料,也能通过任务队列持续处理,并在导入中心查看任务状态。
系统会先判断PDF是否已经包含文字层。已有文字层的双层PDF可以直接解析入库,无须重复OCR;纯扫描PDF则进入OCR中心等待识别,减少不必要的处理时间。
2、本地OCR与全文检索
面向繁体竖排文献的OCR工作流:近代图书识别的难点,不只是“认出一个字”。对于繁体竖排文献,更重要的是尽量识别完整的文字区域,并保留文字框位置和阅读顺序。
拾光书栈当前采用自主研发识别方案,无需独立显卡即可运行。识别过程会保存页面、文本和文字位置,为后续校对、书内搜索高亮以及双层PDF合成提供基础。
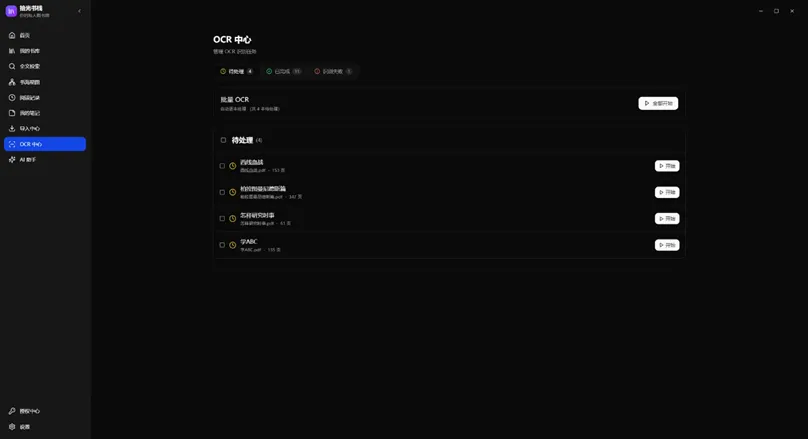
OCR中心支持:
-单本识别与批量识别;
- 开始、暂停、继续和中断恢复;
- 已完成页面保留,继续时从原进度接着处理;
- 根据设备内存自动控制运行压力;
- 导入与 OCR 任务互斥运行,降低长时间批处理时的资源冲突;
- 异常日志记录,方便快速定位运行环境和识别故障。
3、OCR行级校对与文字补录
识别不是终点,校对才让文字真正可靠。任何OCR都可能出现错字、漏字和文字顺序问题,尤其是版式复杂的历史文献。因此,拾光书栈没有把OCR结果当作不可修改的最终答案,而是提供了独立的校对中心。
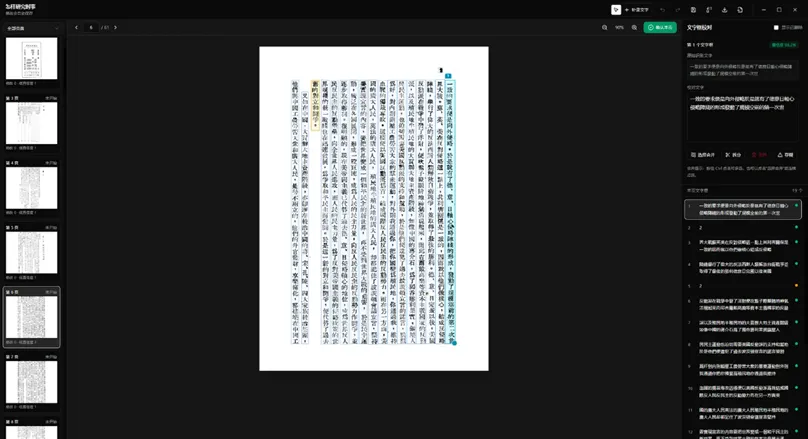
校对窗口将原始页面、文字框和文本列表放在同一工作区。点击页面中的文字框,右侧列表会自动滚动到对应内容;点击文本,也可以反向定位页面位置。用户能够修改文字、补录漏识别内容、调整横排或竖排方向,并通过多选合并被错误拆开的文字框。
校对后的内容会更新到文献数据中,使后续全文检索、书内搜索和导出结果更加准确。
4、图书管理及分类
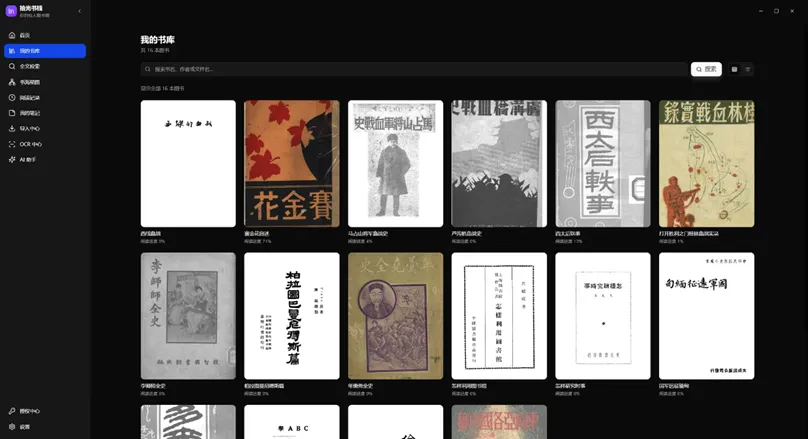
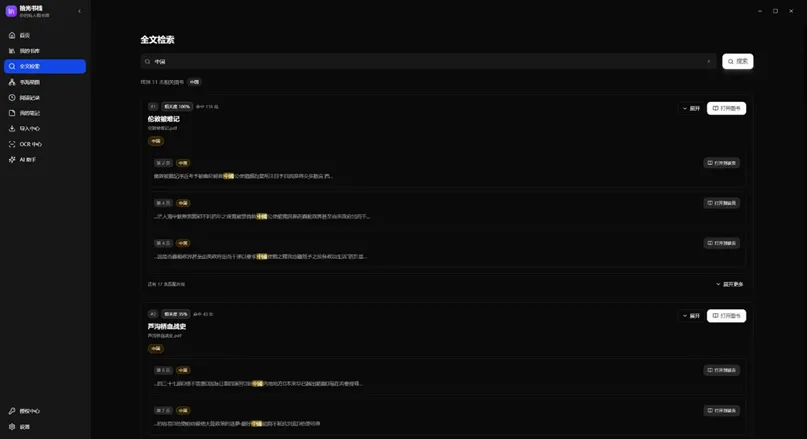
一次检索,查遍整个本地书库。资料越来越多以后,真正困难的往往不是阅读,而是“找回来”。拾光书栈的全文检索会同时查询某个书名和已解析入库的正文内容的关键词。一次最多输入三个关键词,可使用空格、中文逗号或英文逗号分隔。系统还通过OpenCC处理简繁转换,例如用户输入简体关键词,也能匹配繁体文献中的对应内容。
检索结果以书为单位展示:
- 书名命中具有更高权重;
- 显示每本文献的关键词命中数量;
- 提取关键词前后文作为结果片段;
- 不同关键词使用不同颜色高亮;
- 单本文献结果可以展开或收起;
- 点击结果即可打开对应文献,并自动带入关键词继续搜索和高亮。
从详情页返回后,原有查询条件、结果和展开状态仍会保留,不必重新搜索。
文献详情页采用沉浸式双页阅读布局,尽量保留纸质书的阅读感受。PDF原页直接作为书页显示,支持双页翻页、整体缩放、页码跳转、目录导航和缩略图跳转。
阅读窗口可以独立打开。每打开一本书,就拥有一个单独窗口,窗口名称即为书名,方便同时查阅和对照多本文献。
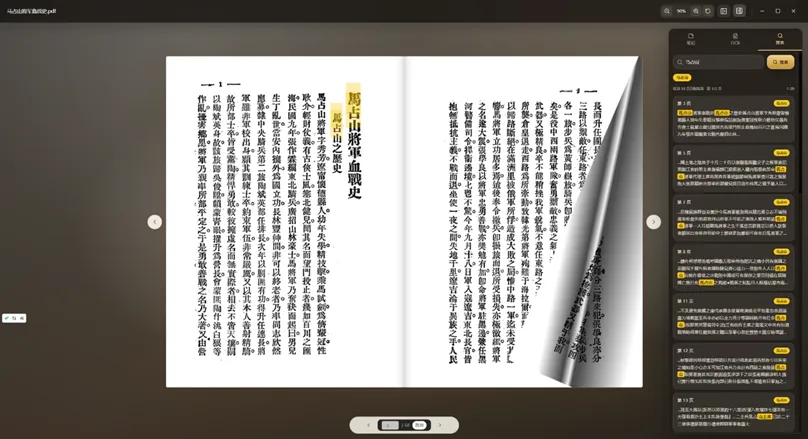
对于带文字层的PDF,搜索结果还会直接标记在原书页面的对应位置。高亮颜色清晰但不过度遮挡原文,既方便定位,也保留正常阅读体验。
5、笔记始终和原文页面保持联系
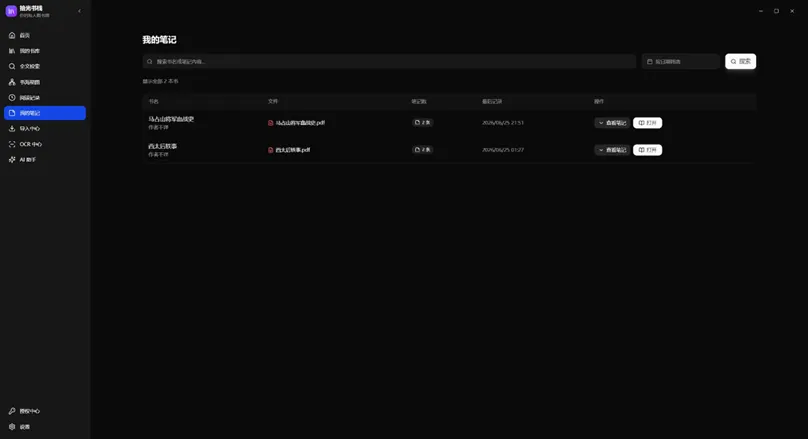
拾光书栈中的笔记不是孤立的文本。添加笔记时,系统会记录它属于哪一本书、哪一页。以后在“我的笔记”中打开某条笔记,可以直接回到对应文献和指定页面,并继续修改内容。
笔记列表以书为单位组织,支持按照书名、笔记内容和日期查询,匹配文字会高亮显示。无论从书库、全文检索、阅读记录还是笔记页面进入详情,关闭阅读窗口后,原功能页的状态都不会被打乱。
6、阅读记录,让每一次翻阅都有迹可循
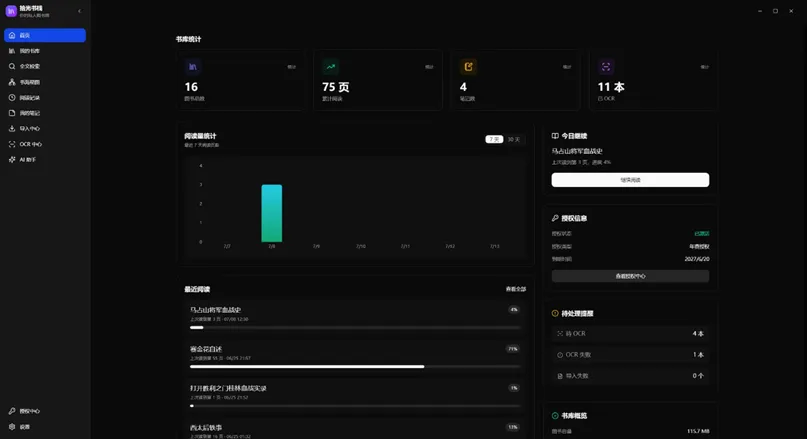
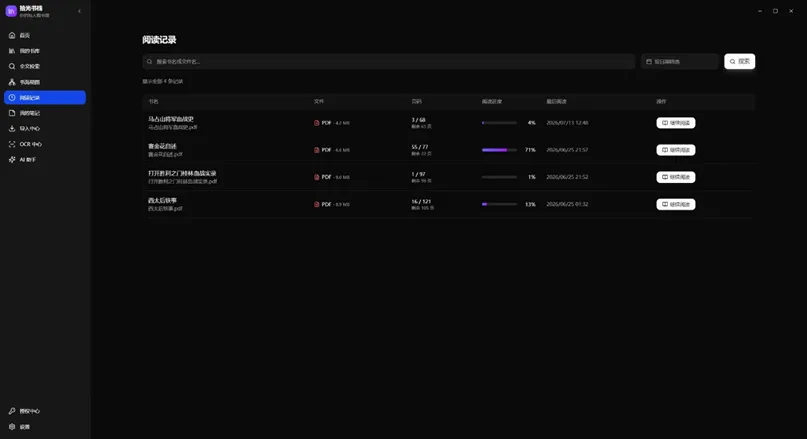
系统会记录最近阅读的文献、最后阅读页码和阅读进度。首页提供阅读总量、图书数量、笔记数量等统计信息,并用7天或30天阅读量图表呈现近期阅读情况。
再次打开一本书时,可以接着上次的位置继续阅读;阅读记录页面也能帮助用户快速找回最近查阅过的资料。
7、书海星图,看见文献之间的联系
收藏文献的价值,不仅在于单独阅读每一本书,也在于发现它们之间隐藏的联系。
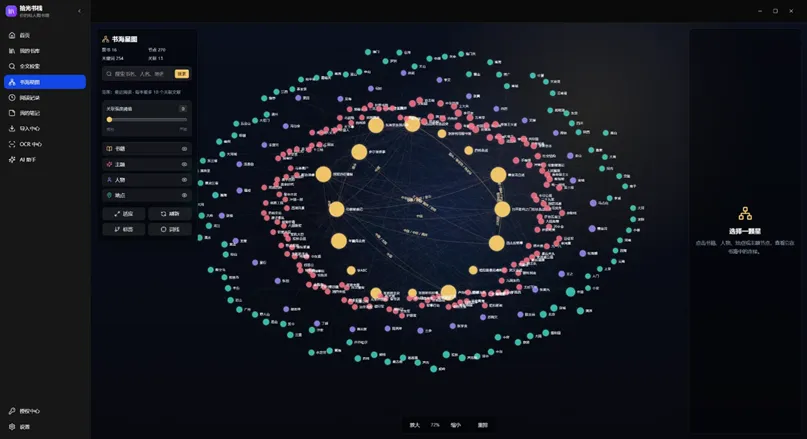
拾光书栈会从已解析文本中匹配人物、地点和主题关键词,并据此生成文献关联网络。在“书海星图”中,每本文献都是一个节点,共同关键词形成文献之间的连线,连线上会展示产生关联的关键词。
用户可以搜索某本文献,观察它与其他文献的关系;也可以通过边权阈值调节图谱密度,减少弱关联,让重要联系更加突出。为了兼顾性能与可读性,默认展示最近阅读的文献,并限制单次关联结果数量,避免书库扩大后图谱变得拥挤。
它不是为了替代阅读,而是为下一次阅读提供线索。
8、导出功能
识别结果还可以继续带走:拾光书栈支持导出OCR文本,也可以将扫描原页与识别文字位置合成为可搜索的双层PDF。
双层PDF保留原书页面外观,同时增加透明文字层。用户仍然看到原始文献,但可以在其他支持文字层的PDF工具中搜索和选择文字。合成过程提供进度提示,避免大文件处理时用户不知道程序是否仍在工作。
9、《拾光书栈》数据保存
拾光书栈采用本地资料库设计。首次使用时,用户需要选择一个长期稳定、空间充足的存储目录。数据库、原始文献、OCR结果、封面、缓存和导出文件都围绕这个目录统一管理,便于后续备份与迁移。
文献内容不依赖远程服务器保存,日常整理、阅读、OCR和检索都在本地完成。用户可以根据自己的资料规模选择容量足够的磁盘,并通过完整复制资料库目录的方式进行迁移。
遇到异常时,也不再需要在复杂目录中寻找日志。用户可以在设置页或异常提示框中点击“导出故障日志”,系统会在桌面生成一个压缩包,并自动隐藏书名、原文、笔记、机器码和本地路径等敏感信息,方便发送给技术人员定位问题。
三、用户如何体验《拾光书栈》
谁适合使用拾光书栈?如果你有以下需求,拾光书栈会成为一个实用的本地工作台:
- 收藏了大量扫描版PDF,希望统一整理;
- 经常阅读民国图书、地方志、史料或繁体竖排文献;
- 需要跨越多本文献查找人物、地点和主题;
- 希望把OCR、校对、检索和阅读放在同一个系统中;
- 重视本地数据管理,不希望文献内容散落在多个平台;
- 需要长期积累阅读记录和页码笔记;
- 想从个人藏书中发现更多文献关联。
我们相信,真正有价值的文献管理,不是把文件整齐地放进文件夹,也不是简单展示一排封面。它应该帮助人们完成一条连续的路径:
把资料收进来,把文字识别出来,把错误校对清楚,把需要的内容重新找到,再把一次次阅读连接起来。
申请试用流程
1、登录北京华语新瞻文化传播有限公司官方网站:https://www.huayuxz.com/
2、下载windows64位版安装包到本地主机任意一个盘符。(最好存放在C盘之外的盘符)
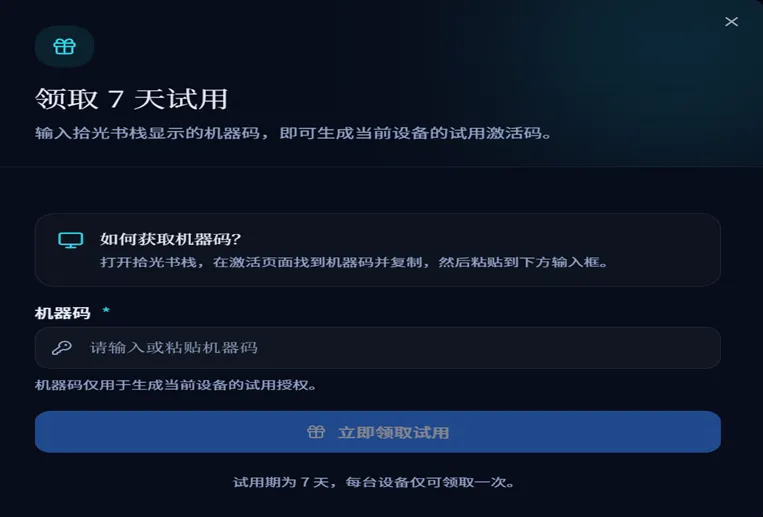
3、领取试用:复制本机的机器码到(下图)领取试用。
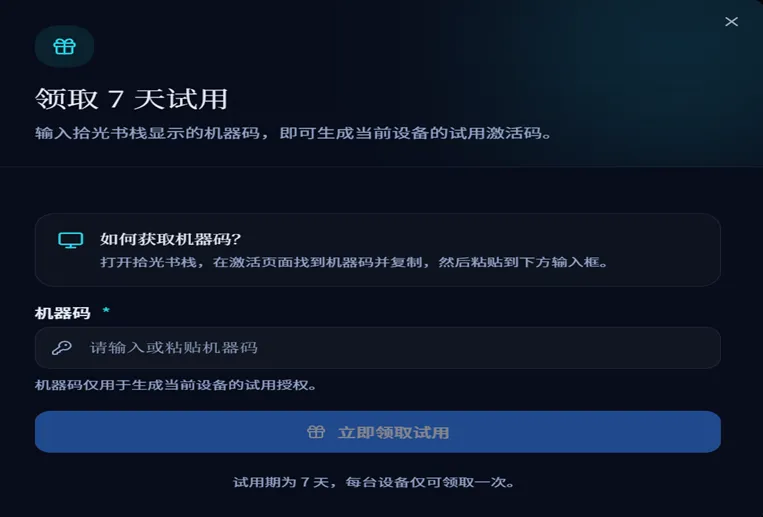
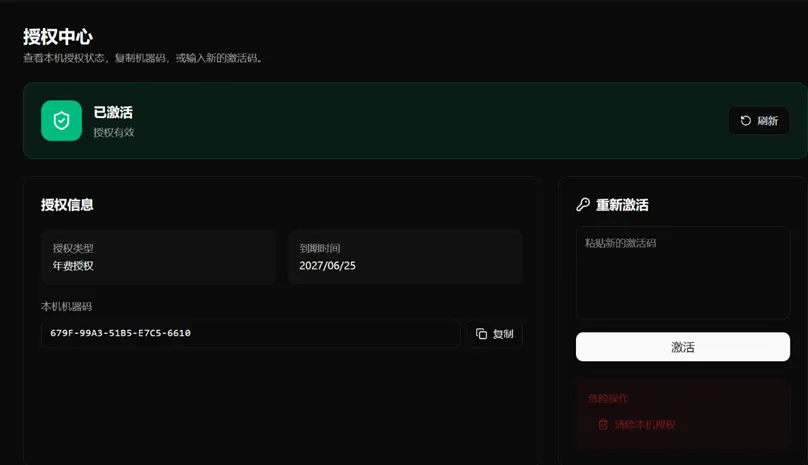
4、用户领取试用后,邮箱会收到本机激活码,然后把激活码复制到《拾光书栈》授权中心激活即可。
四、《拾光书栈》收费标准
费用项目 | 费用标准 | 备注 |
一次安装,永久使用 | 800元 | 可开发票 |
在线访问:1年服务费 | 300元 | 可开发票 |
在2026年8月28日至9月28日活动期间,凡通过史学前沿观察公众号购买的用户均可享受八折优惠!即联系以下负责人时报出来自本公众号,即可享受折扣优惠!
具体事宜请与市场推广负责人联系:
王士洲:18710207377(微信同号)18911594495
Email:mgbookscn@163.com