ARTICLE · 981816
“255文档、1592片段,公文助手的高效知识库革新搜索体验”
从零搭建一个完全本地化的政务公文知识库:架构选型、运行实测、优化策略与纠错实操,全部基于真实部署数据。
" alt="封面">在基层公文写作中,通用大模型有两个绕不开的短板:一是政策时效与本地资料缺失,模型答不出本县(区)流动人口、信访、综治中心的具体规定;二是幻觉风险,凭空编造条款、文号、数据,在正式公文中不可接受。
解决思路是RAG(检索增强生成):把单位的政策原文、历史公文、工作制度建成向量库,模型作答时先"查资料"再"写文稿",并标注引用来源,做到有据可查、可溯源。更重要的是,整套链路(嵌入、向量库、检索)全部跑在本机,数据不出电脑,满足政务场景的数据安全要求。
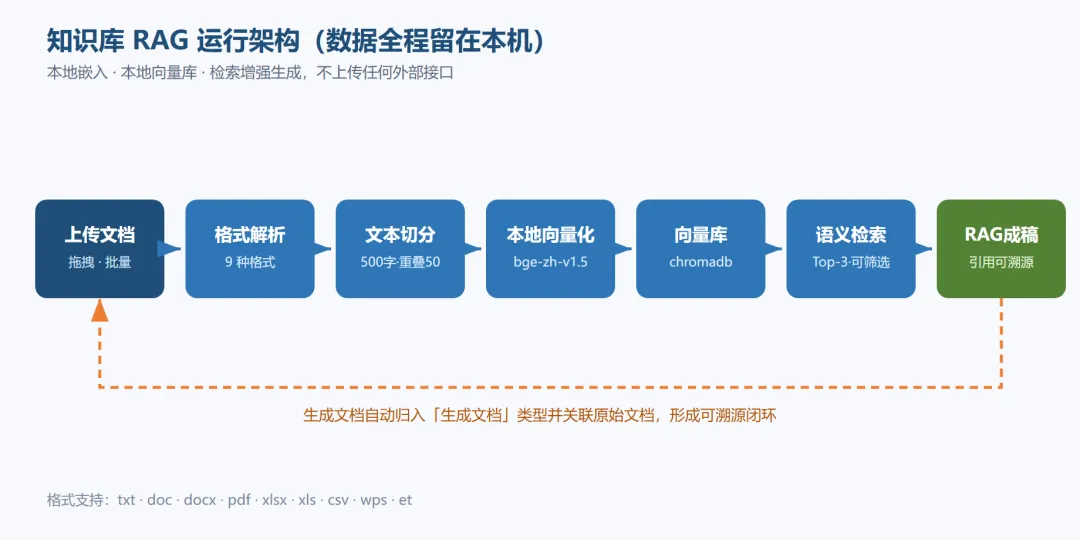
知识库采用chromadb持久化向量库 + 本地中文嵌入模型BAAI/bge-small-zh-v1.5,整体链路如下:
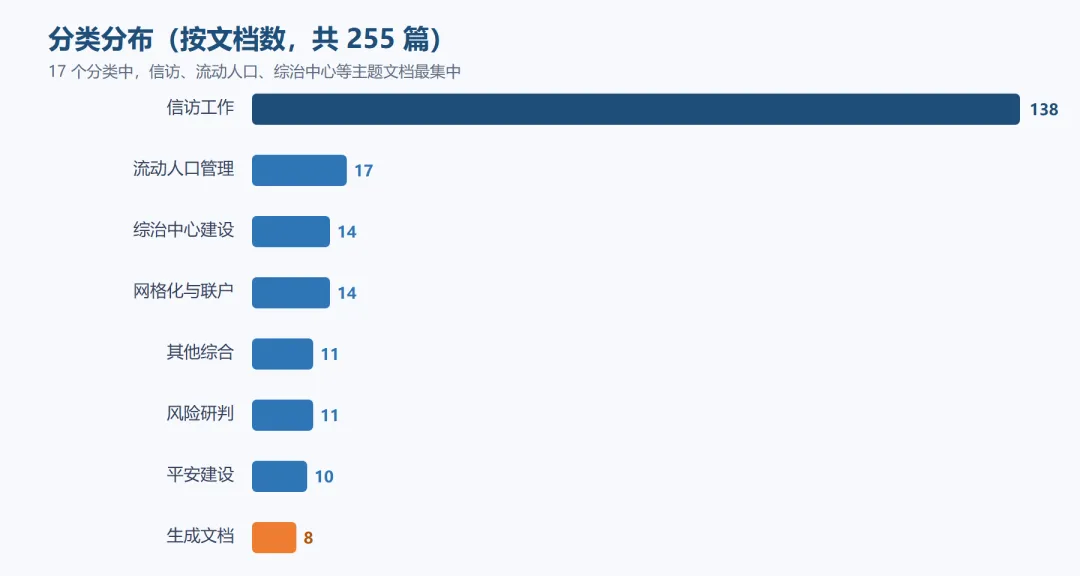
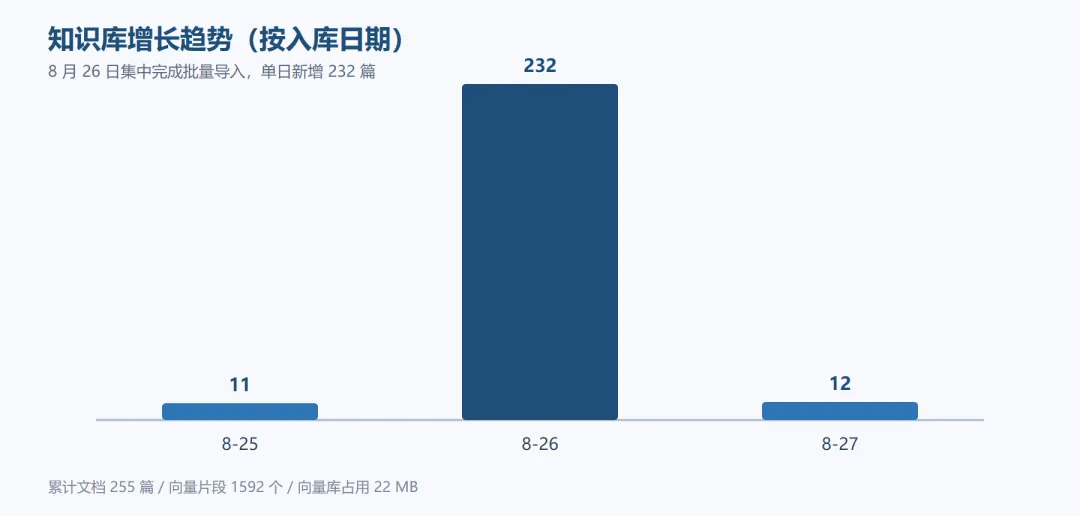
截至 2026-08-27,知识库在持续使用中的真实规模如下:
文档按业务主题分为 17 类,其中信访工作、流动人口管理、综治中心建设、网格化与联户工作等主题文档最集中。
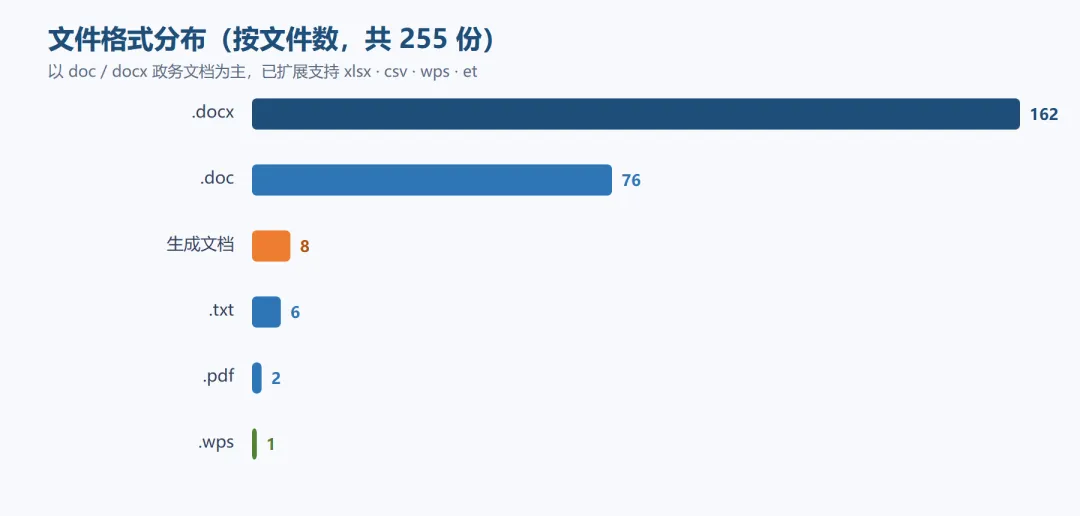
以.doc / .docx政务文档为主,已扩展到.xlsx / .csv / .wps / .et等表格与 WPS 专有格式。
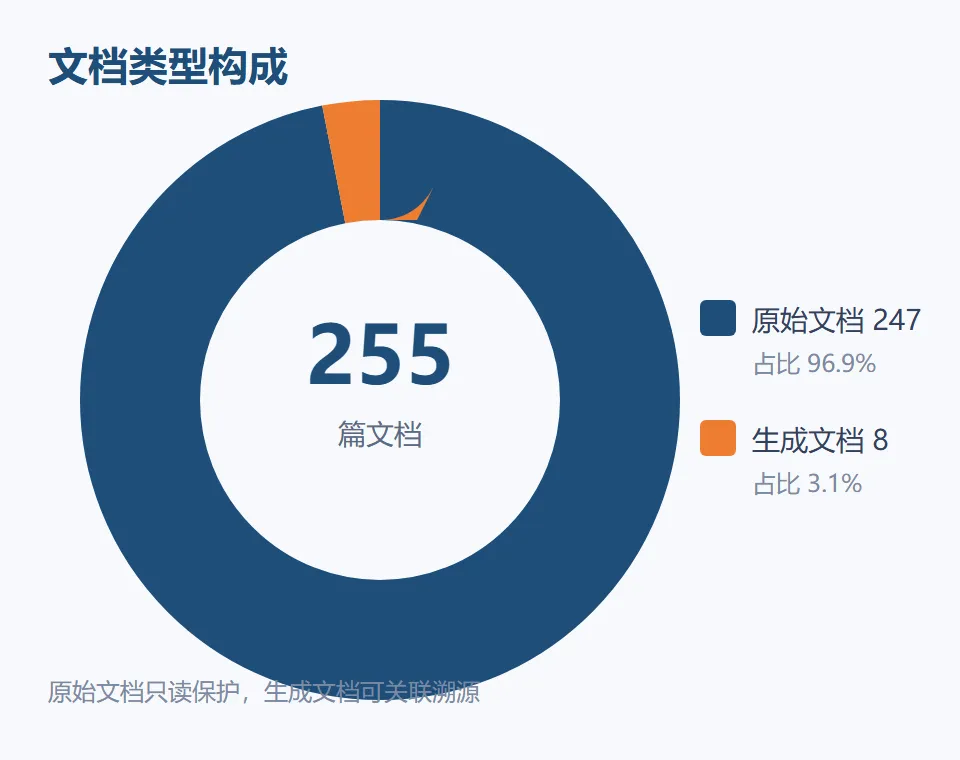
原始参考文档占绝对主体(只读保护),模型生成的正式公文作为"生成文档"持续回流,占比稳步提升。
8 月 26 日集中完成批量导入,单日新增 232 篇,知识库进入可用状态。
选用本地bge-small-zh-v1.5而非在线 embedding API,既保障数据安全,又避免网络抖动影响检索稳定性,单次检索延迟稳定在毫秒级。
公文段落较长、条款密集,采用500 字 / 重叠 50 字的切分,既保证单个片段语义完整,又通过重叠避免条款在边界被截断。
批量导入脚本会先读取索引,已存在的文件自动跳过,避免重复入库污染检索结果(如已导入的流动人口政策不会被二次写入)。
原始文档标记为original,默认禁止删除;模型生成的公文标记为generated,并记录related_ids关联其依据的原始文档,形成可溯源闭环。
在最初仅支持 txt/doc/docx/pdf 的基础上,逐步扩展至 xlsx/csv/wps/et,覆盖 WPS 政务套件(通过 KWPS / KET 组件对象模型读取),切实解决基层"文件打不开"的痛点。
当确实需要移除错误文档时,提供专用脚本,采用白名单 + 双重校验(先核对 doc_id,再核对文件名完全一致),在"防误删"与"可纠错"之间取得平衡。
把整理好的政策原文放入knowledge_base/raw_docs,运行import_policy_docs.py即可自动去重入库,归入"政策法规"分类:
实测一次导入 6 份新疆流动人口 / 政法工作政策,全部成功索引,累计知识库达 255 文档 / 1592 片段。
早期曾因指令歧义,误将 3 份"稳就业"文件(DOC000253–255)当作"政法工作"导入。纠正采用专用删除脚本,白名单 + 双重校验确保只删目标文件:
以下为直接对知识库发起的三个政策查询,检索耗时与命中结果均来自实测:
适用场景:有数据安全要求、需引用本地政策与历史公文、且希望离线可用的基层单位。
核心经验:
嵌入模型务必本地化,确保数据不出本机; 切分粒度按文档特点调(公文 500 字 / 重叠 50 字较稳); 入库前做文件名去重,避免重复污染检索; 原始文档只读保护 + 生成文档关联,兼顾安全与溯源; 纠错要留"精准删除"通道,白名单 + 双重校验防误伤。
待优化方向:嵌入结果缓存以加速冷启动;引入检索重排(Rerank)提升 TOP_K 命中精度;支持增量更新避免整库重建;接入 OCR 处理图文混排材料。
本文所有数据、参数与检索结果均来自真实部署环境实测。