ARTICLE · 983902
AI增强A/B测试实践:从验证工具到创新加速引擎
在AI时代,A/B测试正在被重新定义。本文深度解读ABot智能体如何重塑企业实验设计与科学决策。
一、前言
本文将大模型技术引入AB实验全流程,推动AB测试从传统验证工具向AI驱动的创新加速引擎进化。
二、A/B测试的本质
A/B测试作为互联网行业最重要的科学决策方法,其核心价值在于将企业决策从经验和直觉中解放出来。通过严谨的实验设计,构建"假设-验证-优化"的闭环机制,降低决策的不确定性。
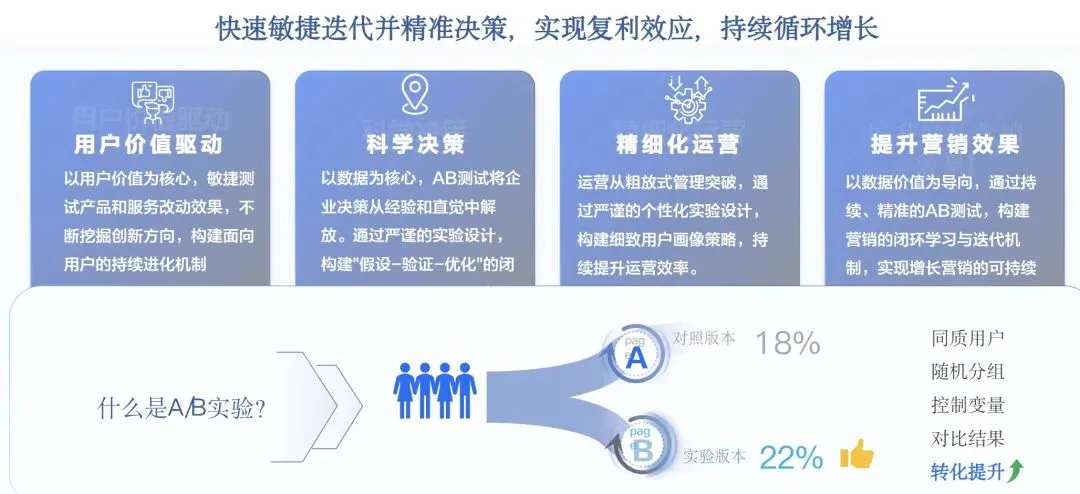
A/B测试已发展成为企业基础设施级别的系统。截至2024年12月,平台关键数据如下:
- 实验总量
:340万+ - 日增新实验
:7万+ - 同时运行实验
:4000+ - 服务业务线
:数百条
平台面向业务提供超大规模复杂场景的实验基础设施,支撑并行7万+实验,具备亿级QPS的高并发处理能力。无论是统计方法的先进性、分析引擎的灵活性,还是计算资源的规模,都确保了数据驱动决策的可靠性。
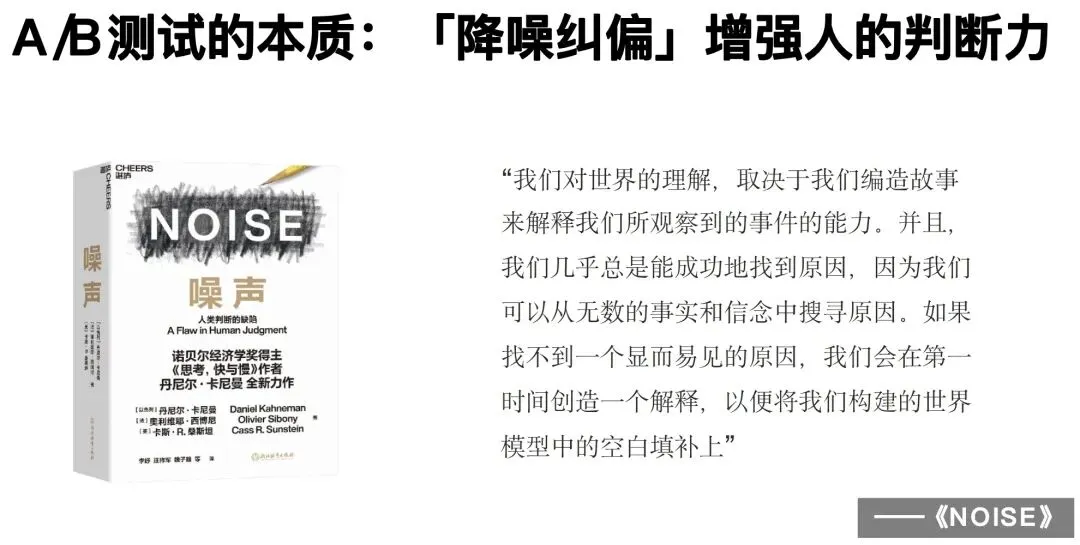
A/B测试的本质可以概括为"降噪纠偏"——增强人的判断力。正如《NOISE》一书所言:"我们对世界的理解,取决于我们编造故事来解释我们所观察到的事件的能力。"A/B测试通过随机分组、控制变量、对比结果等科学方法,滤除噪音、纠正偏差,让真正的效果信号浮现。
三、A/B平台的进化路径
3.1 传统A/B测试的"天花板"
尽管A/B测试在互联网行业已广泛使用,但传统方法存在明显的瓶颈:
- 实验设计门槛高
:需要专业的统计学知识,普通业务人员难以独立设计合理的实验方案 - 流量分配效率低
:均分流量导致资源浪费,表现差的变体仍在消耗大量流量 - 方差缩减不足
:在扩量场景下,样本量需求激增,导致实验周期拉长 - 异质性分析困难
:不同人群对同一策略的敏感度差异难以被精细化识别 - 参数调优依赖人工
:策略参数的搜索和优化严重依赖工程师经验
3.2 AI增强的实验平台架构
面对上述痛点,字节跳动提出并实践了AI增强的实验平台,从五个核心维度实现智能化升级:
流量智能调优
基于多臂老虎机(Multi-Armed Bandit)算法,平台能够自动将更多流量倾斜给表现更好的实验组。以动态文案赛马实验为例,四组文案在实验运行过程中,系统自动识别B组表现最优,逐步向其倾斜流量,而表现最差的A组被淘汰。最终点击转化率相比均分实验提升9.2%。
多臂老虎机算法的核心优势在于:零时间成本及时获取收益、零分析成本智能化决策、零误判成本最大化收益、零人工介入释放人力。应用场景包括广告投放策略自动优选、运营推送文案赛马、MVT多变量组合智能优选以及落地页动态优选等。
多元回归CUPED
通过CUPED(Controlled-experiment Using Pre-experiment Data for Experimentation Decrease in variance)方差缩减技术,在实验扩量场景下显著降低指标方差。使用多元回归方法将用户基线特征纳入模型,有效减少所需的样本量,使实验能够更快达到统计显著性。
异质敏感人群洞察
以优惠券发放场景为例,AI可以精准识别哪些人群是发放优惠券实际带来的转化(真正敏感人群),哪些人群不需要投入成本即可自然转化。通过实验的智能化分析,一键获取敏感人群包,并提供业务可解释性,帮助企业将有限的营销预算花在刀刃上。
自动参数搜索
将A/B测试的方法论迁移到参数优化场景。以Spark SQL参数优化为例,字节跳动开发了Rover系统("An Online Spark SQL Tuning Service via Generalized Transfer Learning"),通过迁移学习实现参数的自动搜索与优化,效果比专家经验优化还要好5%。
四、大模型时代的探索:ABot智能体
4.1 A/B测试实操落地的"三座大山"
在实际应用中,业务团队面临着三大核心挑战:
- 如何设计实验
:实验假设如何提炼、指标如何设定、样本量如何计算 - 如何诊断问题
:实验结果异常时如何快速定位原因 - 如何分析决策
:实验结束后如何从数据中提取洞察并做出决策 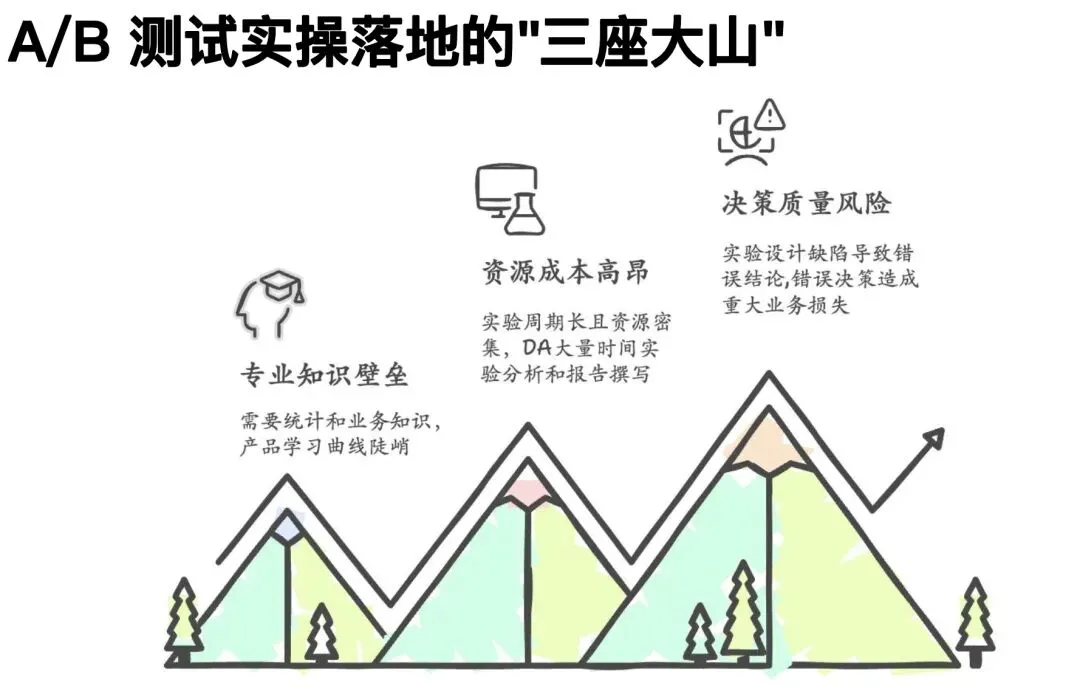
4.2 ABot:一站式实验智能体
针对上述挑战,字节跳动构建了ABot——一站式实验咨询+设计+诊断+分析智能体。ABot的服务架构涵盖以下核心能力:
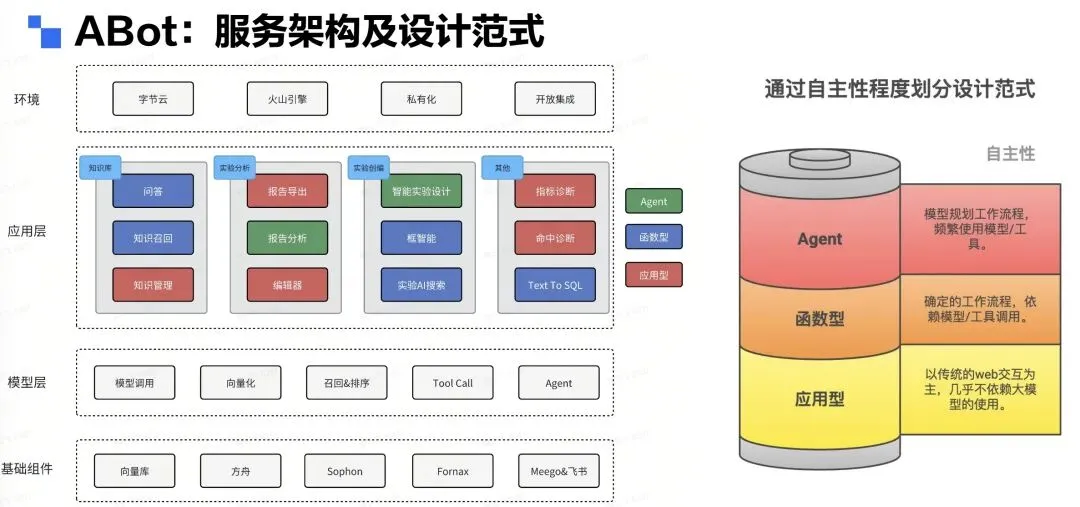
智能实验咨询与诊断
ABot内置分行业增长知识库,能够理解客户业务背景,提供实验设计的方向性建议。同时可以整合客户的文档库,结合客户自己的知识体系,为实验创建、分析、解答提供思路。
智能实验设计
ABot可以轻松发散实验设计思路,帮助实验者学习实验原理。通过对话式交互,业务人员无需掌握复杂的统计学知识即可完成实验方案设计。
智能数据归因
通过大模型结合实验报告数据以及底层计算引擎,ABot可以以对话的方式汇总总结实验报告数据,给出决策判断的参考建议,并对数据维度进行总结和归因。针对指标异动,ABot能够进行归因分析和维度下钻。
智能实验报告
ABot自动生成结构化的实验报告,包括关键指标对比、统计显著性分析、业务建议等,大幅缩短实验分析到决策的时间。
五、大模型下半场:评估驱动的产品创新循环
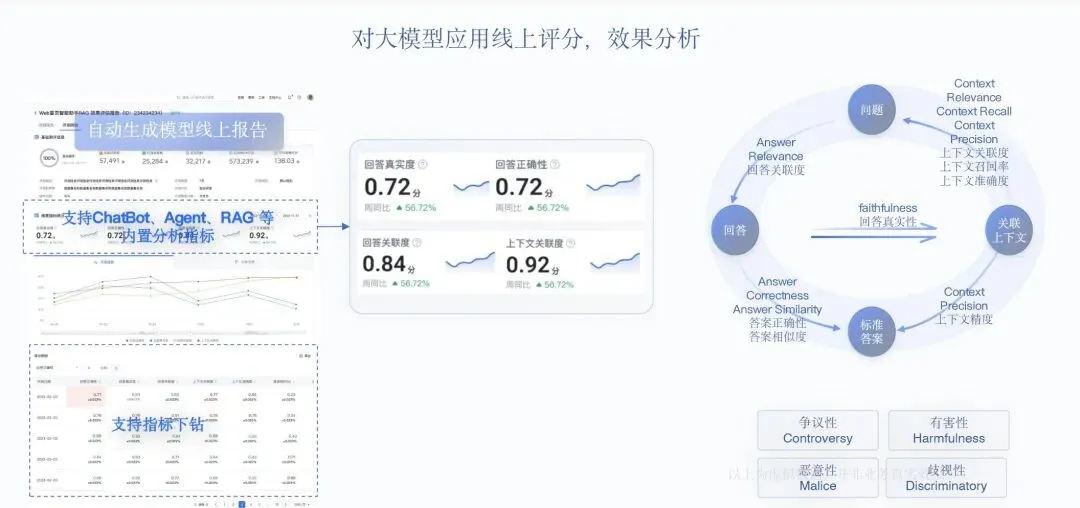
大模型应用的下半场竞争将围绕评估体系展开。构建了支持ChatBot、Agent、RAG等应用场景的大模型评估框架,核心指标体系包括:
回答质量维度
- Faithfulness(回答真实性)
:回答内容是否忠实于输入上下文 - Answer Relevance(回答关联度)
:回答是否与用户问题相关 - Answer Correctness(答案正确性)
:回答的准确程度 - Answer Similarity(答案相似度)
:与参考答案的匹配程度
上下文质量维度
- Context Precision(上下文精度)
:召回的上下文片段的相关性 - Context Relevance(上下文关联度)
:上下文与问题的匹配程度 - Context Recall(上下文召回率)
:相关上下文是否被完整召回
安全性维度
- Controversy(争议性)
- Harmfulness(有害性)
- Malice(恶意性)
- Discriminatory(歧视性)
这一评估体系支持指标下钻和对大模型应用的线上评分效果分析,自动生成模型线上报告,形成"评估-优化-再评估"的闭环。
六、总结与展望
AI+AB正在重塑企业的决策范式,从验证工具升级为创新加速引擎。
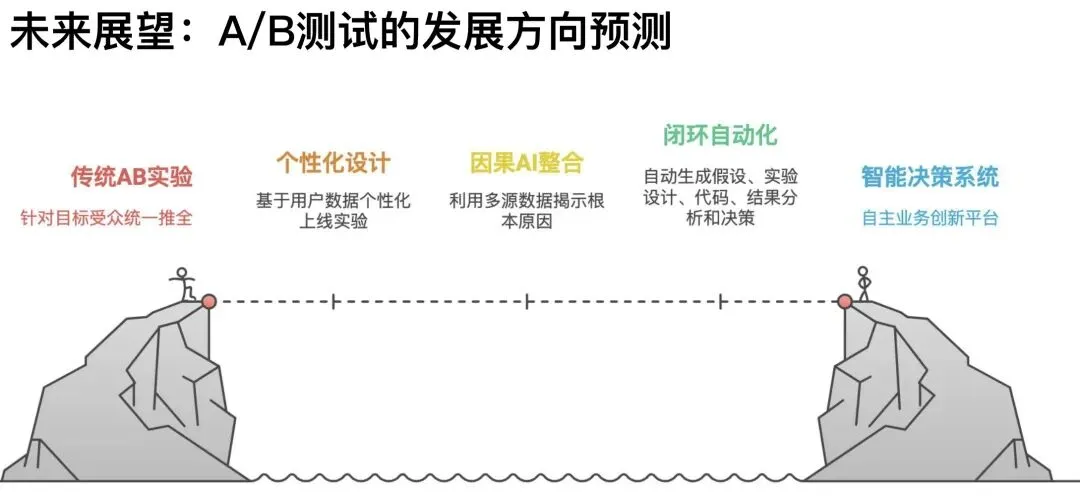
A/B测试的未来发展方向包括:
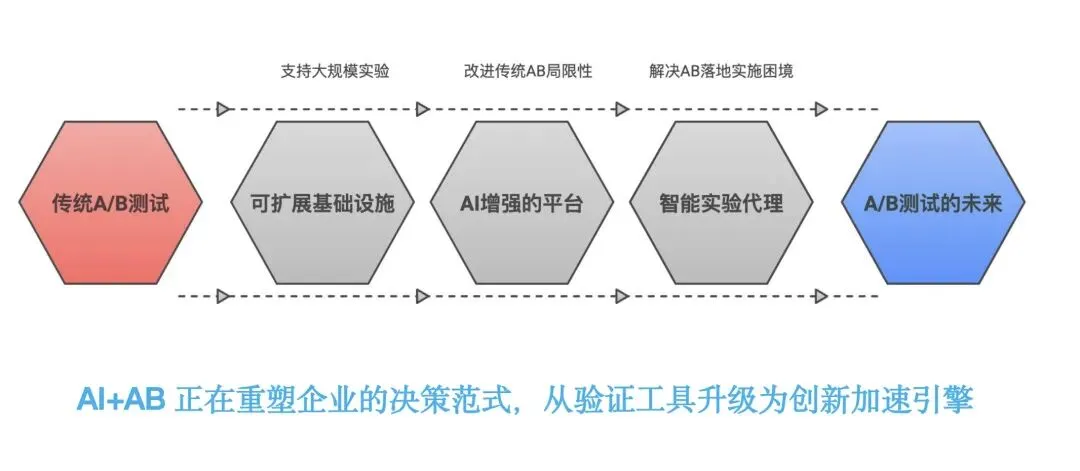
更智能化的实验设计与分析 更大规模的并行实验能力 更深度的AI与大模型评估集成 从互联网向更广泛行业的渗透
AI赋能A/B测试不是简单的工具升级,而是整个实验方法论的范式转移。当大模型的推理能力遇上严谨的统计思维,企业将拥有比以往任何时候都更强大的科学决策武器。