ARTICLE · 986200
AI时代,太用力的人,其实跑不远
我的收藏夹里躺着几千篇文章,真正读完的不到30篇。
我一度为此自豪,仿佛收藏就是拥有。
深夜刷到一篇好文章,收藏的瞬间如释重负,好像这知识已经是我的了。
一周后再没打开它,愧疚一闪而过,然后我接着收藏下一篇。
你是不是也这样?
知识工作者的手机里,置顶的工作群就有十几个,消息每几分钟弹一次。
克莱·舍基(Clay Shirky)一针见血:很多人不是信息过载,而是筛选失效。
为什么信息唾手可得,生产力反而没提升,人还更焦虑?
因为囤积不只是在缓解焦虑,更在维护“我是好学的人”的自我认同,喂养“未来的我会用到”的想象。
AI 时代获取信息空前容易,但把信息变成生产力,缺的不是“更多”,而是主动“做减法”。
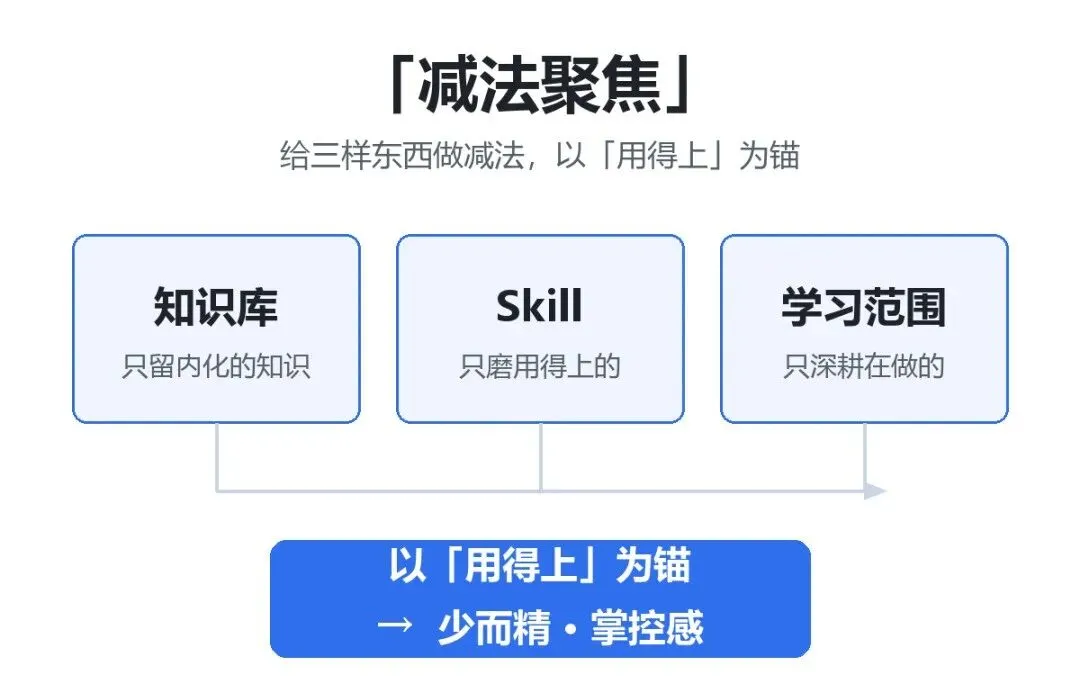
我把这个原则称为「减法聚焦」,落到日常,就是给三样东西做减法。
01
给知识库做减法,只留经过内化的知识
我的知识库,曾是台碎纸机,吞进去的知识很多,真正消化过的没几条。
收藏不等于拥有,记录不等于内化。
判断一条知识留不留,标准不是它新不新、热不热,而是能不能用在工作上。
王世民老师把这种不以应用为导向的学习,称为「能力草丛」,看似学了很多,实则无法整合。
下载 30 个 PPT 模板,不如花一下午吃透「结论先行、理由在后」这一套汇报逻辑。
模板会过时,逻辑不会。
给知识库做减法,用「知识理解三问」检验:
1、这条知识的来龙去脉是什么?
2、它和已有知识有什么关联?
3、什么场景能用、什么场景不能用?答不上来,就删。
知识的价值不在于占有,而在于应用。
02
给 Skill 做减法,只打磨用得上的 Skill
Skill 也一样。每多一个工具,就多一笔隐性的认知成本:记它怎么用、什么场景打开、跟其他工具怎么配合。
我把这叫作「信用卡方法」。
每多装一个工具,就像多办一张信用卡,看似多了能力,实则是多了负债。
卡尔·纽波特(Cal Newport)的研究显示,每次被打断去回一条消息,再回到手头任务,认知成本要持续 5 到 15 分钟。
注意力预算是有限的,每新增一个工具,对你核心领域的帮助都趋近于零,却仍在消耗预算。
给 Skill 做减法,按「与工作流的相关度」分层:核心圈每天必用,支持圈补功能缺口,外围圈即用即走。
核心圈的反复打磨,外围圈的果断停用。
现在,我的 Skill 里只留5个真正每天在用的工具,其余都卸载了。
卸载后的第一周,我总怕错过什么;第二周就发现,省下的不只是桌面和内存,还有每次要不要打开它的犹豫,和被打断后重新聚焦的几分钟。
03
给学习范围做减法,先把现有工作流打磨好
最隐蔽的,是学习范围。与其横向铺开,不如纵向深耕。
先把手头正在做的工作流打磨好,再谈别的。
一个刚转岗的同事,用 AI 两天摸清了一个完全陌生的业务领域,顺利通过了转岗答辩。
他把过往项目资料和行业报告喂给 AI,先问这个领域行家都认同的核心方法,再问大家争论最凶的地方,最后让 AI 出题检验自己是不是真懂。
他没有把 AI 当搜索引擎,而是当严格的导师。
这也印证了「少而精」的底层逻辑。
建构型学习,吃透一套做事方法,能应对 100 种项目情况;记忆型学习,死记 100 个项目模板,换个场景就失效。
圈定边界,用「最小知识集 + 边界性掌握」:最核心的概念吃透,之外的知道存在、能解决什么问题就够了。
AI 时代的机会不是看得多,而是做得精。
04
小结
三个减法,归于同一个标准:用得上、能内化、能精进。
给知识库做减法,只留用得上的;给 Skill 做减法,只磨得动的;给学习范围做减法,只深耕正在做的。
以「用得上」为锚,砍掉一切不服务积累的部分,这就是「减法聚焦」。
实操上,可以从一份减法检查清单开始:
◆删一条没读过第二遍的收藏
◆ 停用一个不常用、维护成本还高的工具
◆ 本月只深耕一个已有工作流,不再开新坑
做减法的终点不是「没有」,而是「少而精」带来的掌控感。