ARTICLE · 986718
看完这个GitHub项目,我卸载了用了三年的画图软件
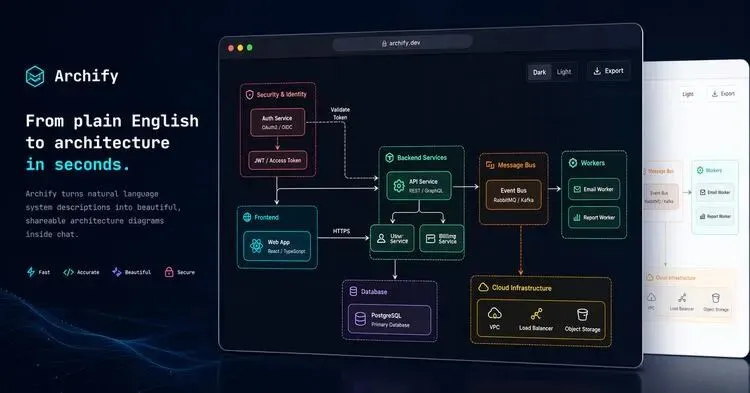
让 AI 画架构图,最大的问题从来不是画得好不好看,而是它随手编造节点和连线——你根本没法验证那张图是不是真的。Archify(GitHub 33060 stars)用「类型化 JSON 中间表示 + 确定性编译」把这件事管死了:Agent 只负责产出结构化数据,渲染和验证交给确定性引擎,同一份输入永远得到同一份输出。
这个项目在 GitHub 上以 33k star 的速度蹿红,核心原因只有一句话:它把架构图从“模型的即兴创作”变成了“可校验、可对比、可进 CI 的工程工件”。下面我们完整拆解它。
一、它解决什么真实痛点
先讲清楚为什么开发者需要这个东西。
用过 LLM 画图的人都知道两个顽疾:
第一,拓扑不可验证。 你让 GPT 画一张微服务架构图,它画得像模像样——Redis 连着 API Gateway,消息队列挂在订单服务旁边。但问题是:这些连线是它“觉得应该这样”编出来的,还是从你的代码库里真实读出来的?你分不清,它也不保证。图越漂亮,你越容易被误导。这就好比同事给你一份排版精美的设计文档,但里面一半的数据是他凭印象写的——形式上的专业掩盖了内容上的不可靠。
第二,结果不可复现。 同一个 prompt 跑两遍,得到两张布局不同、连线不同的图。你改了一个组件想让它更新图,它整张重画,之前调好的布局全没了。
这两个问题的根源是同一个:让模型直接控制了渲染层。LLM 输出 SVG 或 HTML,本质上是在做自由文本生成——自由文本生成本来就是概率性的,不可能复现,更不可能验证。
Archify 的解法是把“生成”和“渲染”彻底切开。这就像编译器的分工:你写 TypeScript,编译成 JavaScript 的过程是确定性的——同样的源码,编译一万次结果都一样,而且编译器会在编译时报错。Archify 做的就是给架构图造一个“编译器”,而 Agent 的角色被限制为只写“源码”。
一句话总结痛点与解法的对应关系:
图是编的?→ 拓扑必须来自显式声明的结构化数据,且经过确定性校验 每次不一样?→ 渲染引擎与模型解耦,同一份输入产出同一份输出
二、核心设计思路:Agent 产 IR,引擎管渲染
Archify 的本质是一个 Node.js 渲染与校验系统,目前支持 Cursor、Claude Code、Codex CLI、OpenCode 四类 Agent。
理解它的关键是一个概念:IR(Intermediate Representation,中间表示)。这是编译器领域的术语——比如 Java 代码先变成字节码,再由 JVM 执行,字节码就是 IR。IR 的价值在于:上游(源码)可以千变万化,但下游(执行)只认这一种规范格式,格式对了才能通过。
放到 Archify 的语境里:Agent 不直接画图,而是产出一个类型化的 JSON IR——每个节点是什么类型、每条边从哪到哪、语义角色是什么,全都有严格的 schema 约束。然后 Archify 把这份 IR 确定性编译(deterministic compile)成 HTML/SVG。“确定性”的意思是:没有随机性、没有模型二次发挥,同一份 JSON 永远编译出同一个 HTML。
这个设计还带来一个副产品:JSON IR 成了迭代锚点。你想加一个 Redis、把 auth 模块移到左边、高亮回滚路径——这些修改都只落在 IR 上做增量变更,不用整图重新生成。类比一下:你改 C 文件里的一行代码,编译器只重新编译,不会要求你重写整个程序。
另外值得注意的一点是,Archify 没有用一种泛化格式硬套所有场景,而是定义了五种图类型,每种对应明确的语义 schema:
| 类型 | 适合场景 | 提示词里该说清 |
|---|---|---|
| Architecture | 组件、服务、存储、信任边界 | 范围、核心组件、主路径 |
| Workflow | CI/CD、审批、运维手册 | 参与者、顺序、分支、异常 |
| Sequence | API 调用、缓存回退、认证链路 | 调用方、被调方、返回、时序 |
| Data Flow | 数据管道、血缘、PII | 数据源、变换、存储、边界 |
| Lifecycle | 状态机、重试、终态 | 状态、事件、重试与取消路径 |
这个区分很重要——状态机里的"transition"和架构图里的"edge"语义完全不同,用一种泛化格式套所有场景,正是很多画图工具语义验证形同虚设的原因。
三、可验证性设计:从校验到 Delta 对比
这一节是 Archify 真正的技术护城河。
确定性检查先行
IR 不是产出就直接用,而是先经过确定性检查,再产出最终产物。输出的 HTML 是自包含的单文件(不依赖外部 CDN),同时附带 PNG、SVG、WebM 视频和 1200×630 分享卡多种导出格式。注意这个顺序:校验通过才有产物,不是先生成再事后补救。
Architecture Delta:最大亮点
这是我认为整个项目最有工程价值的功能。对比两份经过校验的快照,Archify 输出 Before / Delta / After 三视图,并精确列出五类结构事实:
added—— 新增了什么 removed—— 删除了什么 changed—— 什么被修改了 moved—— 什么被移动了位置 rerouted—— 什么连线改变了路由
这就是架构图领域的 git diff。你在 PR 里附上 Delta 视图和机器可读的 receipt(回执,即机器可解析的差异清单),审查者不需要肉眼对比两张图找不同——那活儿既低效又容易漏。
特别值得称道的一点是 Archify 的克制:Delta 只报告结构差异,明确不推断影响面、风险或合并安全性。“这两个组件的连线变了”是事实,“这个改动可能导致线上事故”是判断——Archify 只给事实,判断留给人。很多工具败在过度承诺,这个边界划得很清醒。
fail-closed 的 ownership profile
Architecture 类型有一个可选的 deployment-ownership profile,采用 fail-closed(缺一即失败)设计:如果 owner、region、私有数据库作用域、命名跨越这些字段缺失,直接失败,不给你一张“看起来还行”的图。而且它从不隐式检查线上基础设施——你的 AWS 账号它是碰都不碰的。
fail-closed 的比喻:像机场安检,漏带一件规定物品就不能过,而不是“差不多就放行”。对于部署所有权这种安全敏感信息,“差不多”就是事故源头。
Proof Lab:可信不是嘴上说的
项目内置 Proof Lab,包含 11 个场景,每个都有 JSON 源、命名视图和校验 receipt,全部 checked-in(提交进仓库)可复现。你可以自己跑一遍验证。这种“我说的每件事都能复现”的姿态,在 AI 工具泛滥的今天相当罕见。
四、安装与基本使用
安装非常轻,一条命令全局装好:
npx skills add tt-a1i/archify -g
Cursor 用户如果想要非交互式安装(比如写进脚本):
npx -y skills add tt-a1i/archify --skill archify --agent cursor --global --copy --yes
不想装也可以直接试用:
npx skills use tt-a1i/archify@archify --agent codex
装完之后不需要真实仓库,直接在对话里描述系统即可:
Use Archify to draw: Browser -> API -> Redis cache -> PostgreSQL fallback.
如果你手上有真实代码库,想从源码生成有据可查的图,README 给了一条结构化提示词模板:
Analyze this repository, then use archify to create a high-level runtime architecture diagram.
Show 8–12 core components, one primary path, external dependencies, and trust boundaries.
Put supporting detail in cards instead of adding more edges.
这条提示词的设计很讲究:限制组件数量(8-12 个),防止图变成面条式纠缠;要求一条主路径,让图有叙事重心;把细节放进节点卡片而不是加边——边的数量才是图可读性的头号杀手。
后续迭代是纯对话式的:
add Redismove auth to the lefthighlight the rollback path
如前所述,这些改动落在类型化源上做增量修改,不整图重画。
架构变更对比
做 PR 审查时,核心命令是:
node archify/bin/archify.mjs compare architecture base.json head.json architecture-delta.html --json
base.json 和 head.json 是两份校验过的 IR 快照(可以理解为 diff 的两个 commit),命令产出 Delta HTML 视图和 --json 格式的机器 receipt。
网络行为:透明到可以写进合规报告
这一点单独拿出来说,因为它体现了项目的隐私态度。Archify 仅 GET 一个固定的稳定版 manifest 用于更新提醒,成功检查后约 72 小时静默,失败重试间隔 6 小时 / 24 小时;服务器只能看到 HTTP 元数据(IP 和时间),收不到版本号、Agent 类型、项目数据、提示词或任何账号/设备 ID。它从不自动下载和安装更新,更新决定权在你。
想完全断网?一条环境变量:
ARCHIFY_UPDATE_CHECK_DISABLED=1
设置后禁用全部联网和提醒状态写入。
另外两个环境的安装路径:Raven 用户手动解压 archify.zip 到 ~/.raven/workspace/skills;DSH 社区用户走 dsh plugin --profile web add @tt-a1i/archify-dsh@0.1.0。
五、交互能力与导出形态
生成的 HTML 不是静态图片,而是一个完整交互 viewer:
节点搜索,大图里找组件不用肉眼扫;可选的版本校验源码跳转——点一个节点能跳到它对应的源码位置,且这个链接经过了 revision 校验,不是死链;上下游 authored reach 追踪——选中一个节点,看它声明的上游/下游影响范围;最短有向路径探测——从 A 到 B 走哪条链路,类似图算法里的 shortest path;语义角色间的真实调用对比——Semantic lens 视图,对比两个语义角色之间的实际调用关系。
注意一个措辞细节:reach 和 route 都是 authored(作者声明的)——即来自 IR 里声明的边,Archify 不声称反映运行时真实流量。这个诚实的措辞贯穿整个项目文档。
Guided Story 模式支持播放有限个命名章节,一个章节讲清一条链路,但不会发明拓扑——讲故事的素材必须来自已校验的 IR。
外观层面:一键切换 Dark/Light 双主题,四种预设风格(Signal Flow、Blueprint、Classic 等),内置品牌标识。导出完全面向分享场景:Copy Share Card 直接产出 1200×630 的标准尺寸图——这是 README、发布说明、社交贴图的通用比例,拿来即用;追踪完 route 或 reach 后,还能导出带该上下文的专属分享卡(Route Share Card / Reach Share Card),保留全图作背景。
最后,本地零依赖可体验:直接用浏览器打开 examples/web-app.html,就是完整的 viewer。
六、优缺点分析
夸完了,泼点冷水。任何工具的判断都要两面看。
优点一:可验证性是同类工具最缺的。 拓扑来自 IR 而非模型自由发挥,Delta 有机器 receipt,天然适合进 PR 流程甚至 CI。这是从“画图玩具”到“工程工具”的分水岭。
优点二:单文件自包含产物。 没有 CDN 依赖、没有外部资源,一个 HTML 文件发给别人就能打开,导出格式覆盖文档(SVG)、演示(WebM)、社交(1200×630 卡)全场景。
优点三:隐私边界清晰。 不隐式连线上基础设施,更新检查可完全关闭,遥测字段明确列出——可以拿去给安全团队审。
缺点也必须讲透:
缺点一:它验证的是结构,不是语义。 这是最大的坑。整个链路是“Agent 产 IR → Archify 校验并渲染”——Archify 能保证 IR 内部一致、渲染正确,但Agent 对代码库理解错了呢?比如你的代码里服务 A 根本不调用服务 B,但 Agent 分析错了,在 IR 里声明了这条边。这条错误的边会以一张排版精美、校验通过的“可信图”的形式呈现给你。校验章是 Archify 盖的,但数据是 Agent 填的——就像会计软件保证了账目格式合规,但发票本身可能是假票。所以可信的前提是你信任 Agent 的代码理解能力,版本校验的源码跳转正是为此提供的补救手段:点回去人工确认。
缺点二:生态绑定 Agent 工作流。 整个安装和使用路径围绕 Cursor/Claude Code/Codex/OpenCode 设计。纯 Mermaid/PlantUML 用户迁移有学习成本,五类图 schema 各有约束,不是“装上就会”。
缺点三:fail-closed 的代价。 deployment-ownership profile 的严谨设计意味着输入负担重——owner、region、私有数据库作用域、命名跨越,缺一即失败。做快速草图时,这种严格性就变成了摩擦。
七、适用场景与不适用场景
敢下判断,直接说。
该用的三个场景:
1. 架构变更的 PR 审查。 Before/Delta/After 三视图加五类精确差异清单,比肉眼 diff 两张图可靠一个数量级。如果你的团队在做微服务治理,这个功能值回所有安装成本。
2. 从代码库生成可追溯的系统地图。 配合版本校验的源码跳转,做新人 onboarding 或文档沉淀——新人看图卡住时能直接点进源码,图不是“某个过时的 wiki 页面”,而是绑定在 commit 上的活文档。
3. 需要规范分发架构图的团队。 README、发布说明、社交渠道,1200×630 分享卡是现成标准产物,不用再截图裁剪。
不该用的三个场景:
1. 需要运行时真实流量拓扑的场合。 再强调一次:reach 和 route 都是 authored 的,是作者声明的,不是从监控数据里挖出来的。你要的是 service mesh 的调用链分析,该找的是 tracing 工具,不是画图工具。
2. 一次性白板草图。 脑暴时随手画个流程给同事看,IR schema 加校验流程是纯粹的过度工程,Mermaid 三行文本搞定的事没必要上这套。
3. 非 Node 生态且不愿装 Agent CLI 的环境。 安装路径完全围绕 skills CLI 设计,没有独立的桌面版或 Web 版工作流。
八、与同类方案的定位差异
最后把 Archify 放进坐标系里。
对比 Mermaid / PlantUML: 这两者是文本 DSL 直译渲染——你写文本,它渲染,语法错了会报错,但语义无验证。你在 Mermaid 里写 A --> B,它不会问“这条边有依据吗”。Mermaid 像是 Markdown,快、轻、通用;Archify 像是带类型检查的编译器,慢半拍但产物可信。两者的差异点在类型化 IR、确定性校验和 snapshot 对比——这是 DSL 直译工具在架构层面做不到的。
对比通用 Agent 画图(直接让 LLM 输出 SVG/HTML): 通用方式不可复现、拓扑不可信,前文已详细分析。Archify 把生成约束在结构化数据层,渲染层与模型彻底解耦——模型再怎么“幻觉”,也只能幻觉出 schema 校验能拦住的东西。
对比商业画图工具(draw.io / Excalidraw): 手工绘制精确且自由,但不可从代码库自动生成、改一次重画一次、无法做 Delta。Archify 牺牲了自由布局,换取可验证与可迭代。这是典型的工程权衡:draw.io 优化“表达自由”,Archify 优化“可信复现”。
当前版本 v2.16.0,主语言 JavaScript,33060 stars,变更活跃,可跟踪 Changelog。
定位总结:Archify 不是“画得更漂亮的 Mermaid”,而是“把架构图变成可校验、可对比、可进 CI 的工件”。33k star 不是因为它赢在了美观——美观的工具市面上有的是——而是因为它第一个认真回答了 AI 时代架构图的根本问题:这张图凭什么可信?
在 AI 生成内容泛滥、可信度成为稀缺资源的当下,一个用确定性引擎约束概率性模型的设计,值得每个做 AI 工具开发的工程师研究一遍它的源码。