ARTICLE · 987380
AI交付实战系列 03|文档核对真正贵的,是数据源说不清
「AI交付实战系列」第三篇。案例做了脱敏和合成处理,不指向任何真实企业。
这个系列只讲企业 AI 项目从需求到交付,中间那些容易被忽略、但最后决定成败的事。
老板说工程师不该浪费在文档上
有一次聊到文档核对,客户老板说过一句话:
高薪工程师应该去做产品,不应该浪费在文档上。
这句话很刺耳,也很真实。
在很多强监管行业里,工程师明明应该做研发、做验证、做产品改进,最后却被大量文档工作拖住。
实验记录要写,Excel 数据要整理,注册资料要生成,质量标准、操作规程、检验记录、检验报告还要互相对得上。
单看每份文档,好像都是正常工作。
但放到一个项目里看,问题就出来了。
同一个数据,在实验记录里是一个值,到了 Excel 里可能变成另一个值,写进注册资料时又换了一种表达。质量标准里写的是一个要求,检验记录里填的是另一个口径,报告结论里又用了第三种说法。
客户说“能不能用 AI 帮我自动核对文档”,你听到这句话,千万别马上开干。
因为这件事表面是文档核对,实际是在问一个更深的问题:
公司里这些数据,到底从哪里来?
多文档核对,难的不是找错字
很多人一听文档核对,脑子里会先冒出几个技术词。
OCR、文档解析、表格识别、向量检索、大模型比对。
这些能力都重要,但它们不是第一步。
真正麻烦的是,企业里的文档本来就不是从同一个源头长出来的。
同一个项目里,可能有实验记录、原始 Excel、注册资料、质量标准、操作规程、检验记录、检验报告。
不同部门写不同文档。
不同人员维护不同版本。
不同模板里,同一个字段名字可能不一样。
有些数据来自实验,有些数据来自历史批准版本,有些数据来自某个部门临时整理的表。
单文档内部也会出错。
实验数据太多,人工复制、粘贴、改写、汇总,任何一步都可能抄错。
多文档之间更容易出错。
因为每份文档都可能是对同一件事的不同表达,写的人不同,时间不同,依据不同,模板不同。
所以多文档核对真正要查的,是几个说法背后的事实是否同一个。
这也是为什么强监管行业特别怕这类问题。
普通企业文档错了,可能只是返工。
医药、医疗器械、质量体系这类场景里,文档错了,可能意味着证据链断了、版本依据错了、复核责任说不清。
这张图把多文档核对里的几类关键材料关系放在一起:
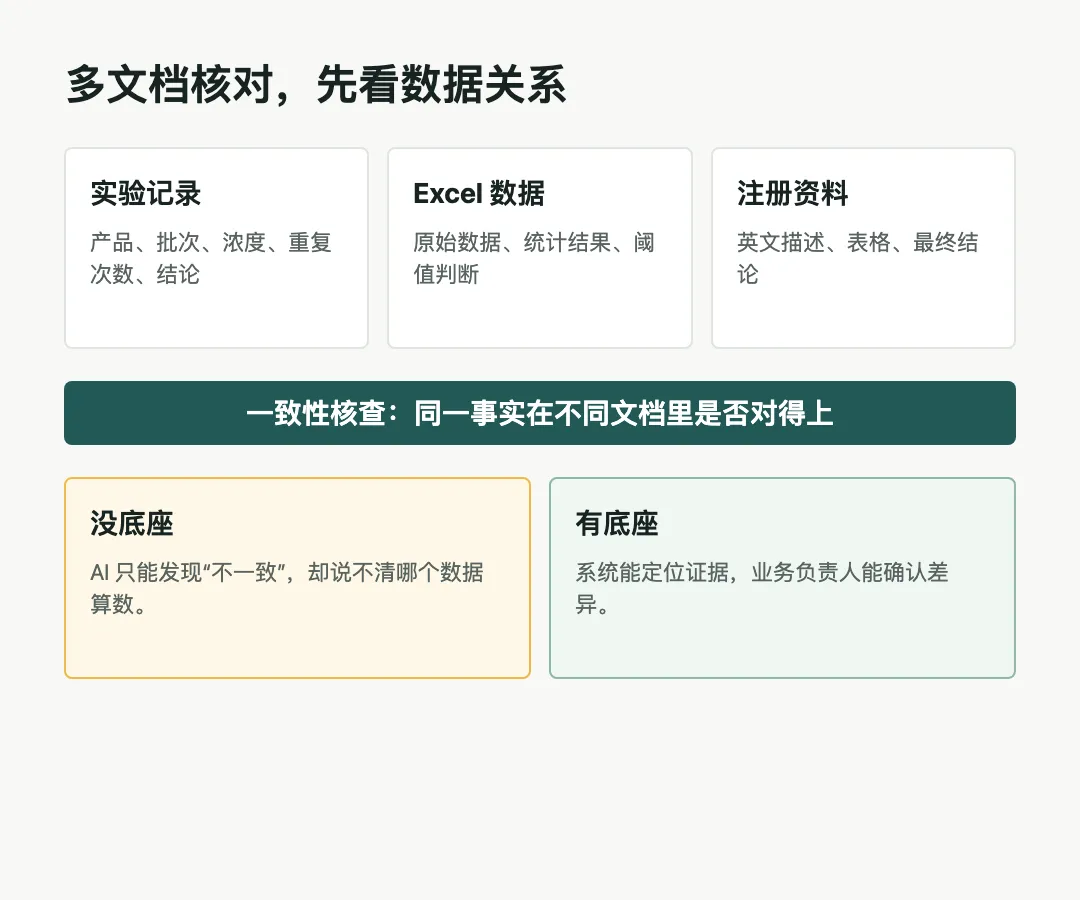
图里真正重要的,是每个数据能不能追到同一个源头。
先别急着上 AI,先把四件事问清
我现在看到“自动核对文档”这类需求,通常会先问四件事。
第一,权威数据源是谁。
同一个数据,如果实验记录、Excel、注册资料里都有,到底以哪个为准?
如果这个问题没人回答,AI 比对出来十个差异,也只能告诉你“不一致”。它没法替企业判断哪个是对的。
第二,模板有没有统一。
模板不统一,系统就要花大量精力理解每份文档的结构。
字段名不同、表格位置不同、章节顺序不同、表达习惯不同,最后都会变成解析成本、适配成本和误判成本。
很多企业以为自己缺的是 AI,其实缺的是统一模板。 第三,当前版本是哪一版。
文档核对最怕新旧版本混在一起。
共享盘里一份,部门电脑里一份,群里转过一份,供应商回传一份,后来又有人改过一份。
AI 如果不知道哪份是当前有效版本,就可能把历史口径当成现行规则。
第四,差异由谁确认。
系统发现冲突以后,谁判断是错误、例外、历史遗留,还是允许存在的差异?
谁改源数据?谁改文档?谁负责复核?谁确认可以归档?
这些问题不清楚,AI 系统越勤奋,后面的确认工作越多。
这四件事问完,很多项目会从“做一个自动核对工具”,变成“先补一套数据和文档治理规则”。
这才是正确变化。
这四问可以直接变成项目开工前的检查表:
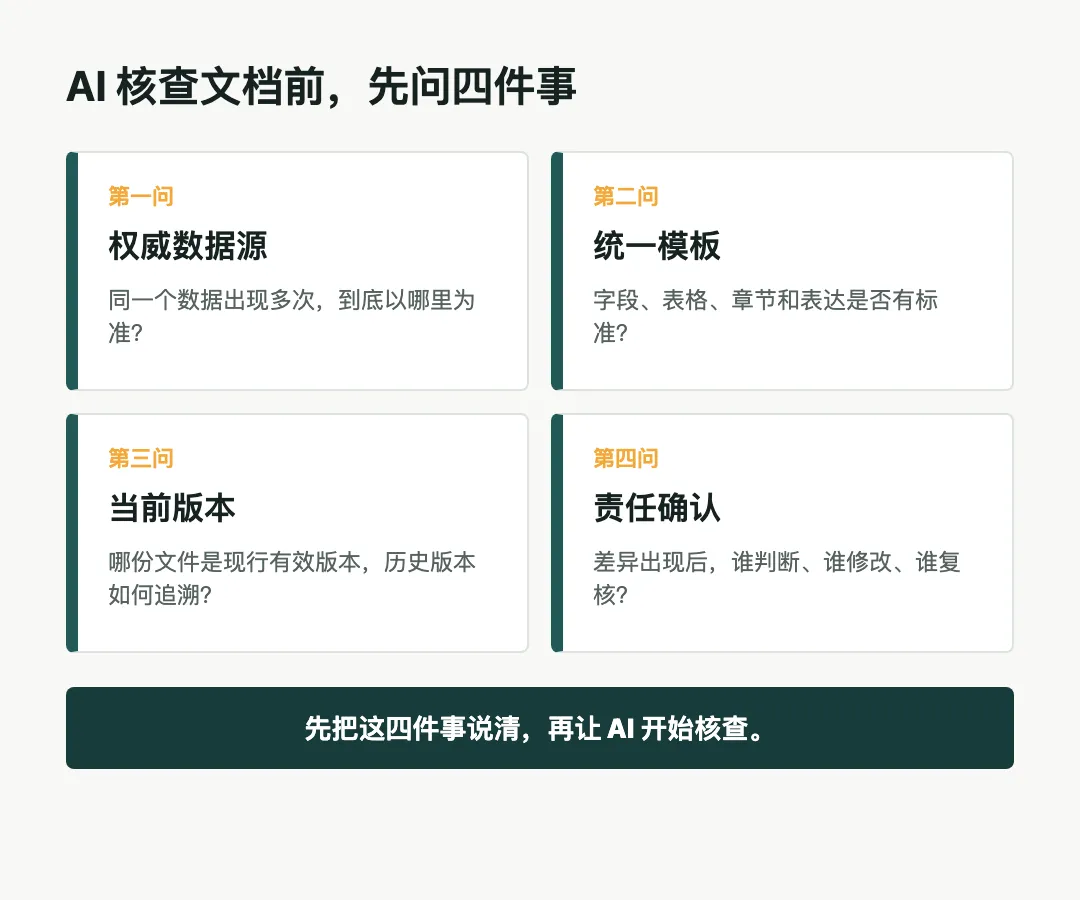
四个问题答不清,AI 就只能更快地暴露混乱。
AI 应该发现问题,但不能替企业拍板
多文档核对不是不能做。
相反,它是企业 AI 很值得做的场景。
因为人工很难稳定覆盖所有交叉关系。
一份实验记录里有产品、批次、浓度、重复次数、结论。
Excel 里有原始数据、统计结果、阈值判断。
注册资料里有英文描述、表格、最终结论。
质量标准和操作规程里又有判定依据。
让工程师一项一项去核对,既耗时间,也容易漏。
AI 在这里最适合做五件事。
第一,把多份文档里的关键字段抽出来。 第二,把同一产品、同一批次、同一实验、同一指标关联起来。 第三,发现数值、结论、时间、版本、表达之间的不一致。 第四,把每个差异定位到原文证据。 第五,输出问题清单和可能的修订建议。
但最后那一步,不能交给 AI 自己完成。
AI 可以说:这里疑似冲突。
AI 可以说:A 文档和 B 文档口径不一致。
AI 可以说:这条结论找不到对应实验数据支撑。
可它不能直接说:以我为准,公司就这么改。
在强监管行业里,系统必须把证据摆出来,把差异列出来,把风险标出来,然后让业务负责人和复核人确认。
这不是保守。
这是生产级系统必须有的边界。
老板真正要算的是这笔账
客户老板说“工程师不应该浪费在文档上”,这句话背后其实是一笔成本账。
第一笔成本,是高薪人员的时间。
工程师被文档核对拖住,少做的是产品验证、研发改进和问题分析。
第二笔成本,是反复返工。
一个数据抄错,可能带动三份文档一起改。
一个版本没对齐,可能让前面已经审核过的内容重新来一遍。
第三笔成本,是漏错风险。
人工核对最难的是疲劳。
越是重复,越容易漏。
越是接近交付节点,越容易赶。
第四笔成本,是合规信任。
如果材料之间经常对不上,企业内部会越来越依赖少数老员工记忆。
一旦人换了、版本变了、历史文件找不到,系统就很难解释当时为什么这么写。
所以老板真正该买的,不只是一个“能帮我看文档”的 AI。
更应该建设的是一套让数据、模板、版本、证据和责任能被追溯的底座。
AI 只是把这套底座用起来。
没有底座,AI 只能在混乱里找混乱。 有了底座,AI 才能把工程师从重复核对里慢慢解放出来。
真正该补的是底座
“帮我自动核对文档”这句话,听起来很具体。
但它背后往往藏着企业过去很多年的工作习惯。
数据从不同地方来,模板各部门自己改,版本靠人记,文档靠人抄,最后再让工程师一项一项核对。
AI 能帮你发现这些问题。
但 AI 发现问题以后,企业还是要回答:哪个数据是源头,哪个模板是标准,哪个版本有效,谁来确认差异。
这几个问题不回答,自动核对做得越快,暴露出来的问题越多。
这几个问题回答清楚,多文档核对就不只是一个降本增效工具。
它会变成企业补数据底座、补质量体系、补流程责任的一次机会。
我觉得这才是企业 AI 项目最有价值的地方。
它不是把脏活累活简单甩给模型。
它逼着企业把过去靠人记、靠人找、靠人兜底的东西,重新变成可以被系统理解、可以被证据追溯、可以被责任确认的工作流程。
如果这篇文章对你有帮助,欢迎点个赞、点个在看,也可以转给正在推进 AI 落地的朋友。想持续看到这类企业现场复盘,记得给我加个星标。
我是 jieson,致力于把 AI 从概念带进真实企业现场。我们下篇见。