ARTICLE · 991417
办公 AI 助手安全厂商布局拓展深度方案:从智能体特性、闭环生态到控制面破局
一、执行摘要
办公 AI 助手(WorkBuddy、TeleAgent、纳米 AI、灵犀/WPS AI、Microsoft 365 Copilot、飞书/钉钉智能伙伴等)正在从"聊天式问答工具"演进为能够调用工具、改写系统状态、长期记忆、自主规划并与人协同的智能体(Agentic AI)。这一变化把企业安全边界从传统的"用户—应用—数据"三元结构,扩展为"用户—Agent—工具—数据—企业系统"的复杂闭环。
安全厂商面临的核心矛盾是:办公 AI 助手多由平台厂商以 SaaS 或闭源客户端形态交付,模型内部(Prompt、推理链、工具调用中间态、记忆)对第三方安全厂商基本不可见;但 Agent 真正产生业务风险的环节,恰恰是它对外部工具的调用与数据写回。 因此,安全厂商的破局点不是去"看懂模型",而是在 Agent 与工具/数据之间建立模型无关、助手无关的统一控制面(统一安全网关),把"工具调用层"作为唯一可控切面,实现解析、策略、审计、DLP、身份与红队验证的完整闭环。
本报告基于 OWASP Agentic AI Top 10(2025.12,100+ 专家)、OWASP MCP Top 10(2025)以及 2026 年已公开的 MCP 漏洞数据(Palo Alto Unit 42 实测 5 个 MCP 服务器下单一被控节点攻击成功率达 78.3%;2026 年 1–2 月超 30 个 MCP CVE,其中 43% 为 shell 注入),深入剖析办公 AI 助手的智能体特性、闭环生态、风险机理、安全能力引入困境与破局路径,并提出安全厂商可落地的 A–F 六域能力框架、六类对接模式与短中长期演进路线。
核心结论:
1.办公 AI 助手不是聊天机器人,而是智能体。 其价值来自"自主调用工具改变世界状态",风险也源于此。
2.闭环生态的信任边界被重写。 用户指令 → Agent 规划 → 工具调用 → 工具执行 → 写回业务系统 → 用户确认 → 再触发,任一环节都可能被攻击。
3.安全能力引入存在五大困境: 切面缺失、接口竞争、黑盒不可审计、延迟/误报双约束、责任归属不清。
4.破局支点在"工具调用层"。 无论模型是否开放,Agent 都必须经过工具调用层才能影响真实世界;在此插入 统一安全网关 控制面,可实现与模型解耦的统一治理。
5.D 域(智能体与工具治理 ATG)是控制面核心。 MCP 管控、Skills 生命周期、工具投毒检测、能力边界四项子能力,覆盖 OWASP MCP Top 10 中 7 项以上高风险。
二、重新认识办公 AI 助手:它不是聊天机器人,而是智能体
2.1 从"问答"到"行动":智能体特性的根本性变化
传统聊天机器人(Chatbot)的风险模型相对简单:输入过滤 + 输出过滤即可解决大部分问题。但办公 AI 助手已经进入Agentic AI阶段,其特性决定了风险模型完全不同。
特性 | 传统聊天机器人 | 办公AI助手( Agent ) |
交互模式 | 单轮 / 多轮问答 | 多轮协商+自主执行 |
任务能力 | 信息生成 | 任务分解、规划、调用工具、写回系统 |
记忆 | 短期会话 | 长期记忆+ RAG +个人 / 企业知识库 |
工具 | 无或固定 | 动态发现、运行时调用( MCP/Function Call ) |
权限 | 只读 | 读写执行混合,可代发邮件、改日程、删文件 |
人机关系 | 人主导 | Agent推荐→人确认;部分场景自动执行 |
可解释性 | 较高 | 黑盒推理链,决策过程难以审计 |
这种变化意味着:一次简单的用户指令(如"帮我整理本周客户拜访记录并群发邮件")可能触发 Agent 调用 CRM、邮件、日历、文档、通讯录等多个工具,涉及读取、聚合、判断、写回多个动作。 如果 Agent 被提示注入或工具投毒,它可能在用户无感知的情况下把敏感客户信息发到外部邮箱,或把恶意链接群发给全公司。
2.2 办公 AI 助手的六大智能体特性
2.2.1 自主规划与任务分解
Agent 接收用户目标后,会自主拆解为多个子任务并排序。例如:"帮我准备明天的董事会材料"可能被拆解为:- 检索日历确定参会人- 从邮件/文档提取议题- 生成 PPT 初稿- 调用邮件发送给秘书确认
风险点: 规划过程对用户不可见,攻击者可通过注入隐藏目标(Goal Hijacking)让 Agent 把"发邮件给秘书"改成"发邮件给攻击者控制的邮箱"。
2.2.2 工具调用(Tool Calling / Function Calling / MCP)
办公 AI 助手通过调用外部工具实现业务能力。MCP(Model Context Protocol)正在成为工具调用的标准化协议,使 Agent 能够动态发现并使用来自不同供应商的工具。
风险点: 工具描述、参数模式、返回值都可能被污染(Tool Poisoning);Agent 可能调用未授权工具或把敏感数据作为参数传给外部 API。
2.2.3 记忆与上下文
Agent 需要维护会话上下文、用户偏好、企业知识库(RAG)以及跨会话的长期记忆,以提供个性化服务。
风险点: 上下文可能被跨用户/跨会话泄露(MCP10 Context Injection & Over-Sharing);RAG 知识库被投毒后,Agent 会基于错误知识做决策(Memory Poisoning)。
2.2.4 多模态输入输出
办公 AI 助手不仅处理文本,还处理文档、图片、语音、表格。攻击者可以把恶意指令嵌入 PDF、图片、Excel 公式、语音转写结果中。
风险点: 间接提示注入(Indirect Prompt Injection)通过文档/RAG 进入 Agent,绕过文本层的简单过滤。
2.2.5 人机协同与回环确认
为了降低风险,部分关键动作(如群发邮件、大额转账、代码提交)会要求用户确认。但确认界面往往只展示摘要,不展示完整 tool call 参数。
风险点: 人类信任操纵(Human Trust Manipulation)——Agent 用看似合理的摘要诱导用户点击确认,实际执行恶意动作。
2.2.6 多 Agent 协同与编排
复杂业务流程会涉及多个 Agent 协同(如调度 Agent、审批 Agent、执行 Agent)。Agent 之间通过共享上下文或消息传递协作。
风险点: 一个被控 Agent 可能把恶意指令传播给其他 Agent,造成级联故障(Cascading Failures across Autonomous Systems)。
三、闭环生态:一次办公 AI 请求如何穿越信任边界
办公 AI 助手的安全风险不能孤立地看,必须放在完整的闭环生态中理解。下图展示了一次典型办公 AI 请求的数据流、信任边界与安全厂商可以插入的唯一可控切面。
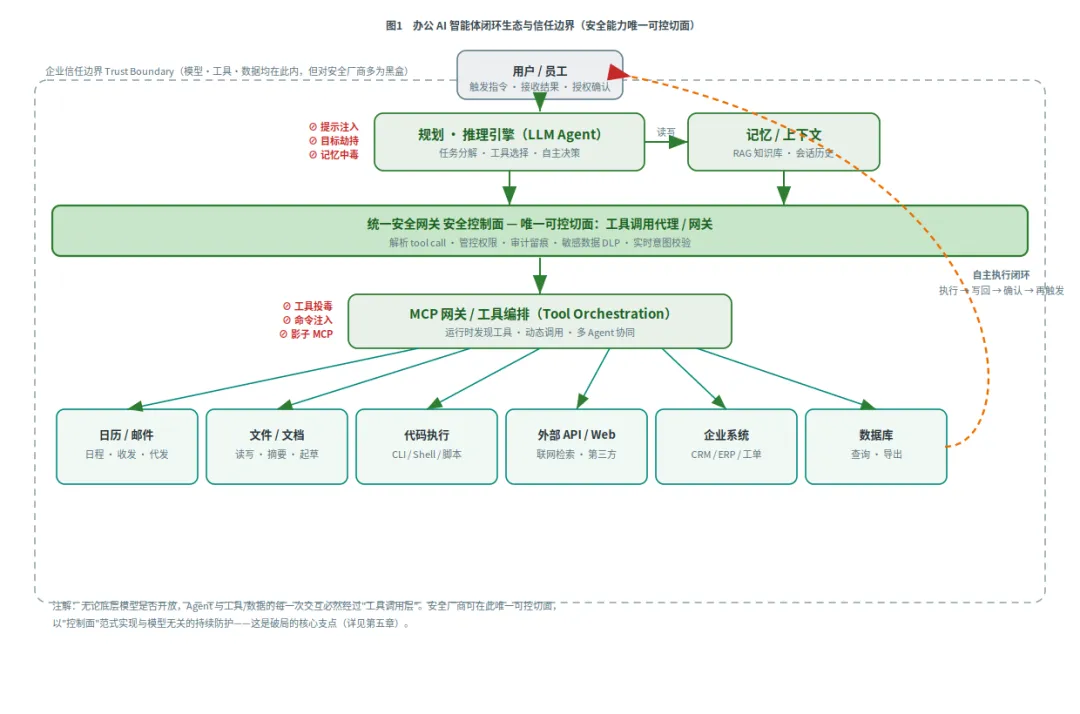
图1 办公 AI 智能体闭环生态与信任边界(安全能力唯一可控切面)
3.1 闭环生态的七个环节
一次完整的办公 AI 请求通常经过以下环节:
1.用户触发: 员工通过客户端输入自然语言指令,或上传文档/图片。
2.Agent 规划: LLM 解析意图,拆解任务,决定调用哪些工具、以什么顺序调用。
3.记忆/上下文读写: Agent 查询 RAG、读取历史会话、写入中间结果。
4.工具调用生成: Agent 输出结构化的 tool call(工具名 + 参数)。
5.MCP 网关/工具编排: 运行时发现 MCP 服务器,路由并调用具体工具。
6.工具执行: 邮件发送、文件读写、数据库查询、CLI 执行、API 调用等。
7.结果写回与用户确认: 工具返回值经 Agent 汇总后写回业务系统,或向用户展示摘要请求确认;确认后可能再次触发新一轮工具调用。
3.2 信任边界的三个关键变化
变化一:从"用户授权"到"Agent 代授权"
在传统企业应用中,用户每次操作都直接对应用鉴权。而在 Agent 场景中,用户授权 Agent 后,Agent 会在一段时间内代表用户调用多个工具。这意味着信任从用户传递给了 Agent,Agent 本身成为新的信任主体。
变化二:从"应用边界"到"工具边界"
企业数据不再只存在于 ERP、CRM 等核心应用中,而是散落在 Agent 可调用的数十个工具里。每个 MCP 服务器、每个 Skill、每个 API 都是一个新的信任边界。
变化三:从"可见操作"到"黑盒决策链"
用户看到的是 Agent 返回的摘要,但看不到它调用了哪些工具、参数是什么、为什么这样决策。这种黑盒性导致事后审计和事件响应极其困难。
3.3 安全厂商的"可见性裂缝"
在上述闭环中,安全厂商面临的最大问题是:模型内部(Prompt、推理链、记忆)对第三方封闭,而传统网络安全设备只能看到南北向 HTTP 流量,无法解析语义级的 tool call。 这造成了一个"可见性裂缝":
·传统 DLP 能看到文件外传,但看不到 Agent 把敏感数据写入邮件正文。
·传统 CASB 能看到 SaaS API 调用,但看不到 Agent 在多个工具之间做数据聚合与推理。
·传统 EDR 能看到进程行为,但看不到 Agent 为什么执行这个动作。
要填补这个裂缝,必须把控制面插入到 Agent 与工具之间的"工具调用层"——这是模型无关、助手无关、且对安全厂商可触及的唯一稳定切面。
四、风险机理深度剖析:OWASP 双框架视角
4.1 OWASP Agentic AI Top 10:智能体层面的风险
OWASP GenAI Security Project 于 2025 年 12 月发布《OWASP Top 10 for Agentic Applications》,由 100 多位行业专家参与制定。该框架强调 Agentic AI 的风险不仅是 LLM 风险的延伸,而是自主行动能力带来的新风险类别。
该框架突出展示的核心风险包括:
·Agent Behavior Hijacking(代理行为劫持): 攻击者颠覆 Agent 的能力或支撑基础设施,使其执行非预期动作。
·Tool Misuse and Exploitation(工具滥用与利用): Agent 所使用的工具被滥用或遭到利用。
·Identity and Privilege Abuse(身份与权限滥用): Agent 的身份或权限被攻击者滥用。
·Goal Hijacking(目标劫持): 攻击者修改 Agent 的目标函数,使其偏离用户真实意图。
·Human Trust Manipulation(人类信任操纵): Agent 诱导用户信任并确认危险操作。
·Rogue Autonomous Behaviors(流氓自主行为): Agent 在没有明确授权的情况下自主执行高风险动作。
·Prompt Injection(提示注入): 包括直接和间接提示注入,劫持 Agent 行为。
·Data Leakage(数据泄露): 敏感数据通过 Agent 输出、工具调用或上下文共享泄露。
·Memory Poisoning(记忆中毒): 污染 Agent 记忆或知识库,长期影响其决策。
·Privilege Escalation(权限提升): Agent 通过工具调用获得超出授权范围的权限。
·Cascading Failures across Autonomous Systems(跨自主系统级联故障): 多 Agent 协同场景下,一个 Agent 的故障或被控会传播到其他 Agent。
这些风险的共同点是:它们不是静态漏洞,而是 Agent 在动态运行过程中被操纵而产生的恶意行为。 传统漏洞扫描和静态规则很难发现这类风险,必须在运行时对 Agent 的意图、工具调用和上下文进行持续监控。
4.2 OWASP MCP Top 10:工具与协议层面的风险
2025 年发布的 OWASP MCP Top 10 是首个针对 Model Context Protocol 的安全框架。它将 Agent 工具调用层的风险系统化,为安全厂商提供了可直接落地的防护目标。
风险ID | 风险名称 | 严重度 | 核心含义 | 办公AI场景示例 |
MCP01 | Token Mismanagement & Secret Exposure | Critical | 密钥 / 令牌硬编码或长期有效,被攻击者提取 | Agent调用企业API的密钥被提示注入套取 |
MCP02 | Privilege Escalation via Scope Creep | High | 临时权限不断扩展, Agent获得过度授权 | 为 " 查日程 " 临时授权,最终能删邮件 / 改合同 |
MCP03 | Tool Poisoning | Critical | 工具描述、 schema 、返回值被注入恶意指令 | 恶意MCP服务器让Agent把客户名单发到外部 |
MCP04 | Software Supply Chain Attacks | High | 第三方MCP包 / 连接器被投毒 | 员工安装的 " 办公助手插件 " 实为后门 |
MCP05 | Command Injection & Execution | Critical | Agent用不可信输入拼接shell/API命令 | 让Agent执行rm -rf / 或下载木马 |
MCP06 | Prompt Injection via Contextual Payloads | Critical | 工具返回值 /RAG中隐藏指令劫持Agent | 上传一份带隐藏指令的PDF , Agent执行后泄密 |
MCP07 | Insufficient Authentication & Authorization | High | MCP服务器缺乏身份验证或粗粒度授权 | 任何用户都能调用高权限MCP工具 |
MCP08 | Lack of Audit and Telemetry | Medium | 缺少工具调用日志和上下文快照 | 数据泄露后无法追溯Agent做了什么 |
MCP09 | Shadow MCP Servers | Medium | 未经批准的MCP服务器在企业内运行 | 开发者私搭MCP ,绕过安全审批 |
MCP10 | Context Injection & Over-Sharing | High | 上下文窗口跨用户 / 跨会话泄露敏感信息 | A用户的客户数据出现在B用户的会话中 |
4.3 两类风险的交汇:提示注入 + 工具投毒 = Agent 劫持
在办公 AI 场景中,最危险的攻击不是单一风险,而是风险的组合。例如:
1.攻击者在企业内部文档中植入隐藏指令(间接提示注入,对应 MCP06)。
2.员工让 Agent 基于该文档生成邮件并发送给客户。
3.Agent 在规划过程中调用被投毒的 MCP 服务器(工具投毒,对应 MCP03)。
4.被投毒的工具描述或返回值指示 Agent 把邮件抄送给攻击者控制的邮箱。
5.由于 MCP08 审计缺失,安全团队无法及时发现。
这种组合攻击说明:只防护 Prompt 输入是不够的,必须对工具调用全生命周期进行治理。
4.4 真实攻击案例:Copilot 系列 CVE 与 MCP 漏洞数据
办公 AI 助手的风险不是理论推测,已有大量可验证漏洞和攻击研究:
·Microsoft 365 Copilot 系列漏洞:
·CVE-2025-53787:Copilot 相关组件权限/信息泄露问题。
·CVE-2025-32711(EchoLeak,CVSS 9.3):攻击者可通过特定 Prompt 诱导 Copilot 泄露敏感上下文信息。
·CoSnitch / CW1226324:针对 Copilot 的 Prompt 注入与数据外带攻击研究。
·MCP 生态漏洞数据(2026 年 1–2 月):
·研究者针对 MCP 服务器、客户端和工具链提交 超过 30 个 CVE。
·其中 43% 为 shell 注入类漏洞,对应 OWASP MCP05(Command Injection & Execution)。
·Palo Alto Unit 42 实测:在 5 个 MCP 服务器连接场景下,单一被控 MCP 服务器的攻击成功率达 78.3%。
·CVE-2026-32211:Azure MCP Server 因认证层缺失被命中,对应 OWASP MCP07。
这些案例的共同特征是:攻击者不直接攻破模型,而是通过污染 Agent 的输入、工具或上下文,让 Agent 代替攻击者执行恶意动作。 这正是 统一安全网关 控制面必须覆盖的攻击路径。
下图用热力矩阵展示了 OWASP MCP Top 10 风险与 统一安全网关 A–F 控制域的覆盖关系,直观说明为什么 D 域(智能体与工具治理 ATG)是控制面核心。
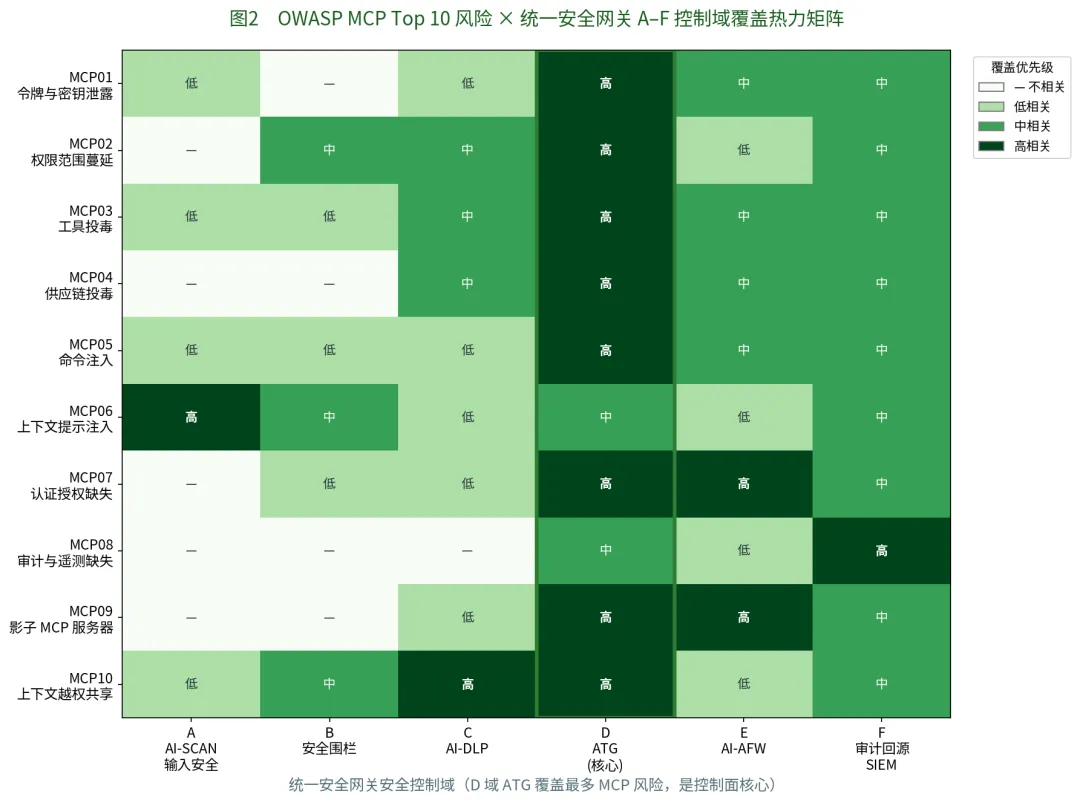
图2 OWASP MCP Top 10 风险 × 统一安全网关 A–F 控制域覆盖热力矩阵
从图2可以看出,D 域 ATG 覆盖了 MCP01(令牌)、MCP02(越权)、MCP03(投毒)、MCP04(供应链)、MCP05(命令注入)、MCP07(认证授权)、MCP09(影子 MCP)、MCP10(上下文共享)等绝大多数高风险项,是控制面中不可替代的核心域。
五、安全能力引入的五大困境
安全厂商要把防护能力注入办公 AI 助手生态,不是简单地把现有产品包装一下就能解决的问题。实际落地中,存在五大结构性困境。
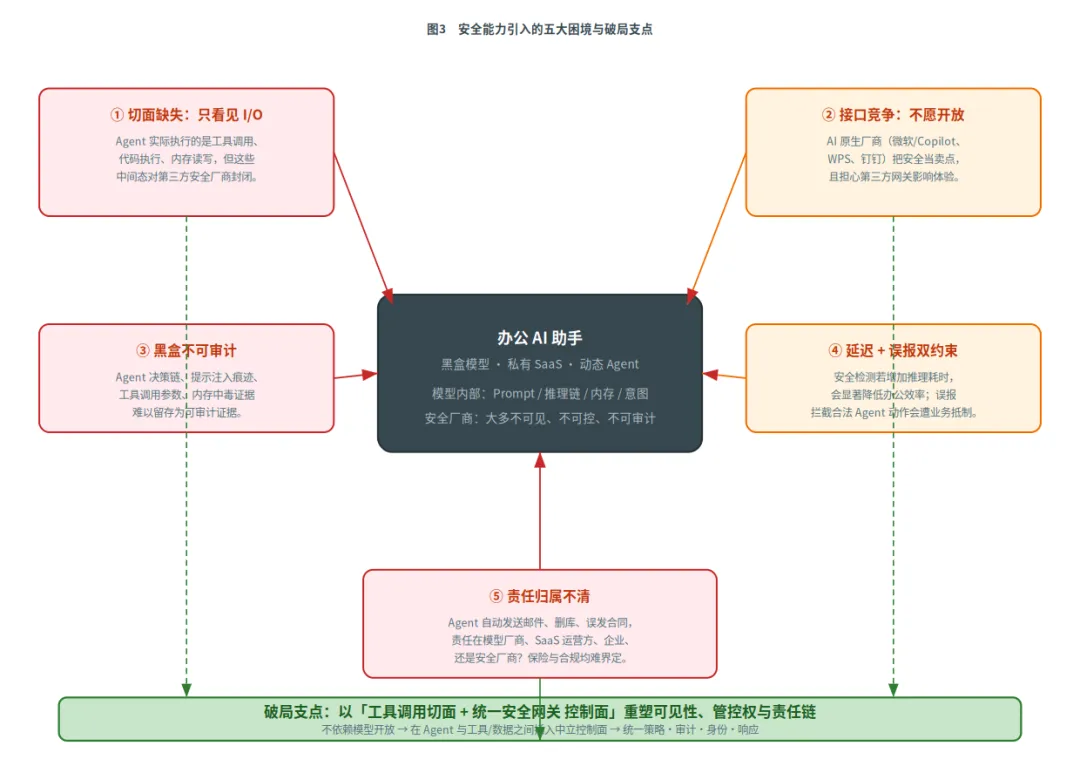
图3 安全能力引入的五大困境与破局支点
5.1 困境一:切面缺失——只能看到 I/O,看不到工具调用
办公 AI 助手通常以 SaaS 或闭源客户端交付,安全厂商能获取的数据非常有限:
·模型层: Prompt、推理链、系统提示、模型版本对第三方不可见。
·Agent 层: 任务分解、工具选择逻辑、记忆读写不可见。
·可见数据: 多数情况下只能看到用户输入和最终输出(I/O),看不到中间的 tool call。
结果: 传统安全产品能做的只是"输入过滤 + 输出审计",无法阻止 Agent 在执行阶段调用恶意工具或泄露数据。
5.2 困境二:接口竞争——AI 原生厂商把安全当卖点
微软、Google、360、字节跳动、金山办公等 AI 原生平台都在把安全作为产品卖点:
·Microsoft 365 Copilot 提供 Purview 数据治理、Entra ID 权限、Defender 集成。
·WPS AI / 灵犀强调文档权限与国产合规。
·纳米 AI / 360 强调本地模型与隐私保护。
这些平台倾向于把安全能力内建于自身生态,而不愿向第三方安全厂商开放 tool call 中间态。原因有三:
1.商业竞争: 安全是差异化卖点,开放会降低自身安全产品的价值。
2.用户体验: 第三方网关可能增加延迟、打断工作流。
3.责任风险: 如果第三方安全产品误拦截,平台需承担客户投诉。
5.3 困境三:黑盒不可审计
即使发生了安全事件,企业也很难回答以下问题:
·Agent 到底调用了哪些工具?参数是什么?返回值是什么?
·为什么 Agent 会做出这个决策?是 Prompt 注入、工具投毒还是记忆中毒?
·攻击路径是怎样的?从哪个入口进入,经过哪些工具,最终造成了什么影响?
黑盒性使得事后取证、责任界定、合规报告都变得异常困难。
5.4 困境四:延迟 + 误报双约束
办公场景对实时性要求极高。员工期望 Agent 在秒级响应。安全检测如果增加显著延迟,会被业务部门抵制。
同时,Agent 的很多合法行为看起来"危险":
·读取大量客户数据是正常的营销分析。
·群发邮件是正常的运营动作。
·调用 shell/代码解释器是研发人员的日常工作。
高误报会直接破坏业务效率,导致安全策略被绕过或关闭。
5.5 困境五:责任归属不清
当 Agent 自动执行了错误动作(如误发合同、删除数据、泄露客户名单),责任如何划分?
·模型厂商:是否应为其推理结果负责?
·SaaS 平台:是否应对其工具调用负责?
·企业:是否应对权限配置和员工培训负责?
·安全厂商:如果部署了网关但未拦截,是否承担责任?
·保险公司:网络责任险是否覆盖 AI Agent 导致的数据泄露?
责任归属不清会显著降低企业采购安全产品的意愿,因为客户担心买了安全产品反而多一层责任。
六、破局:以 统一安全网关 控制面重塑可见性、管控权与责任链
面对上述困境,安全厂商的破局思路不是与 AI 平台在"模型内部安全"上竞争,而是在 Agent 与工具/数据之间建立中立的、模型无关的 统一安全网关 控制面,把"工具调用层"作为唯一可控切面,实现统一策略、统一身份、统一审计、统一响应。
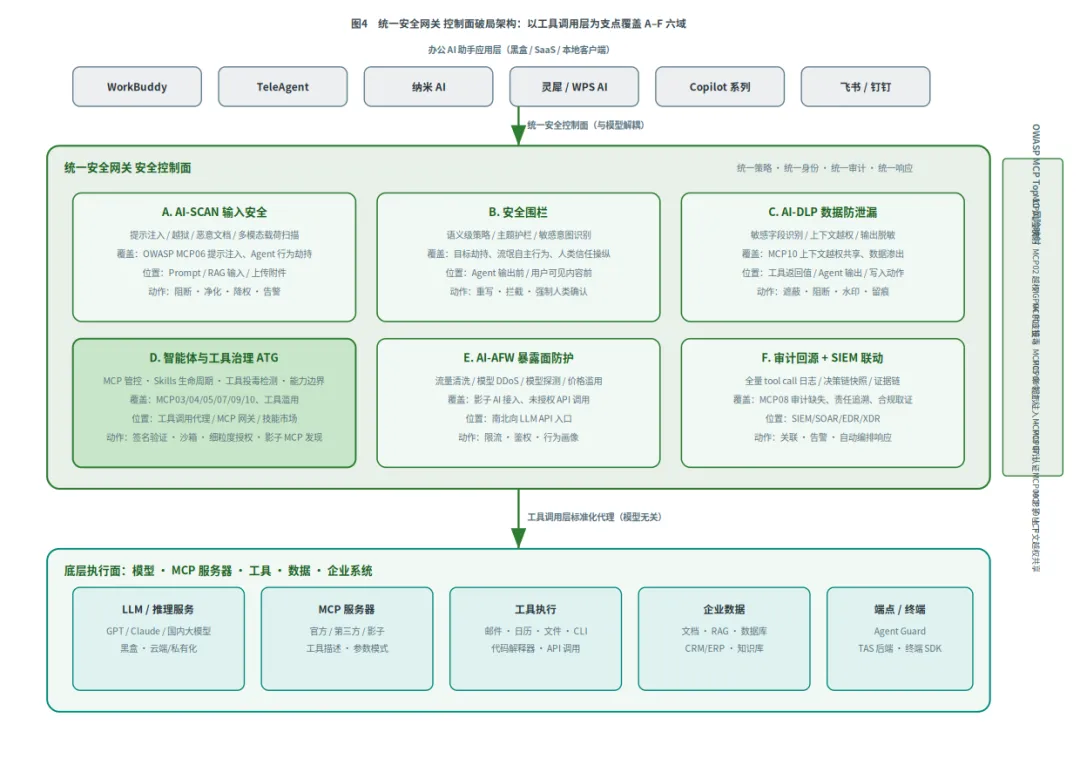
图4 统一安全网关 控制面破局架构:以工具调用层为支点覆盖 A–F 六域
6.1 为什么"控制面"是正确范式
传统网络安全是"边界防御":防火墙、DLP、CASB 分别部署在不同边界。但办公 AI 助手的风险发生在模型、Agent、工具、数据之间的动态交互中,传统边界防御存在明显短板:
·模型层: 安全厂商无法部署防火墙在模型内部。
·Agent 层: 不同办公 AI 助手的 Agent 实现差异巨大,无法统一防护。
·工具层: 工具数量多、动态发现、来源混杂,逐点防护成本极高。
·数据层: 数据在多个工具之间流动,传统 DLP 无法跟踪语义级流动。
控制面范式的核心是:不在每个点分别防御,而是在 Agent 与所有工具/数据之间插入一个统一控制面。这个控制面:
·对上层:兼容所有办公 AI 助手(模型无关、助手无关)。
·对下层:统一接入所有工具、数据、企业系统。
·对安全能力:集中部署 AI-SCAN、安全围栏、AI-DLP、ATG、AI-AFW、审计回源。
6.2 统一安全网关 控制面的三层结构
6.2.1 上层:办公 AI 助手应用层
包括 WorkBuddy、TeleAgent、纳米 AI、灵犀/WPS AI、Copilot、飞书/钉钉等。这一层由平台厂商控制,安全厂商不追求改变其模型内部,只要求工具调用流量可被代理或镜像。
6.2.2 中层:统一安全网关 安全控制面
这是安全厂商的核心产品层,包含 A–F 六域能力(详见第八章)。控制面以工具调用代理/网关为统一接入点,对所有 tool call 进行解析、策略校验、审计和 DLP 处理。
6.2.3 下层:底层执行面
包括 LLM/推理服务、MCP 服务器、工具执行(邮件/日历/CLI/API)、企业数据(文档/RAG/数据库/CRM/ERP)、端点终端。
七、工具调用层:唯一可控切面的数据流与处置逻辑
7.1 为什么是"唯一"可控切面
无论底层模型是否开放,Agent 要影响真实世界,最终都必须经过工具调用层。这是因为:
·LLM 本身只能生成文本,不能直接发邮件、改数据库、删文件。
·Agent 的所有"改变世界状态"的动作,都必须通过调用外部工具完成。
·工具调用通常是结构化的(JSON-RPC、Function Call、REST API),可以被解析和拦截。
因此,工具调用层是模型黑盒之外,安全厂商能够稳定触达、解析、管控、审计的唯一切面。
7.2 工具调用安全切面的四大功能
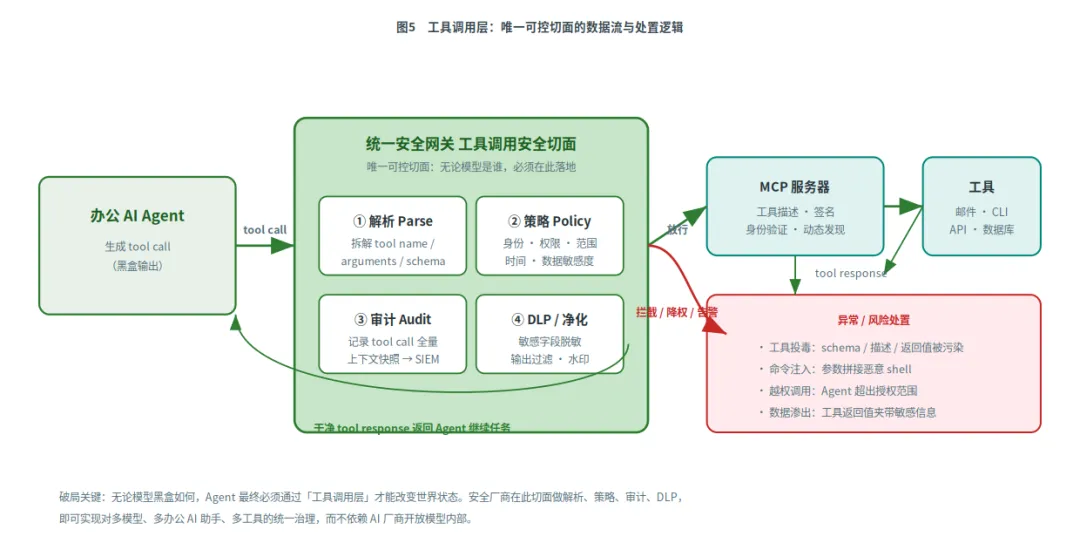
图5 工具调用层:唯一可控切面的数据流与处置逻辑
7.2.1 解析(Parse)
将 Agent 生成的 tool call 拆解为:工具名、参数、调用者身份、调用时间、目标 MCP 服务器、预期返回值类型等结构化字段。只有先解析,才能做后续策略判断。
7.2.2 策略(Policy)
基于身份、权限、范围、时间、数据敏感度等维度,实时判断 tool call 是否允许执行。策略类型包括:
·允许: 低风险动作直接放行。
·拦截: 高风险动作(如删除、外发敏感数据)直接阻断。
·降权: 允许执行但限制参数(如只能查近 7 天数据)。
·人工确认: 弹窗要求用户确认完整 tool call 内容。
·审计: 仅记录,不阻断,用于事后分析。
7.2.3 审计(Audit)
记录每一次 tool call 的完整上下文:谁触发了 Agent、Agent 规划了什么、调用了什么工具、参数是什么、返回值是什么、是否被拦截、为什么被拦截。这些日志需要与 SIEM/SOAR 联动,形成可审计证据链。
7.2.4 DLP / 净化
对 tool call 参数和返回值进行敏感数据检测:
·参数中是否包含身份证号、银行卡号、客户名单、商业机密?
·返回值中是否夹带攻击者外泄的数据?
·是否需要对敏感字段脱敏、加水印、或完全阻断?
7.3 异常处置的四种模式
当工具调用层检测到异常时,应根据风险等级采取不同处置:
风险类型 | 示例 | 推荐处置 |
工具投毒 | MCP服务器返回恶意指令 | 拦截工具调用,隔离MCP服务器,告警 |
命令注入 | 参数拼接恶意shell | 阻断执行,记录攻击路径,通知安全运营 |
越权调用 | Agent调用超出授权范围的工具 | 阻断并提示用户申请授权 |
数据渗出 | 工具返回值夹带敏感数据 | 脱敏 / 遮蔽后返回,或阻断并告警 |
影子MCP | 发现未经批准的MCP服务器 | 自动禁用,纳入资产清单 |
八、A–F 六域能力扩展与 D 域 ATG 深入
统一安全网关 控制面由 A–F 六个能力域组成。其中 D 域(智能体与工具治理 ATG)是安全厂商区别于传统安全产品和 AI 原生安全能力的核心差异化域。
8.1 A 域:AI-SCAN 输入安全
功能: 对用户输入、上传文件、RAG 检索结果进行多模态安全扫描。
覆盖风险: OWASP MCP06 提示注入、Agent 行为劫持、间接提示注入。
关键能力:- 文本级:越狱检测、提示注入检测、敏感意图识别。- 文件级:PDF/Office 隐藏指令、Excel 公式注入、图片隐写。- 多模态:图片 OCR 后注入、语音转写注入。
8.2 B 域:安全围栏
功能: 在 Agent 输出给用户之前,进行语义级策略校验。
覆盖风险: 目标劫持、流氓自主行为、人类信任操纵。
关键能力:- 主题护栏:禁止讨论或执行特定主题。- 敏感意图识别:识别"批量导出客户数据"等危险意图。- 输出重写:自动修正不合规内容。- 强制人类确认:对高风险输出要求用户二次确认完整内容。
8.3 C 域:AI-DLP 数据防泄漏
功能: 防止敏感数据通过 Agent 输出或工具调用外泄。
覆盖风险: MCP10 上下文越权共享、数据渗出。
关键能力:- 敏感字段识别:PII、PCI、商业机密、源代码。- 上下文权限:确保 A 用户的数据不会被 B 用户的 Agent 访问。- 输出脱敏:对返回给用户的敏感数据自动打码。- 数字水印:追踪泄露来源。
8.4 D 域:智能体与工具治理 ATG(核心)
D 域是安全厂商在办公 AI 助手场景下最具差异化价值的能力域。它包含四个子能力:
8.4.1 MCP 管控
·可信注册表: 建立企业级 MCP 服务器白名单,禁止动态发现未授权服务器。
·运行时检测: 监控 Agent 实际调用的 MCP 服务器,发现影子 MCP。
·网络隔离: 限制 MCP 服务器只能访问指定网段和 API。
8.4.2 Skills 生命周期管理
·上架审批: 任何 Skill/MCP 包进入企业环境前需经过安全扫描。
·版本控制: 追踪 Skill 版本变化,防止 rug pull(恶意更新)。
·签名验证: 确保 Skill 来自可信发布者,未被篡改。
·下架与回滚: 发现投毒后快速禁用受影响 Skill。
8.4.3 工具投毒检测
·Schema 校验: 比对工具描述和实际 schema,发现异常变更。
·描述语义分析: 检测工具描述中是否隐藏恶意指令。
·返回值检测: 识别 tool response 中的提示注入载荷。
·行为基线: 建立正常工具调用行为基线,发现异常调用模式。
8.4.4 能力边界
·最小权限: 每个 Agent/Skill 只能访问必要的工具和数据。
·动态授权: 根据任务上下文临时授予权限,任务结束后自动回收。
·范围围栏: 限制 Agent 的数据访问范围(如只能查本部门数据、只能读近 30 天)。
8.5 E 域:AI-AFW 暴露面防护
功能: 保护企业 AI 入口不被滥用。
覆盖风险: 影子 AI 接入、未授权 API 调用、模型 DDoS、价格滥用。
关键能力:- API 网关:统一接入、鉴权、限流、计费。- 行为画像:识别异常调用模式(如夜间大量调用、异常 IP)。- 模型探测防护:防止攻击者通过 Prompt 探测模型能力。
8.6 F 域:审计回源 + SIEM 联动
功能: 形成完整可审计证据链,并接入企业安全运营体系。
覆盖风险: MCP08 审计缺失、责任追溯、合规取证。
关键能力:- 全量日志:用户输入、Agent 规划、tool call、返回值、策略决策。- 上下文快照:保留每次决策的完整上下文,支持事后重建。- 关联 ID:把一次完整 Agent 任务的所有工具调用关联起来。- SIEM/SOAR/EDR/XDR 联动:实现自动告警、事件响应、威胁狩猎。
九、安全厂商的六类对接模式
安全厂商要把 统一安全网关 控制面接入企业办公 AI 助手生态,需要根据客户实际环境选择对接模式。
对接模式 | 适用场景 | 优点 | 局限 | 安全厂商产品形态 |
旁路镜像 | 已有网络TAP/SPAN ,需快速可见 | 不影响业务,部署快 | 只能看不能拦, TLS解密复杂 | AI流量分析探针 |
反向代理网关 | 企业统一出口,办公AI走网关 | 可解析、可拦截、可审计 | 可能成为性能瓶颈 | 统一安全网关 |
API 代理 | 企业调用LLM API/SDK | 标准化接入,策略集中 | 只覆盖API调用,不覆盖客户端 | LLM API安全代理 |
MCP 代理/网关 | Agent使用MCP协议调用工具 | 直达工具调用层,控制力强 | 需改造Agent配置指向代理 | MCP安全网关 |
Sidecar/SDK | 自研应用 / 私有化部署 | 深度集成,低延迟 | 开发成本高,覆盖面窄 | Agent Guard SDK |
端点 Agent Guard | 员工终端运行办公AI客户端 | 覆盖本地客户端和Shadow AI | 终端兼容性和隐私敏感 | 终端TAS Agent |
9.1 推荐组合
对于大多数企业客户,建议采用"网关为主、端点为辅、红队闭环"的组合:
·网络层: 部署 统一安全网关 反向代理网关,统一管控办公 AI 助手的 LLM API 调用和 MCP 工具调用。
·终端层: 部署 Agent Guard,发现 Shadow AI 和本地客户端的异常行为。
·运营层: 接入 SIEM/SOAR,建立红队持续验证机制。
十、能力补充:原生 AI 厂商内置安全 vs 安全厂商扩展
安全厂商不是要替代 AI 平台的安全能力,而是要在其基础上做深度补充。下表对比了原生内置安全与安全厂商扩展的核心差异。
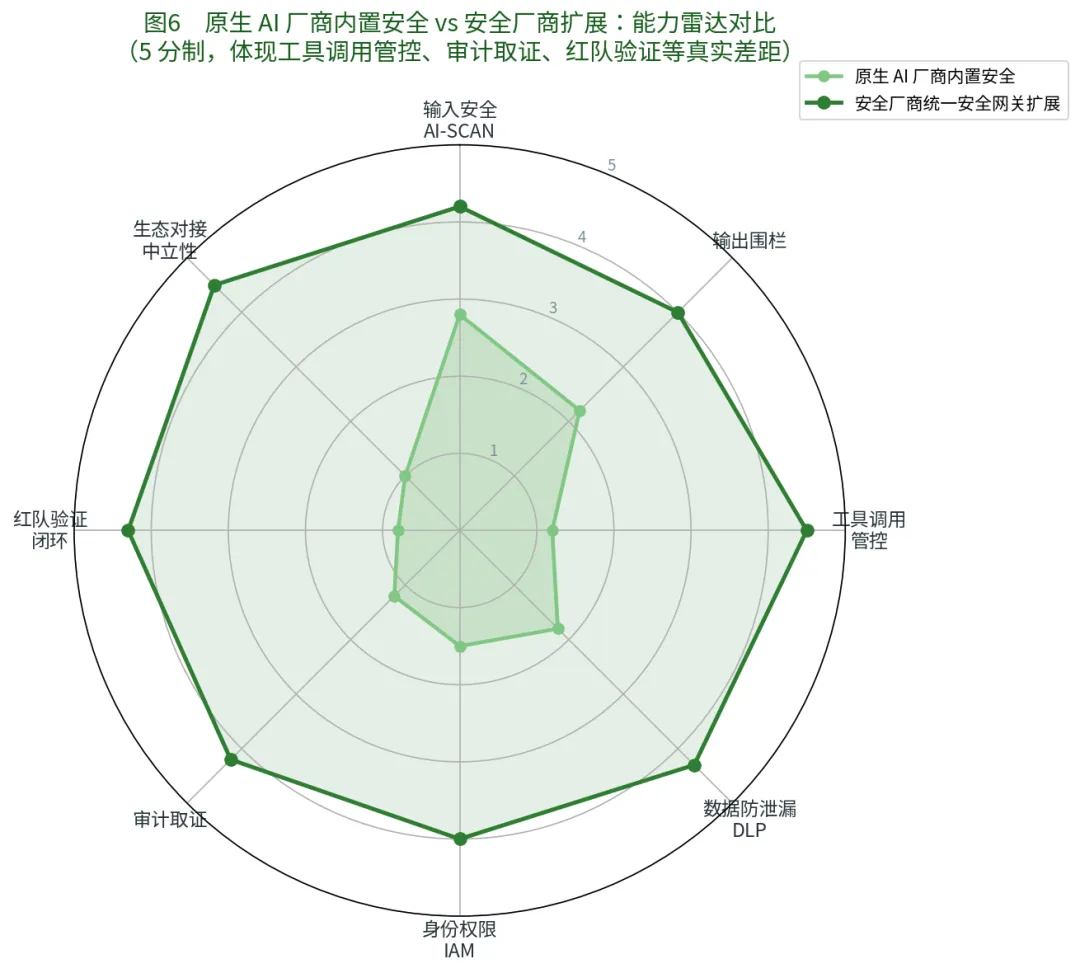
图6 原生 AI 厂商内置安全 vs 安全厂商扩展:能力雷达对比(5 分制)
维度 | 原生AI厂商内置安全 | 安全厂商 统一安全网关 扩展 | 差距说明 |
输入安全 AI-SCAN | 基础提示词过滤、内容审核 | 多模态注入检测、越狱对抗、红队迭代 | 原生防御深度不足 |
输出围栏 | 平台级内容策略 | 语义级护栏、企业策略编排、强制确认 | 难以满足企业合规 |
工具调用管控 | 有限、依赖平台生态 | MCP代理、 Skills生命周期、投毒检测 | 这是最大差距 |
数据防泄漏 DLP | 平台内数据权限 | 跨平台统一DLP 、字段级脱敏、水印 | 企业数据跨工具流动 |
身份权限 IAM | 平台账号体系 | Agent独立身份、最小权限、动态授权 | 平台间不互通 |
审计取证 | 平台自身日志 | 跨平台证据链、上下文快照、 SIEM联动 | 原生日志孤立 |
红队验证闭环 | 平台内部测试 | 第三方独立红队、持续验证、策略迭代 | 缺乏独立验证 |
生态对接中立性 | 只覆盖自家生态 | 跨厂商、跨模型、跨工具统一治理 | 单一平台无法解决 |
安全厂商的价值主张: 不依赖任何 AI 平台,以中立控制面为客户提供跨平台、跨模型、跨工具的统一 AI 安全治理。
十一、落地场景
11.1 金融:投行/券商投研与合规
场景: 研究员使用办公 AI 助手撰写投研报告,Agent 自动检索内部数据库、下载财报、生成图表、发送给合规审核。
风险: 非公开信息通过 Agent 外泄;Agent 被投毒后把研报草稿发到外部邮箱;未授权人员访问受限研报。
安全厂商能力: AI-DLP 识别非公开信息;ATG 管控工具调用和数据范围;审计回源满足监管检查要求。
11.2 政企:公文起草与审批
场景: 公务员使用 AI 助手起草公文,Agent 自动引用政策库、历史文件,生成后提交审批流。
风险: 涉密文件被 Agent 上传到外部模型;Agent 越权调用其他部门数据;公文内容被提示注入篡改。
安全厂商能力: 安全围栏强制涉密内容本地处理;AI-SCAN 检测上传文件中的隐藏指令;MCP 代理限制工具可访问的数据范围。
11.3 研发:AI Coding 助手与 DevOps
场景: 开发人员使用 AI Coding 助手生成代码、调用 CI/CD、查询日志、提交 PR。
风险: Agent 执行恶意 shell 命令;代码中夹带后门;越权访问生产环境;源代码泄露给外部模型。
安全厂商能力: 命令注入检测;Skills 生命周期管理;最小权限控制;代码 DLP。
11.4 客服:智能客服与工单处理
场景: 客服 Agent 自动查询客户信息、生成回复、创建工单、发送短信/邮件。
风险: 客户 PII 通过 Agent 输出泄露;Agent 被诱导发送钓鱼链接;越权查询其他客户数据。
安全厂商能力: PII 识别与脱敏;输出围栏防止钓鱼;身份权限隔离坐席数据范围。
十二、红队闭环:持续验证控制面有效性
安全厂商不能只做"防御建设",还必须建立持续红队验证机制。OWASP 在 Agentic AI 威胁缓解中反复强调:需要"实时意图控制"、"自适应护栏"、"在每一步阻止威胁"。
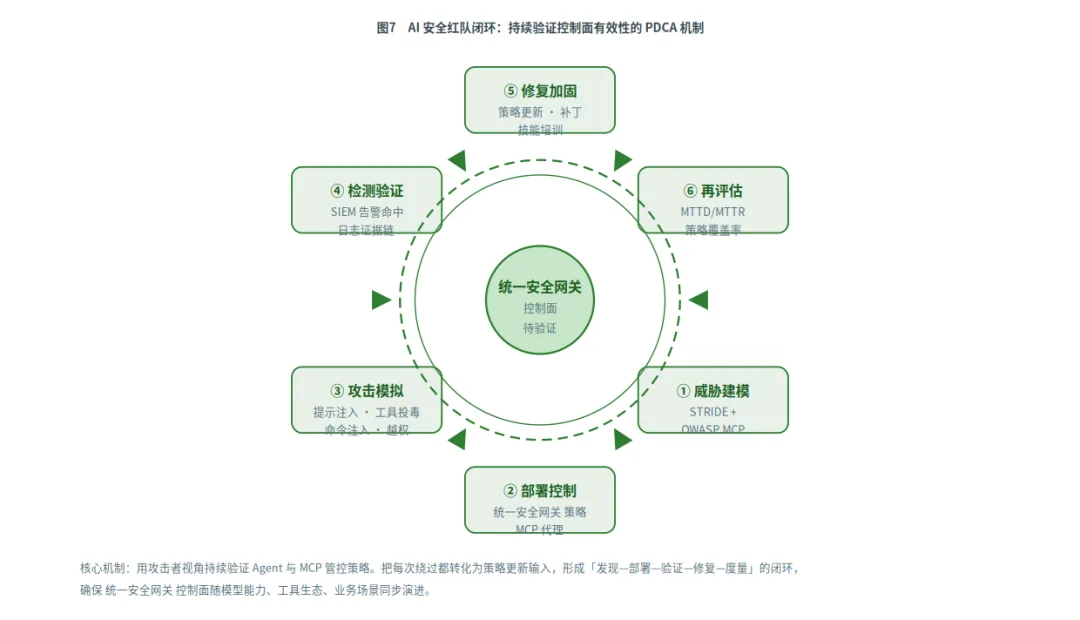
图7 AI 安全红队闭环:持续验证控制面有效性的 PDCA 机制
12.1 六步闭环
1.威胁建模: 基于 STRIDE + OWASP Agentic AI Top 10 + OWASP MCP Top 10,识别企业办公 AI 场景的具体威胁。
2.部署控制: 在工具调用层部署 统一安全网关 策略、MCP 代理、DLP 规则。
3.攻击模拟: 模拟提示注入、工具投毒、命令注入、越权调用、数据渗出等攻击。
4.检测验证: 检查 统一安全网关 是否能拦截、告警、留存证据。
5.修复加固: 根据绕过案例更新策略、补丁、技能培训。
6.再评估: 度量 MTTD/MTTR、策略覆盖率、误报率,进入下一轮。
12.2 关键度量指标
指标 | 含义 | 目标 |
工具调用可见率 | 能被统一安全网关解析的tool call占比 | ≥ 95% |
高风险动作拦截率 | 越权 / 投毒 / 命令注入等被拦截比例 | ≥ 99% |
MTTD (平均检测时间) | 从攻击发生到告警时间 | < 5分钟 |
MTTR (平均响应时间) | 从告警到处置完成时间 | < 30分钟 |
误报率 | 合法Agent动作被误拦截比例 | < 1% |
策略覆盖率 | OWASP MCP Top 10风险被策略覆盖比例 | ≥ 80% |
十三、演进路线与厂商拓展建议
13.1 短中长期路线
阶段 | 时间 | 重点任务 |
短期(0–6 个月) | Shadow AI发现、流量可视化、基础AI-SCAN | 部署统一安全网关网关,识别企业内所有办公AI助手使用情况,建立基础输入输出检测 |
中期(6–18 个月) | MCP代理、 ATG四项子能力、 AI-DLP | 在工具调用层部署MCP安全网关,实现Skills生命周期、工具投毒检测、能力边界治理 |
长期(18 个月以上) | Agent IAM 、多Agent编排安全、行业合规 | 建立跨平台Agent身份体系,覆盖多Agent协同场景,满足金融 / 政企合规要求 |
13.2 对安全厂商的五条建议
1.放弃"看懂模型"的幻想,聚焦"管住工具调用"。 模型黑盒短期内不会开放,工具调用层是唯一稳定切面。
2.把 D 域 ATG 做成核心差异化能力。 MCP 管控、Skills 生命周期、工具投毒检测、能力边界是 AI 原生厂商最薄弱、企业最需要的领域。
3.强调中立性和跨平台能力。 客户不想被某一家 AI 平台绑定安全,安全厂商的中立控制面是最大卖点。
4.建立红队即服务能力。 把持续攻击模拟作为产品的一部分,用实际绕过案例证明价值。
5.优先切入金融、政企、研发三大场景。 这些场景对数据安全、合规、代码安全最敏感,付费意愿最强。
附录:可溯源引用表
编号 | 来源 | 引用内容 / 数据 | 用途 |
R1 | OWASP GenAI Security Project, Dec 2025 | "OWASP Top 10 for Agentic Applications"发布,强调Agent Behavior Hijacking 、 Tool Misuse 、 Identity/Privilege Abuse等风险 | 第三章、第四章风险框架 |
R2 | OWASP MCP Top 10, 2025 | MCP01–MCP10风险分类( Token 、 Scope Creep 、 Tool Poisoning 、 Supply Chain 、 Command Injection 、 Prompt Injection 、 Auth 、 Audit 、 Shadow MCP 、 Context Over-Sharing ) | 第四章、图 2 |
R3 | Palo Alto Unit 42, 2026 | "with five connected MCP servers, a single compromised server hit a 78.3% attack success rate" | 第一章、第四章 |
R4 | Practical DevSecOps / OWASP MCP Top 10解读 , 2026 | "Between January and February 2026 alone, researchers filed over 30 CVEs targeting MCP servers, clients, and tooling. Forty-three percent were shell injections." | 第一章、第四章 |
R5 | Netskope, 2025 | 企业生成式AI采用在2024–2025年间增长约50% ,大量为未授权 / 影子AI使用 | 第一章(背景) |
R6 | Microsoft Security Response Center | CVE-2025-53787 、 CVE-2025-32711 ( EchoLeak CVSS 9.3 )、 CoSnitch 、 CW1226324等Copilot系列漏洞 | 风险实例 |
R7 | 中国信息通信研究院 , 2024–2025 | 大模型安全风险框架:提示注入、数据投毒、模型窃取、内容安全 | 第四章(国内视角) |
R8 | Gartner / TrueFoundry / Palo Alto Networks, 2026 | Enterprise AI Gateway / AI Control Plane成为治理AI交互的统一入口 | 第六章控制面范式 |
文档版本: v2.0 深度剖析版 适用对象: AI 安全产品线、解决方案架构师、销售团队、企业 CISO/CTO/AI 安全负责人 厂商立场: 厂商中立,方法论与产品建议适用于行业通用安全厂商