ARTICLE · 992980
AI Insights|图灵测试之后,我们终于问了一个对的问题
2026年2月,印度新德里。
Google DeepMind 的 CEO 德米斯·哈萨比斯站在台上。2024年的诺贝尔化学奖刚装进口袋,他的身后是 AlphaFold——AI 在基础科学上第一次让全人类不得不认真对待的模型。
有人问他:你什么时候觉得 AI 就"到了"?什么时候我们能说,它真的拥有通用智能了?
哈萨比斯说,他脑子里一直有一个测试:
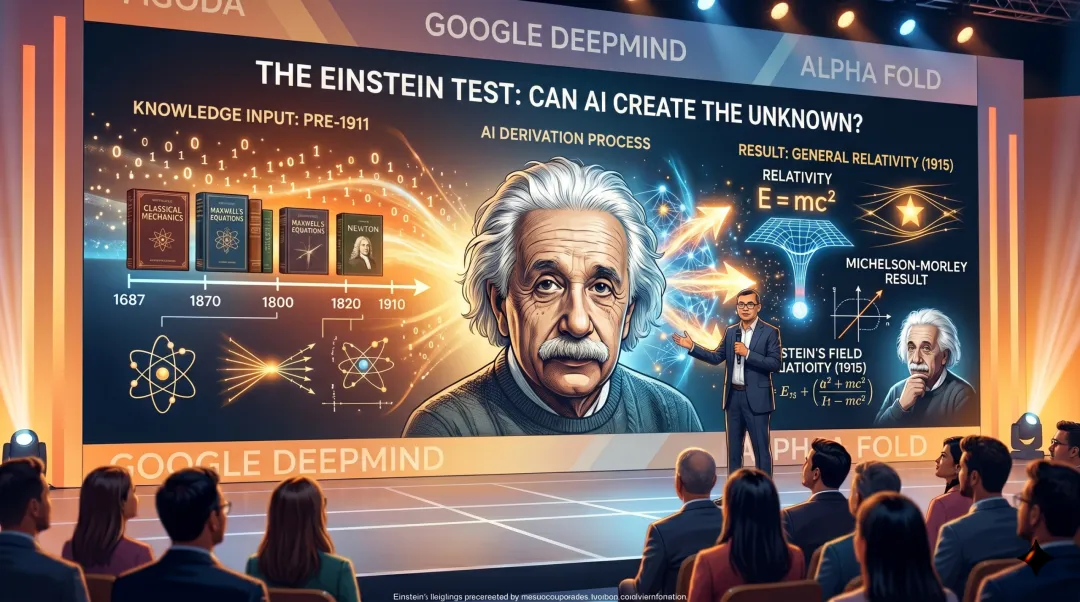
一个只学过1911年之前知识的人工智能,能不能独立推导出相对论?
不是让它背诵相对论的内容,不是让它根据1915年之后的论文做归纳。而是把训练数据切到1911年,让它只能看到爱因斯坦之前的物理学世界——然后看它能不能自己走到那个位置。
这听起来像一个思想实验。但它的份量,取决于我们怎么看待"AI 到底在学什么"这个问题。
图灵测的是模仿,爱因斯坦测的是创造
1950年,图灵提出了他的测试。一台机器如果能让人类评断者在对话中无法分辨它是人还是机器,就算通过了。
这个测试的迷人之处在于,它绕开了"机器能不能思考"这个永远无法精确定义的问题,直接问了一个可操作的问题:它表现得像不像一个有智能的存在?
问题是,它问的是"像不像"。
模仿不是理解,复述不是发现。今天的大语言模型已经能完美通过图灵测试的变体——写一封以某人语气发的邮件、模拟某人的写作风格、回答你任何关于历史人物的问题。但这和真正的思考之间,差的可不是一点点。
爱因斯坦测试换了一个方向。它不问 AI 能不能像人一样说话,而是问:AI 能不能做前人没做过的事?
爱因斯坦测试在测什么
哈萨比斯的测试有一个精确的结构:把模型的知识限制在某个历史节点之前(他举的例子是1911年),然后看它能不能独立推导出后来才出现的关键科学突破。
这个测试关注的是生成全新洞见的能力,不是从已有语料里做高质量归纳。
一个通过了这个测试的模型,不是因为它背了更多的东西,而是因为它能在有限的旧知识基础上,建立起新的概念框架。它需要在没有"答案"的情况下,自己发明出答案。
你可以把它理解为:不是问 AI 会不会复述爱因斯坦,而是问它能不能在"还没被告知答案"的情况下,自己走到爱因斯坦的位置。
图灵测试之后,为什么我们需要新的标尺
AI 的能力增长已经快到让"测试"这个词变得越来越模糊。
GPT-3 让全世界看到,只靠下一个词预测训练出来的模型,也能写出通顺的英文。ChatGPT 证明了语言模型不只是语言模型。GPT-5 和后来的推理模型,让 AI 开始在数学和编程上逼近人类专家。
这些进步都指向同一个方向:让 AI 更好地完成人类已经会做的事。
图灵测试的框架也是如此。它衡量的是"AI 能不能表现得像人"——换句话说,AI 能不能更好地完成我们已经知道怎么完成的任务。
但科学进步从来不是"做得更好"。相对论不是牛顿力学的升级版,它是牛顿力学框架里根本不会出现的东西。
爱因斯坦测试之所以重要,就是因为它要求 AI 跨越这个门槛:从模仿走向创造,从归纳走向发现。
Talkie:一次有趣的预演
去年,DeepMind 的研究者训练了一个叫 Talkie 的 130 亿参数模型。训练数据全部来自1931年之前出版的文本——书籍、报纸、专利、法庭记录。不上网,不看二战历史,不接触现代政治。
然后他们问了它一些问题。
最让人意外的是代码。Talkie 的训练数据里没有任何编程语言的样本。但研究人员发现,它从一本上世纪二十年代的代数课本里"学会"了 Python——或者说,它从代数符号的结构中推断出了编程语言的基本模式,然后用这些模式写出了一个能运行的程序。
它甚至展示了一种奇怪的推理能力:给定一个旋转密码的编码函数,它写出了对应的解码函数。
这听起来很像爱因斯坦测试的缩影。
但 Talkie 的另一个表现让这件事变得复杂。当被问到甘地的出生年份时,它以极高的信心给出了完全错误的答案——年份不对、城市不对,甚至可能把三个不同的人物混在一起了。它不知道自己不知道。
这个矛盾恰恰是爱因斯坦测试最难的地方:我们怎么区分"真正的洞见"和"听起来很对的幻觉"?
模型可能写出一个在数学上正确的程序,同时也能自信地说出根本不存在的历史事实。它可能掌握了某个模式的表面结构,却没有真正的理解。
通过爱因斯坦测试,到底意味着什么? 这是提出测试时就需要面对的问题。
争议:通过了就等于 AGI 吗?
反对者的核心论点很简洁:一个模型即使"通过"了爱因斯坦测试,也不证明它具有人类式的理解或通用智能。
它可能只是在概念空间里做了非常深的模式外推——从一个足够大的训练集里,它学会了"在什么条件下,什么答案看起来正确"。这和"理解"之间,可能还差着很远。
另一个批评来自数学界。OpenAI 的模型曾经找到过数学家 Erdős (埃尔德什·帕尔)的一个未解猜想的反例。数学家 Gowers 的第一反应是"完了,模型证明了定理,我们要失业了",后来才发现模型是证伪了猜想——它不是通过理解做出的判断,而是通过暴力搜索在可能性空间里碰到了一个结果。
AI 可以是"异常值引擎",但不一定是"洞见引擎"。
支持者也有很强的理由:如果一个系统能在没有外部知识注入的情况下,独立做出爱因斯坦级别的科学发现,那它离 AGI 已经不远了。不管这个系统"理解"了什么,它的行为已经等同于一个拥有超强科学能力的智能体。
两边可能都没有错。只是"理解"和"行为等价"之间,从来就不是同一个概念。
为什么这个测试对普通人也重要
爱因斯坦测试改变了一个叙事。
过去五年的主流叙事:AI 正在变成更好的工具——更快的搜索引擎、更高效的客服、更聪明的助手。这些说法都是对的,但前提是:AI 是在加速人类已有的能力。
爱因斯坦测试提出了另一种可能:AI 也许不只是加速工具,而是合作者——一个能在你看不见的地方,帮你发现新的东西。
这当然不是说,AI 已经能做到这个了。也不说,爱因斯坦测试一旦通过,一切就都清楚了。
但至少,当我们开始用"能不能像爱因斯坦一样思考"来评估 AI 的时候,这件事本身就改变了我们讨论的层次。
过去我们问的是:机器能不能像人一样说话?
现在我们开始问:机器能不能做出人还没做过的事?
答案还悬在那里。
哈萨比斯在印度 AI 峰会上说,AGI 可能在未来5到8年内到来。
至于爱因斯坦测试什么时候有人通过——我们走着看。
*本文依据网络搜集数据整理,由AI工具辅助完成All rights reserved. Copyright © 2026