ARTICLE · 993418
PDF解析快34倍 + Agent不再失忆:本周两个值得关注的开源项目
PDF智能路由 × Agent团队记忆
本周两个项目,一个解决PDF解析的"翻车"问题,一个让AI Agent不再失忆。
pdf-inspector
你的PDF解析器,在扫描件上翻车了吗?
📌 说个真实痛点
你有没有遇到过这种情况——RAG系统跑得好好的,喂进去一批PDF,一半内容直接乱码。
仔细一看,那批PDF里混着扫描件。你的文本提取器对着扫描图片一顿猛输出,拿到一堆空字符串或者乱码字符。然后embedding出来的向量全是噪声,检索质量断崖式下跌。
更烦的是,你分不清哪些PDF需要走OCR、哪些直接提取就行。全走OCR?慢且贵。全走文本提取?遇到扫描件就翻车。
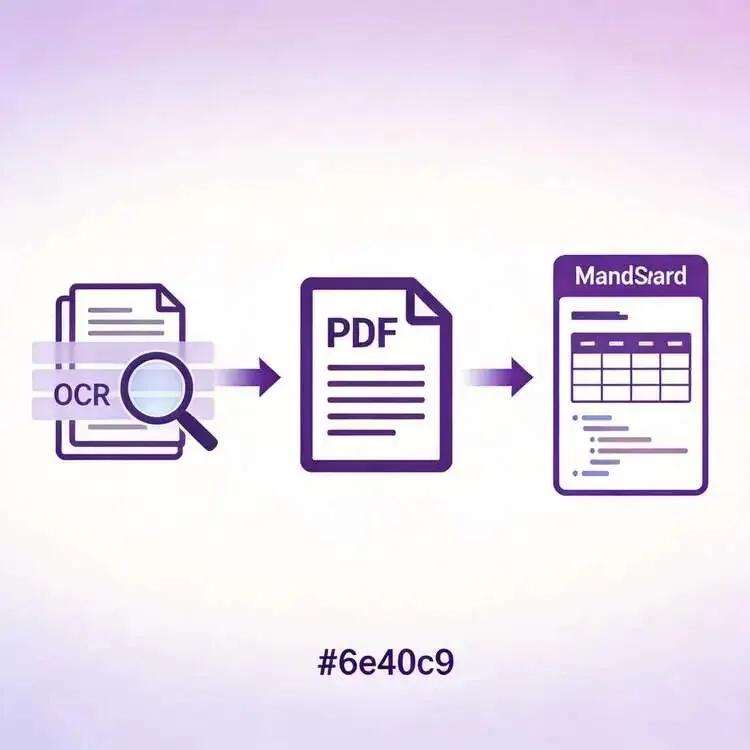
pdf-inspector 就是来解决这个"路由问题"的。
🔧 它做了什么
FireCrawl团队用Rust写了这个库,核心能力三个字:分、提、转。
📂 分:10-50ms内判断PDF类型——纯文字版/扫描件/图片版/混合型,带置信度评分
📝 提:位置感知的文本提取,自带字体信息、XY坐标、自动多栏阅读顺序
🔄 转:输出干净的Markdown——标题层级、列表、代码块、表格、粗斜体全保留
关键设计:一次加载,按需路由。文档只解析一次,文字页直接提取(200ms以内),只有扫描页才走本地OCR(PP-OCRv6)。约54%不需要OCR的PDF直接秒出结果。
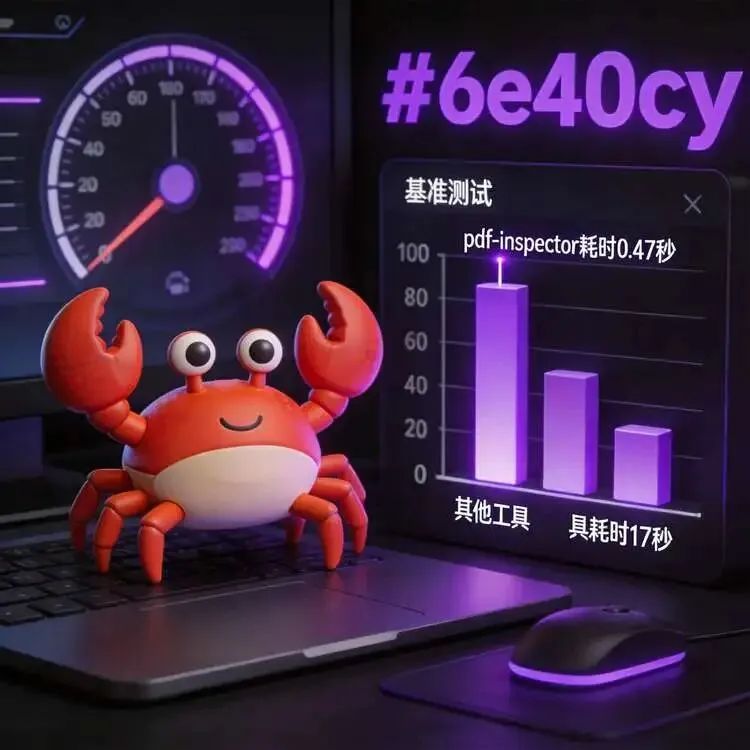
📊 性能数据
数据来源:opendataloader-bench,200份PDF,Apple M4 Pro
💰 开源 vs 闭源:花多少钱才能做到?
闭源方案
• Adobe PDF SDK:企业授权 $数千/年起
• ABBYY FineReader:$200+/用户/年
• Amazon Textract:$1.5/千页
pdf-inspector
✅ 完全免费 · MIT协议 · 本地运行 · 零数据上传
🚀 三行代码上手
pip install pdf-inspector
import pdf_inspector
result = pdf_inspector.process_pdf("doc.pdf")
print(result.pdf_type) # text_based / scanned / mixed
print(result.markdown) # 干净的Markdown
适合谁:做RAG的、做文档处理的、做数据管道的。只要你的系统需要吃PDF,就值得集成。
TencentDB-Agent-Memory
给AI Agent一个真正的大脑
📌 Agent最大的问题是"失忆"
每次开新对话,之前聊过的全部清零。你跟它说了项目技术栈是React+TypeScript,下次还要再说一遍。你让它排查过一个Bug,搞清楚了根因,下次遇到类似问题它又得从头摸索。
你团队里有5个人各自用Agent,同样的问题解决5遍。
TencentDB Agent Memory —— 腾讯开源的团队级Agent记忆管理中心。
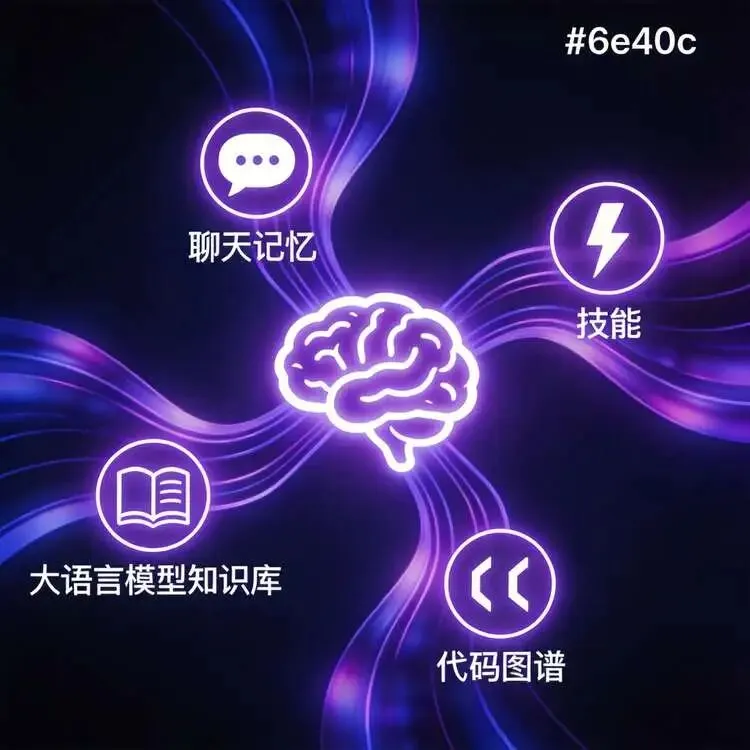
🧠 四种记忆资产
💬 Chat Memory
对话记忆。L0原始对话→L1原子事实→L2场景知识→L3用户画像,逐层沉淀。
⚡ Skill
技能库。一次排障/Review跑通后提炼为可复用技能。有版本、有触发条件、有执行步骤。
📖 LLM-Wiki
知识维基。受Karpathy启发,文档自动整理成Agent可检索的结构化知识页面。
🔗 Code-Graph
代码图谱。索引符号、调用关系、影响路径。改代码前能做impact analysis。
🆚 vs 其他方案
🚀 一键部署
git clone https://github.com/Tencent/TencentDB-Agent-Memory.git
cd TencentDB-Agent-Memory/deploy/global-images
cp .env.example .env
# 填入LLM参数
./start-all.sh
把Agent的base URL指向Memory Proxy就行。支持Claude Code、Codex、CodeBuddy、DeepSeek Harness等。
适合谁:团队多人用Agent的、多Agent协作的、想让经验沉淀不丢失的。
📋 本期数据一览
🦍 开源大猩探
每周一期,只推荐真正有用的开源项目。
觉得有用?转发给身边正在踩坑的朋友 🤝