ARTICLE · 994095
AI Agent 的下一场竞争:不是会做什么,而是做过之后学会什么
如果一个 AI Agent 今天帮你完成了一项复杂工作,你花了两个小时纠正它的错误,告诉它什么该做、什么不该做,解释了你的判断标准,最终一起得到了一份不错的结果;
那么第二天,当一个高度相似的任务再次出现时,它会不会做得更好?
这可能是今天讨论 AI Agent 时,一个被严重低估的问题。
过去两年,我们习惯用另一套标准衡量 Agent:
它能不能联网?
能不能操作电脑?
能不能调用更多工具?
能不能访问企业数据库?
能不能写代码、做表格、生成 PPT?
能不能规划几十个步骤,连续工作几个小时?
于是,Agent 的能力边界不断扩大。
模型外面接 RAG,RAG 外面接数据库,数据库外面接几十种 SaaS,再配上一整套 Workflow、MCP、Skills 和浏览器控制能力。
AI 确实越来越“能干”。
但这里存在一个更深层的问题:
它越来越能干,是否意味着它越来越熟练?
这两个问题,其实完全不是一回事。
一、今天很多 Agent,都像“永远第一天上班的员工”
想象一个刚入职的新员工。
第一天,你告诉他公司的报告应该怎么写。
第二天,你指出他的数据引用方式有问题。
第三天,你告诉他领导真正关注的不是表格本身,而是异常数据背后的原因。
第四天,他参加了一次项目复盘,终于理解为什么上一个方案被否掉。
一个月以后,他和刚入职时一定不一样。
真正优秀的员工,并不是因为脑子里装进了更多文件,而是因为他经历过项目、犯过错误、接受过反馈,逐渐形成了判断。
这是人的工作经验。
它大致遵循这样一条链条:
做过事情 → 遇到问题 → 得到反馈 → 形成判断 → 下一次改变行为。
但今天大量 AI Agent 的运行逻辑依然更接近:
接受任务 → 搜索资料 → 调用工具 → 完成任务 → 保存记录 → 结束。
第二天再来一个类似任务,它也许可以搜索到昨天的文件,也许能够调取昨天的聊天记录。
但“找到昨天发生过什么”和“真正从昨天学到了什么”,是两个完全不同的能力。
于是出现了一个有些荒诞的状态:
一个 Agent 可以完成第 100 份报告,却可能仍然像第一次写这份报告。
这才是今天 Agent 真正的瓶颈之一。
二、“记得”并不等于“学会”
这是理解下一代 Agent 最重要的一道分界线。
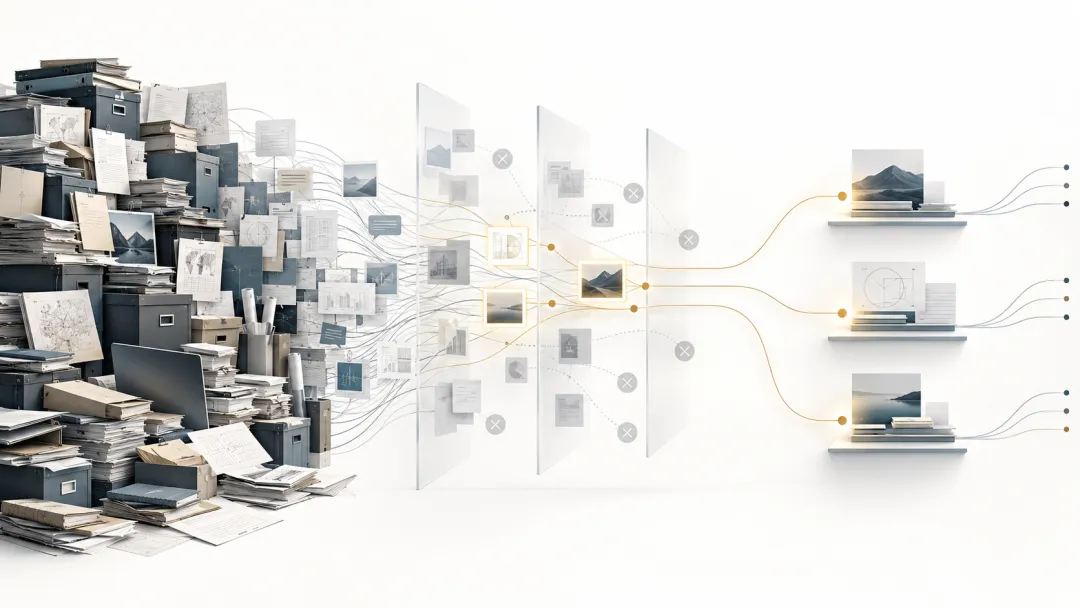
过去几年,我们已经找到很多让 AI“不忘事”的办法。
最简单的是扩大上下文窗口,把更多历史记录直接塞给模型。
再进一步,可以使用 RAG,从海量文件和历史记录里检索与当前问题最相关的信息。
再进一步,则是各种长期记忆系统:把人物、项目、偏好、事件、文件和历史对话持续保存下来,需要的时候再取出来。
这些技术都很重要。
但它们解决的主要还是同一个问题:
让过去的信息,在需要的时候重新变得可见。
而“学习”解决的是另一个问题:
过去发生的事情,能不能改变未来的行为。
举一个很简单的例子。
你曾经告诉 AI:
“我们写报告时不要只罗列问题,要追问问题背后的机制。”
下一次写报告时,如果 AI 能搜索到这句话,这叫记忆。
如果你什么都没提醒,它却主动改变分析框架,开始追问原因、机制和影响,并且在新的项目中仍然保持这一做法,这才更接近学习。
所以:
记忆解决的是‘我以前知道什么’。
学习解决的是‘我以后应该怎么做’。
这也是为什么“把所有历史记录扔进向量数据库”永远不等于真正的经验积累。
学术界事实上也正在发生类似的转向。
2026 年 ACL Findings 的一篇 Agent Memory 综述,把这一领域的发展概括为三个阶段:
Storage → Reflection → Experience
也就是:
存储轨迹 → 反思轨迹 → 抽象经验。
研究的重点正在从“怎样把历史保存下来”,进一步走向“怎样从历史中提炼能够迁移到未来任务的经验”。
这可能比单纯把上下文窗口从 128K 扩展到 1M、10M 更重要。
三、真正稀缺的不是“工作记录”,而是工作中的因果关系
为什么这件事重要?
因为一项专业工作的价值,从来不只存在于最终交付的那份文件里。
真正有价值的东西,往往藏在过程之中。
客户最开始提出了什么要求。
项目中途发生过什么变化。
为什么原来的方案突然被推翻。
专家当时为什么坚持某个判断。
哪个方案看起来最好,却因为某个隐性约束最终被否决。
领导修改了一句话,背后真正介意的是什么。
一次事故之后,团队为什么永久改变了某项流程。
最终结果到底好不好。
如果只保存最终版本,这些信息绝大多数都会消失。
但恰恰是这些东西,构成了专业人士真正的“经验”。
所以未来 Agent 真正需要理解的,并不是一座静态的企业知识库。
它需要理解的是一个不断变化的系统:
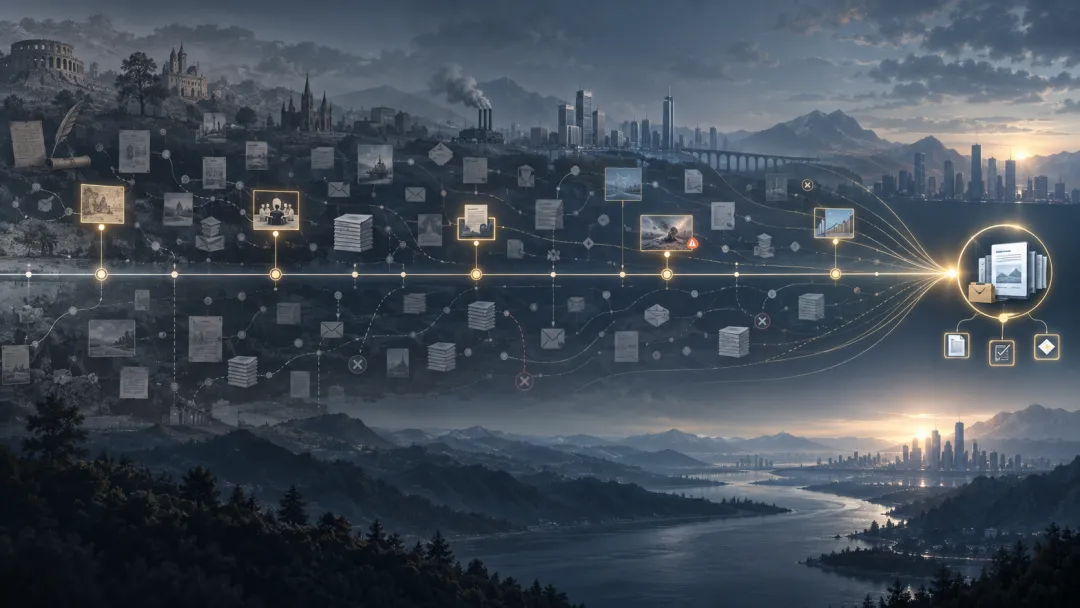
谁,在什么时间,因为哪些信息,做出了什么判断;这个判断带来了什么结果;后来又为什么发生改变。
这已经不再是简单的 Document Search。
它更接近一张动态的“组织经验网络”。
人物、项目、文件、任务、决策、反馈和结果彼此连接,而且具有时间关系。
一条信息不仅要知道“它是什么”,还必须知道:
它什么时候是真的。
因为企业世界里最危险的问题,往往不是 AI 找不到信息,而是:
AI 找到了一条已经过期的信息。
例如:
三个月前,某项目负责人是 A。
今天已经变成 B。
一年前,公司允许某种流程。
半年后,因为一次事故,这项流程已经被取消。
如果 AI 只会做语义相似度检索,那么这些内容可能同时被找到。
真正困难的是判断:
今天应该相信哪一个?
这也是长期记忆系统开始引入时间有效性、知识更新和事实替代关系的原因。例如 OpenContext 公开的架构中,就明确使用具有时间有效区间的上下文图来处理事实被更新、替代的问题。
这意味着 Agent Memory 正在从“档案馆”,逐渐变成“历史理解系统”。
四、上下文再长,也不等于真正理解长期工作
很多人会自然想到:
那把上下文做得足够长不就可以了吗?
问题没有这么简单。
真实专业工作不是一次 100 万 Token 的长对话。
而可能是一项持续两年的项目。
期间经历:
几十次会议,
几百份文件,
大量微信、邮件和即时通信,
多轮方案修改,
人员变动,
政策变化,
专家意见,
现场调查,
失败方案,
最终决策。
更困难的是:
真正决定今天这个任务应该怎么做的信息,可能只出现在九个月前一场会议中的一句话里。
2026 年发布的 LongMemEval-V2,已经开始把 Agent 的长期记忆放到更接近这种环境中测试:历史不再只是聊天记录,而是多次 Web Agent 工作轨迹;单个测试环境的历史规模可以达到数千万甚至超过一亿 Token。
这其实说明了一个趋势:
长期工作的核心问题,已经不只是 Context Window 有多长。
真正的问题是:
面对如此庞大的历史,AI 能否知道什么值得记住?
哪些已经失效?
哪些只是偶然事件?
哪些是一条可以复用的经验?
哪些失败值得下一次主动避免?
因此,“无限上下文”并不是最终答案。
就像一个人在公司工作十年,他不可能每天上班前把过去十年的聊天记录重新阅读一遍。
人真正依靠的是已经被压缩、抽象和内化的经验。
AI 最终也会面临同样的问题。
五、Agent 真正缺少的,可能是一台“经验编译器”
如果把这个问题继续往下推,会出现一个很有意思的概念。
未来 Agent 可能需要的不只是 Memory System。
而是一套类似于:
Experience Compiler——经验编译器。
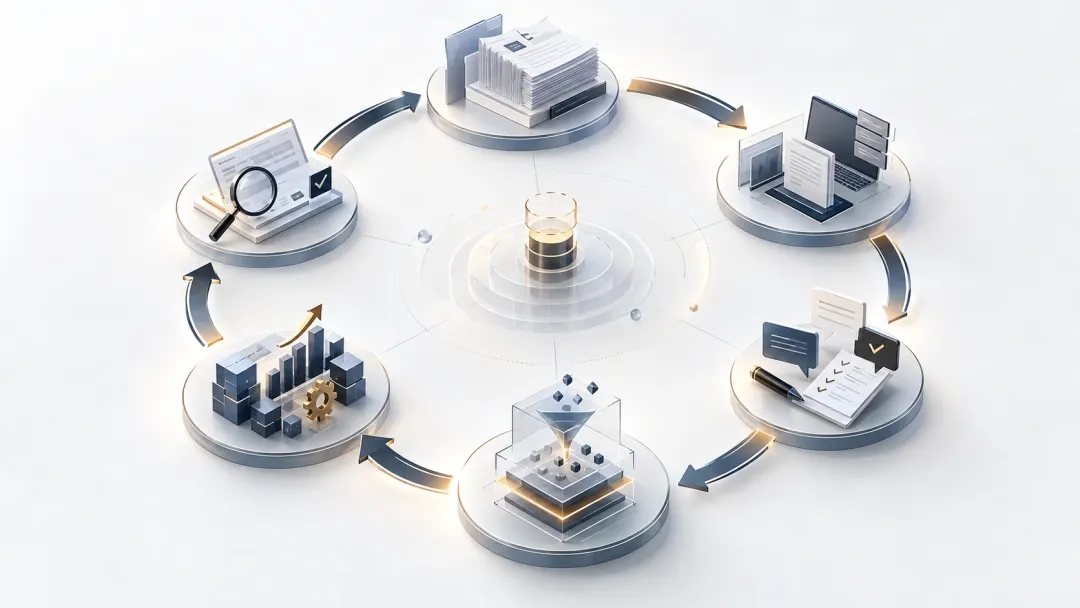
它的任务不是保存所有事情,而是不断把真实工作中的复杂轨迹,编译成未来可以复用的能力。
比如一个 Agent 连续完成了 100 个项目。
真正值得留下来的,不应该是 100 份完整日志。
而应该逐渐形成一些更高层次的东西:
面对什么情况,应该优先检查什么。
出现哪些信号时,某类方案风险很高。
什么情况下应该主动向人询问,而不能自己推断。
哪些错误过去已经出现过。
某个团队真正认可的质量标准是什么。
哪些看似通用的规则,在这个组织里其实并不适用。
它最终沉淀的不是“发生过什么”。
而是:
以后遇到类似问题,应该怎么做。
于是,一条完整的 Agent 成长链路应该变成:
任务轨迹 → 结果反馈 → 经验筛选 → 规律抽象 → 能力更新 → 新任务验证。
而这恰恰是“记忆系统”和“持续学习系统”真正开始连接的地方。
前者回答:
过去发生过什么?
后者回答:
这些过去,应该怎样改变未来?
六、真正有价值的数据,可能不是“企业知识”,而是“企业经验”
如果这个方向成立,它还会带来一个非常重要的产业变化。
过去企业部署 AI 时,最常见的一句话是:
“我们有自己的私有数据。”
于是大家建设知识库、向量数据库、企业 RAG。
但再往前一步会发现:
文档本身未必是最稀缺的资产。
一份行业标准,竞争对手也可以获得。
一份法律法规,全行业都能获得。
一份公开研究报告,所有模型都可以阅读。
真正难以复制的是:
你的组织过去几年究竟经历过什么。
为什么某个项目失败。
某个专家为什么坚持一种方案。
某个客户真正关心什么。
一次事故之后内部制度为什么改变。
哪个判断事后被证明是正确的。
哪些方案曾经尝试过,但已经证明确实走不通。
这些东西不会完整存在于互联网。
甚至不会完整存在于公司的任何一份文档中。
它们散落在会议、邮件、聊天、修改痕迹、审批记录和人的脑海里。
而如果有一天 AI 能够把这些碎片真正组织起来,并逐渐形成可复用的经验,那么一个非常重要的变化就会发生:
企业的历史,开始成为 AI 的能力。
到了那一步,Agent 的竞争方式也会发生改变。
今天我们比较:
谁的模型更强,
谁的工具更多,
谁接入的数据源更多,
谁的 Workflow 更复杂。
未来可能还要增加一个维度:
谁真正工作过。
一个刚部署的 Agent,与一个在同一家公司工作了三年的 Agent,理论上不应该拥有完全相同的能力。
这才符合我们对“员工”的理解。
七、这也可能成为 Agent 最难复制的护城河
模型可以买。
API 可以接。
MCP 可以复制。
Skills 可以下载。
Workflow 可以模仿。
但一个 Agent 在真实环境中积累了三年的高质量工作经验,却很难被瞬间复制。
因为真正的壁垒不再是代码。
而是:
任务 × 决策 × 反馈 × 结果 × 时间。
这些东西共同形成了一套只有在真实工作中才能逐渐积累起来的“经验资产”。
这可能让 Agent 产业出现一种过去 SaaS 很少拥有的特征:
产品使用时间越长,不只是数据越多,而是能力本身可能越来越适配这个组织。
如果这种能力真的能够稳定实现,那么企业更换 Agent 的成本,也将不只是迁移数据库。
而是:
迁移一个已经工作了很多年的“数字员工”的经验。
这可能才是真正值得关注的长期护城河。
八、但“会学习的 Agent”,同样可能比不会学习更危险
当然,这件事不能只看乐观的一面。
因为让 Agent 从历史中学习,也意味着一个非常棘手的问题:
它学到的东西一定是对的吗?
一次成功可能只是偶然。
一个专家的意见可能本身就是错的。
某个项目里的特殊规则,可能并不适用于另一个项目。
一个短期有效的策略,长期来看可能带来更严重的问题。
如果 Agent 把所有工作轨迹无差别吸收,那么所谓“持续学习”,最后完全可能变成:
持续积累错误。
这也是为什么真正可以进入企业生产环境的 Self-Evolving Agent,不能简单理解成:
“AI 每完成一个任务,就偷偷修改一次自己。”
那非常危险。
更合理的机制应该更接近软件版本发布。
真实工作首先产生大量轨迹。
这些轨迹经过质量筛选。
高价值经验由人类专家确认。
随后才进入能力更新。
新版本还必须重新接受固定测试。
只有确认没有能力退化,才能进入生产环境。
出现问题时,还必须能够回滚。
也就是说:
真正成熟的 AI 自进化,反而应该是一件非常克制的事情。
“能学”并不难。
知道什么值得学、学完以后怎样证明自己没有变坏,才是真正困难的部分。
持续学习研究一直面对的“灾难性遗忘”等问题,也意味着 Agent 不仅要获得新能力,还必须避免新经验破坏原有能力。2026 年发表于 IEEE TPAMI 的相关综述,也把持续适应、记忆和抗遗忘视为长期学习 Agent 的核心问题。
九、什么才算真正的“数字员工”?
现在我们可以重新回答一个经常被讨论的问题:
什么时候 AI 才真正算得上“数字员工”?
会发邮件吗?
会做 PPT 吗?
会操作浏览器吗?
会自己调用几十个工具吗?
这些当然重要。
但也许都还不是最关键的标准。
真正的分界线可能非常简单:
它今天做过的工作,会不会让明天的它变得不一样。
一个工具每使用一次,本身不会成长。
Excel 用十年和第一天没有区别。
传统软件被调用一百万次,也不会因为这些调用自动形成新的判断。
但一个真正意义上的员工,会。
如果未来的 Agent 能够在可审计、可评估、可控制、可回滚的前提下,从一次次真实专业工作中逐渐建立自己的经验体系,那么 AI 的形态就会发生非常大的变化。
它不再只是:
一个等待 Prompt 的智能工具。
而开始接近:
一个拥有职业经历的计算系统。
这两者之间的差距,可能远比今天模型排行榜上几个百分点的差距重要。
十、AI 的下一场竞争,也许是“谁经历得更多”
过去几十年,AI 的能力很大程度来自人类已经生产出来的数据。
互联网有多少文本。
代码世界有多少仓库。
论文数据库里有多少知识。
模型就从这些已经存在的人类知识中学习。
但 Agent 时代可能第一次出现另一种数据:
AI 自己参与工作以后产生的经验。
它做过哪些项目。
犯过什么错误。
接受过哪些专家纠正。
采取过哪些方案。
最后结果怎么样。
哪些规律可以跨项目迁移。
这是一种与互联网预训练数据截然不同的数据。
因为它不是关于“这个世界曾经写过什么”。
而是关于:
“我曾经做过什么,以及后来证明什么是对的。”
从这个角度看,最近一些所谓 Self-Evolving Agent 的实验,真正值得看的并不是排行榜本身。
例如 Alloomi 项目方公开报告显示,在保持同一模型 backbone 的情况下,其 CL-Bench 指标由 24.5% 提升到 47.6%。这个数字目前仍主要来自项目方公开材料,不能简单理解为经过大规模第三方复现的结论。真正值得关注的,是它所验证的问题本身:
在模型本体不变的情况下,把真实经验重新组织、筛选并用于后续学习,能不能让同一个 Agent 在后续任务中表现得更好?
如果答案最终被大量真实业务验证,那么 Agent 的竞争逻辑会发生一次非常深刻的变化。
过去我们问:
“这个 AI 知道多少?”
后来我们问:
“这个 AI 能做多少?”
下一阶段,我们可能开始问:
“这个 AI 到底经历过多少?”
以及更加重要的:
“它从这些经历里,真正学会了什么?”
这或许才是“经验”成为 AI 资产的开始。
也许未来真正决定企业 AI 价值的,并不是它是否知道整个互联网。
而是:
它是否真正理解,这个组织过去几年为什么一步一步走到了今天。
当 AI 开始理解这一点的时候,
所谓“数字员工”,才可能真正从一个比喻,变成一种新的生产力形态。