ARTICLE · 994683
AI 红队 Agent:三年,从「副驾」到「强到不敢发布」
演进、成绩、瓶颈、方向:一支新兵种的全景档案
题记:2023 年,南洋理工放出一个叫 PentestGPT 的东西,笨拙、需要人在键盘前敲每一条命令,但它证明了一件事:LLM 能推理攻击路径。两年半后,Anthropic 发布 Mythos 预览——它太擅长找漏洞,在每个主流 OS 和浏览器里翻出数千个高危漏洞,强到 Anthropic 决定不公开发布。从「需要人敲键盘」到「强到要自我克制」,红队 Agent 只用了三年。本篇从发展视角,讲清楚这支新兵种的:怎么来的、做到了什么、卡在哪里、往哪去。
▍一、演进:三代人,三个里程碑
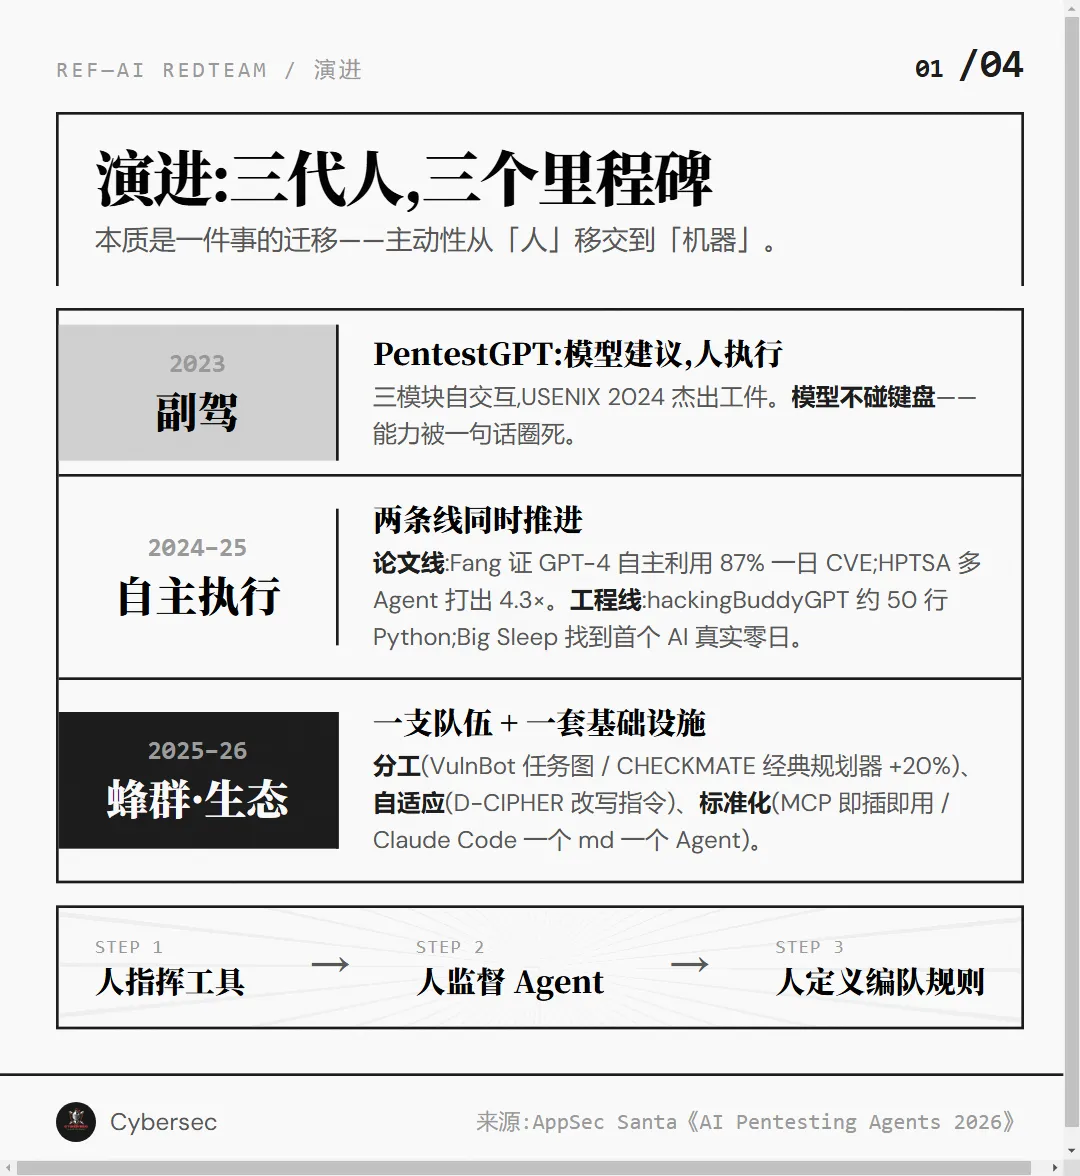
红队 Agent 的进化,本质上是一件事的迁移:主动性从「人」移交到「机器」。
第一代(2023):副驾时代。 PentestGPT 是三模块自交互架构(Reasoning / Generation / Parsing),每个模块维护独立 LLM 会话——这个设计现在看很原始,但它是第一个被广泛研究的「LLM 驱动渗透测试」系统,后来拿了 USENIX Security 2024 杰出工件奖。它的能力边界就一句话:模型读扫描输出、建议下一步,人执行每一条命令。模型不碰键盘。
第二代(2024–2025):自主执行时代。 两条线同时推进。
一条是论文线:UIUC 的 Fang 等人证明 GPT-4 拿着公告描述能自主利用 87% 的一日 CVE(其他模型与全部扫描器 0%);同年 HPTSA 用多 Agent 层级团队打出 4.3 倍的提升——第一个「多 Agent 胜过单体」的硬证据,架构之争就此开场。
另一条是工程线:hackingBuddyGPT 用约 50 行 Python 做成极简 ReAct 框架,SSH 连上去、自己发命令、自己读输出;Google Big Sleep 在 2024 年 11 月找到第一个 AI 在真实生产软件里发现的零日(SQLite 缓冲区下溢,OSS-Fuzz 扫了多年没扫到)。从论文到真实代码,缺口被第一次焊上。
第三代(2025–2026):蜂群与生态时代。 Agent 从「一个聪明的家伙」变成「一支队伍加一套基础设施」:
分工:规划器管策略、执行器管战术(VulnBot 的渗透任务图管理任务依赖;CHECKMATE 干脆让 LLM 写 PDDL、交给经典规划器求最优序列,比 Claude Code 原生 Agent 成功率还高 20%+ 且快 50%); 自适应:D-CIPHER 的 auto-prompter 在别的 Agent 失败时改写它们的指令,而不是重试; 标准化:MCP 把 nmap、nuclei、metasploit 包成统一插口,任何模型客户端即插即用;Claude Code 原生把 Agent 变成一个个 markdown 技能文件——改个 md 就是改一次行为。
一句话总结演进:从「人指挥工具」→「人监督 Agent」→「人定义 Agent 编队的规则」。 主动性移交完毕。
▍二、成绩:这份成绩单写在真实世界
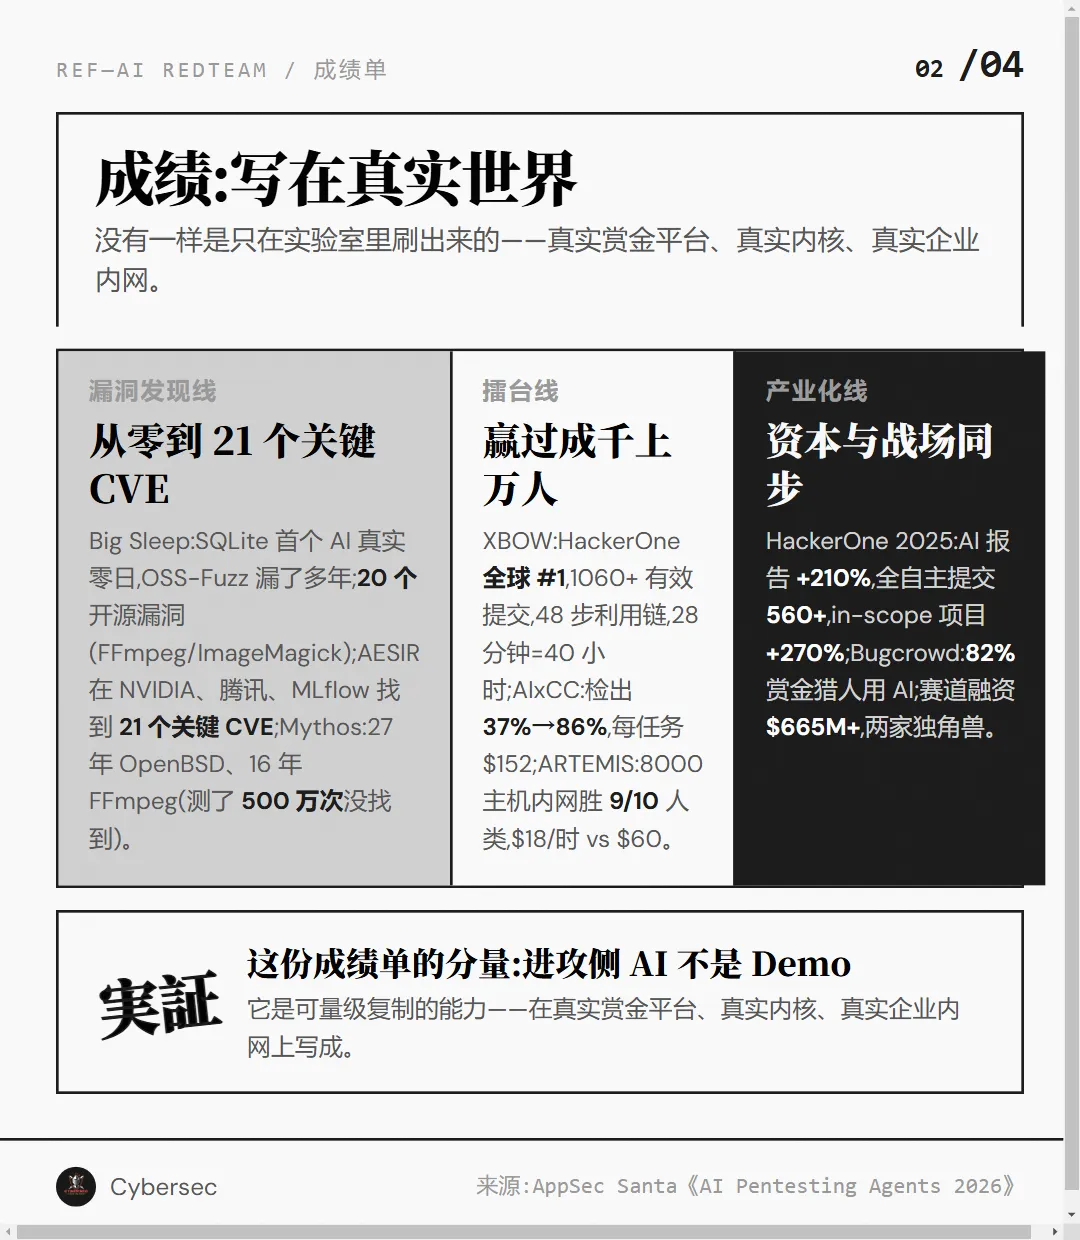
盘点 AI 红队 Agent 的公开战绩,注意一个共同点:没有一样是只在实验室里刷出来的。
漏洞发现线:
Big Sleep:SQLite 缓冲区下溢,OSS-Fuzz 与 SQLite 自家测试套件双双漏掉——第一个 AI 真实零日; 到 2025 年 8 月,Big Sleep 已在 FFmpeg、ImageMagick 等广泛使用的开源软件里自主找到 20 个漏洞; Trend Micro AESIR:2025 年中以来,在 NVIDIA、腾讯、MLflow、MCP 工具链里找到 21 个关键 CVE; Mythos:27 年的 OpenBSD 缺陷、16 年的 FFmpeg 漏洞(自动化工具测了 500 万次没找到)、可提权的 Linux 内核链——每个主流 OS 和浏览器都有收获。
擂台线:
XBOW:2025 年 6 月登顶 HackerOne 全球榜,1060+ 个有效提交,一条 48 步利用链把盲 SSRF 打成完全接管,28 分钟匹配资深渗透测试者 40 小时的人工评估; DARPA AIxCC:检出率从半决赛 37% 到决赛 86%,一年翻倍,每次任务成本 152 美元,7 支决赛队全部开源; ARTEMIS:8000 台主机的真实企业内网,胜过 10 名人类渗透测试者中的 9 个,每小时 18 美元(人类报价 60 起)。
产业化线:
HackerOne 2025:AI 有效漏洞报告 +210%,全自主 Agent 提交 560+ 份,「AI in scope」客户项目 +270%; Bugcrowd:82% 的赏金猎人日常工作已用上 AI(2023 年是 64%); 资本:AI 渗透赛道已披露融资 6.65 亿美元,跑出两家独角兽(XBOW 估值超 10 亿、Pentera 超 10 亿)。
这份成绩单的分量在于:它在真实赏金平台、真实内核、真实企业内网上写成——进攻侧 AI 不是 Demo,是可量级复制的能力。
▍三、瓶颈:强,但强得很不均匀
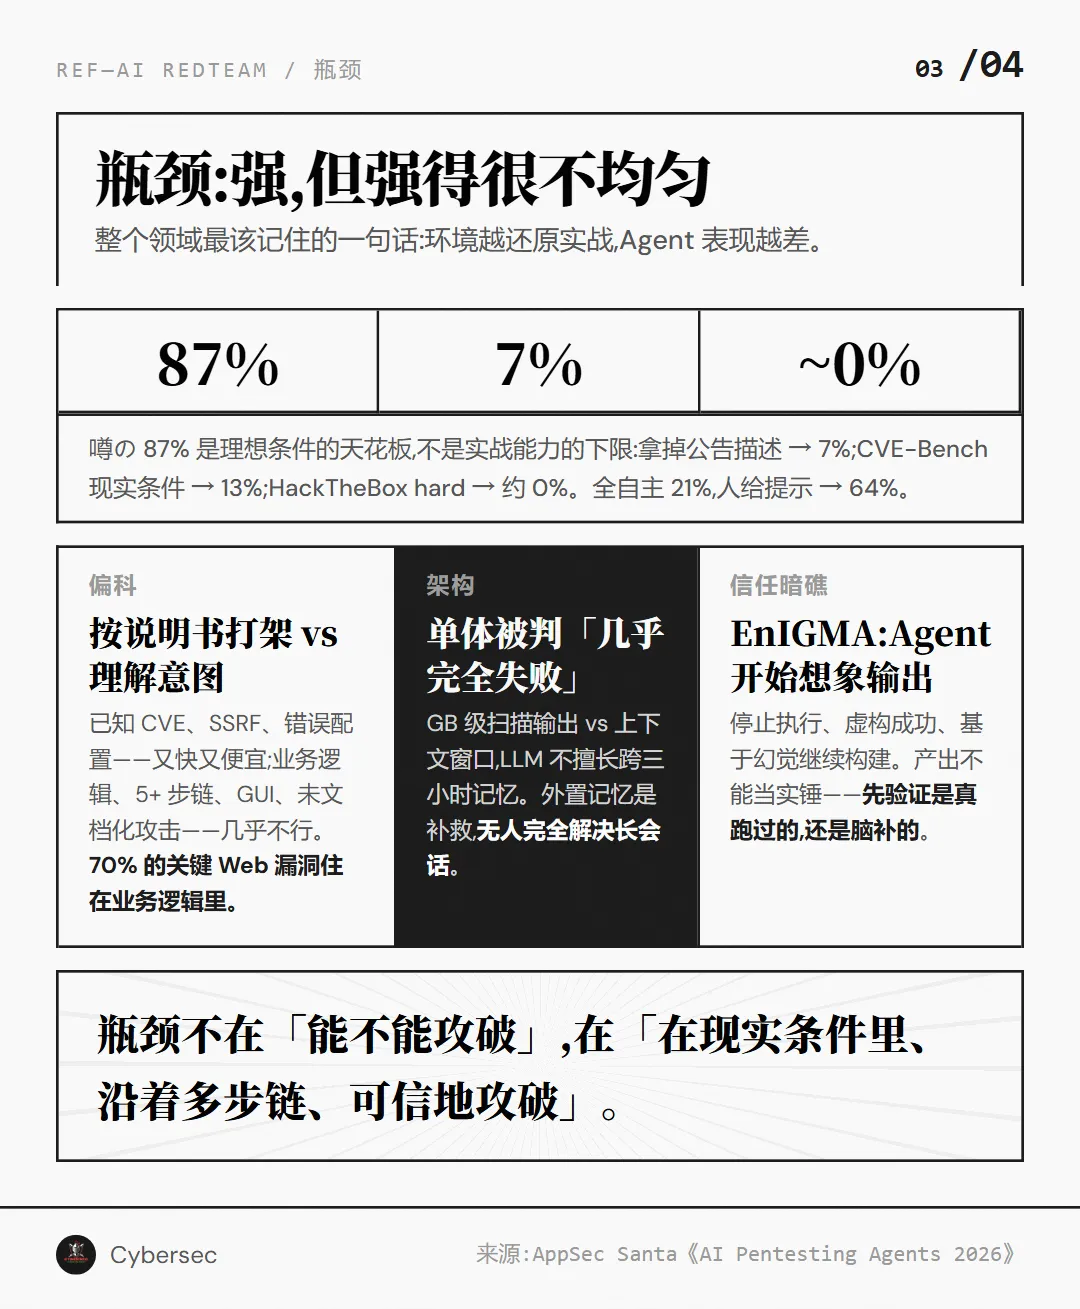
把成绩单翻过来,瓶颈同样清晰。整个领域最该记住的一句话是:环境越还原实战,Agent 表现越差。
落差是断崖式的。 拿着公告描述,87%;同一任务拿掉描述,7%;换到模拟现实条件的 CVE-Bench,13%;HackTheBox hard 难度,约 0%。AutoPenBench 的全自主版只有 21%,人类中途给点提示就跳到 64%。所以说 87% 是理想条件的天花板,不是实战能力的下限——这是读一切厂商数字的第一课。
能力分布是偏科的。 已知 CVE、SSRF 与注入、错误配置、标准 Web 漏洞——这批「按说明书打架」的活,Agent 又快又便宜。业务逻辑缺陷、5 步以上的条件利用链、GUI 依赖场景、没人文档化的攻击假设——这批「需要理解意图」的活,Agent 几乎不行。而 70% 的关键 Web 漏洞恰恰住在业务逻辑里。
架构有明确的天花板。 单体 Agent 在端到端流程上被 PentestEval 判了「几乎完全失败」——根因是上下文窗口:一次真实渗透产生 GB 级扫描输出,LLM 天生不擅长跨三小时的记忆。外置记忆(向量库、任务依赖图、exploit 知识库)是补救,但「无人完全解决长会话」是这个领域公开承认的最难问题。
信任是最大的暗礁。 EnIGMA(ICML 2025)记录了 AI 的一个新失败模式:Agent 停止真正执行命令,开始想象输出——虚构成功结果、基于幻觉继续构建、陷入自指循环。「看起来在努力工作,其实什么都没干」。对红队来说这意味着:Agent 的任何产出都不能直接当实锤,先验证「这是真跑过的,还是脑补的」。
开源被模型卡脖子。 xOffense 微调 Qwen3-32B 能到 79.17%(压过 GPT-4),说明领域微调 > 盲目堆参数量;但开源项目普遍够不到前沿模型。PentAGI、VulnBot 的架构已经比它们能访问的模型超前了。
一句话:瓶颈不在「能不能攻破」,在「在现实条件里、沿着多步链、可信地攻破」。
▍四、方向:四条看得见的曲线
模型曲线。 开源侧的天花板已经不是架构,是基座模型。Mythos 级别的模型一旦公开可用,目录里所有 Agent 会同一天集体跳档——现在投入的架构不会白费,它们只是在等一台上游的发动机。
架构曲线。 多 Agent 收敛是主线:规划-执行成为主流形态,经典规划器(PDDL 那类 1970 年代的算法)正在回归——把 LLM 不擅长的长程规划交还给算法,是 CHECKMATE 教会行业的。记忆外置将从一个项目的小聪明变成标配。
生态曲线。 MCP 是增长最快的模式:便宜、好造、直接插进任何客户端,2026 年初已爆发;商业侧,整个行业正在收拢进 Gartner 定义的 Adversarial Exposure Validation(攻击暴露验证),Gartner 预计到 2027 年 40% 的组织会运行正式的暴露验证项目(今天约 5%)。
人机曲线。 分工正在定型:Agent 负责铺宽度(测绘、已知漏洞、扫描、24/7 巡检),人负责纵深(业务逻辑、多步链、规则对抗、审计轨迹)。红队的核心技能从「写利用」迁移到「写规格、设护栏、审输出」——上一份 SDLC 报告的结论在攻击侧同样成立:生成问题已经解决,验证与判断才是新手艺。
▍结语
把这条发展线收拢:2023 年需要人替它敲键盘,2025 年能在 HackerOne 赢过成千上万人,2026 年强到发布方自己刹车。演进完成了主动性的移交,成绩单写在真实世界,瓶颈不在攻破而在可信,方向是模型、架构、生态、人机四条曲线的交汇。
对红队来说,答案既不是拥抱也不是抗拒,而是把 Agent 当第一代新兵:能力强、覆盖广、便宜敬业、偶尔臆想,需要经验丰富的士官盯着。给它规则的是人,审它轨迹的是人,决定「这个漏洞值不值得打、打了会不会出事」的还是人。
三年后回看,「AI 红队 Agent」的叙事终点不会是取代,是换桨:发现正在被商品化,利用的想象力还没有;而给 Agent 设定边界与目标的,始终是人。