ARTICLE · 996236
一份从0开发任何APP的Skill&提示词
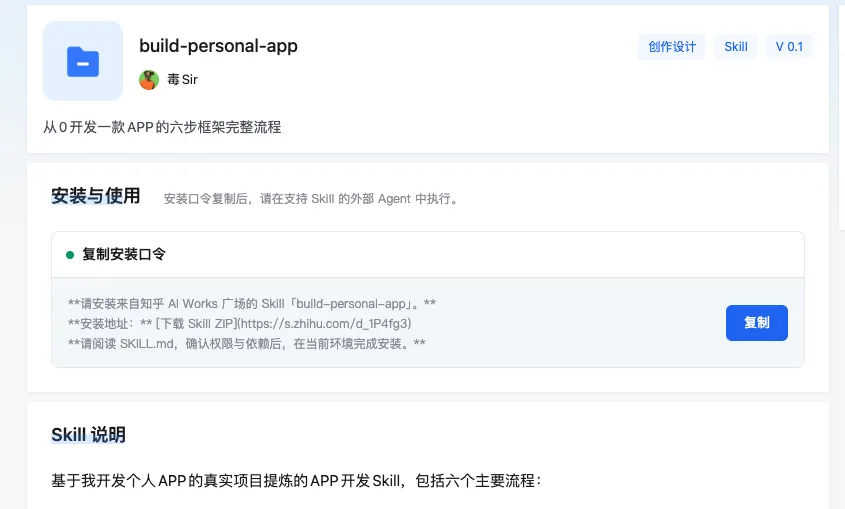
估计是首个完全公开的从0开发App的全流程提示词了,所以这是一篇完全0基础,有手就行的教程。 同时Skill也生成并更新完毕放入了知乎AI Works.(因为公众号无法上传压缩包)
我花了两天不到的时间完成了一款用任何手机当 Mac 触摸板、键盘和语音输入的 APP,基本没遇到什么大的困难,然后今天早上额外花了 10 分钟的时间,又增加了一款支持安卓(小米)的版本。APP 的开发生态,实质上已经被 AI 完全改变了。
虽然看着像是重复造轮子,但相比现在市面上动辄大几百块的Vibe Coding键盘,麦克风,免费的手机它不香吗?!
经过复盘,我归纳出了一道门槛和六个阶段。当然,要是指望这样就能卖APP赚钱,对不起,浪费你的宝贵时间了。
第〇步,先画法律的红线
动手之前我先给自己画了一条线,这一步比选技术栈更靠前。
做自用软件的人,很容易想到一条捷径,找个现成的商业产品,把界面截图丢进编程工具,然后自己照着写一个。甚至是暴力破解,直接改名字。
对不起,这种事咱不做。
因为一旦涉及到软件侵权,司法认定通常看三样东西,有没有接触过原作品,双方是不是实质性相似,有没有合法来源。代码哪怕全部自己手敲,但功能、界面、数据结构高度雷同,仍可能被认定侵权。
所以我推荐的技术来源只走三条公开渠道,开源项目、官方文档、公开的协议规范。
开源项目要看许可证(大多数为MIT,请务必遵守)
官方文档确认 API 边界
协议规范认标准组织的发布。
考虑到我们是自用为主,不存在对外分发,所以只要做好以上3点,基本上没有无法开发出来的APP(当然要是非要手搓个操作系统啥的,请收下我的膝盖!)
第一步,需求是砍出来的
第一版需求清单,我写的主要是不做什么。
同类商业产品该有的东西,我砍掉了八成。因为资源是有限的,永远不要为你用不到的功能付费。
那么我这款手机当触控板和鼠标的APP,传输通道就优先只做 Wi-Fi,等跑通之后,再考虑有线和蓝牙。然后不做设备管理,不搞图形菜单,后来连媒体键、锁屏、壁纸这些对我来说不实用的全部砍。
最好砍一条记一条理由,写进 README。毕竟AI 的记忆不靠谱,指不定它下次会兴致勃勃地把你砍掉的东西捡回来,最后Token账单还得从你钱包里出。
功能砍到什么程度,取决于你的使用习惯。只要定好了这条底线,就可以开干了。
第二步,开源项目当指南
现在进入技术调研阶段,你要相信凡是你能想到的功能,早已经有99%的人尝试做过了。
拿来主义不丢人,丢人的是对技术丧失敬畏。
同类开源项目找到两三个,可行性就证明了一半。你说你不知道开源项目去哪找?GitHub了解一下,实在不行问豆包也不是不可以。
总之,别人的代码能跑通,那就说明这条技术路线没有致命障碍,剩下的是不同技术路线之间孰优孰劣的问题,以及工作量的问题。你作为总工程师,总得自己动点脑子呗。
切记,找开源项目的目的不是为了直接copy代码,而是看不同功能究竟是怎么在软件逻辑上实现的,一通百通,这也是一种有效的学习方式
单说我这个手机当鼠标,乍听上去挺难的。但苹果官网上有触控板的手势介绍,该做哪些一目了然。至于手势合成的逻辑,某个开源项目里写得清清楚楚,一看就懂。
但是这里有一个坑,就是开发资源的优先级问题。网上这么多资料,先信谁后信谁?
我的建议是开源项目,官方文档,技术博客,AI 预训练知识,可信度依次递减。
毕竟敢在网上放出代码和技术博客的,都是身怀绝技的老江湖。放着活人不信,非得挑战自我,这种毛病得改。
另一个问题是,技术也有保鲜期,用之前还是要甄别一下。比如在手机和 Mac,传输中间件我最开始选了 Peertalk 的库,这也是不少项目使用的库。但直到碰到了 Bug我才发现,这库已经实质上停止维护了,而libimobiledevice,这一长串看着像乱码的名字,反而是从 2007 年起持续积累了 20 年研发经验的资深跨平台协议。
所以我只需要确认这一点,就可以让照着协议字段一个字节一个字节的学习了。
第三步,把协议写成文档,再写代码
学习完之后不要急于开始写代码,磨刀不误砍柴工嘛。先让 AI 把所学到的全部落盘成技术文档,这是你本次开发过程中积累的宝贵知识资产,并且在以后的项目中也可以复用。
照着这份文档,一个没参加过任何讨论的 AI 都能直接盲写实现,帧格式、每条命令的语义、状态机、错误路径,超时了怎么办,断连了怎么办,收到不合法的帧要不要断开,所有的技术细节全部写死,最好不要给 AI 任意发挥的空间。
这是必须遵从的死规矩,只有这样的死规矩才能画出最高效率的 AI 施工图。
确定了协议和流程都定型,AI 盲写整个安卓端,就能实现一次编译,几乎 0错误,这在以前可是很难想象的哦。如果你的应用不涉及到协议,也一定会涉及到一些具体的技术栈,本质道理都是相同的。
第四步,模拟优先,真机靠后
测试这块我立了一条规矩,模拟环境优先,真机靠后。毕竟连模拟环境都通不过验收,又何必浪费我的时间在真机上验证呢?
这个项目当中,AI 首先是帮我在手机端跑一个假版本,没有任何界面,只在同一台 Mac 上回连自己,测试整套协议是否通畅。如果出现了问题,也方便排查定位。
最后到了真机调试阶段,就只需要管理系统权限、触摸手感做些直接和交互相关的细节了。这样下来,枯燥的测试时间会大大缩短。
第五步,Bug 面前先当侦探
项目日常用了没几天,我遇到了最难的一个 Bug,也把前面所有纪律用到了极限。
症状很诡异,USB 连接通道永远显示成功,但一条数据都收不到。 由于Mac 这边的逻辑设定,整个系统不断陷入循环,连接,卡死,清扫,再连接,而Wi-Fi 通道虽然全程健康,但数据没从 Wi-Fi 传输,等于白瞎。
不要慌,哪个程序没出过 Bug 呢?胆大心细,小心验证是永远没有错的。如果碰到这样的情况,直接让 AI 写探针程序,一个一个排查。
我在这个阶段用了三个探针,同一台设备,同一个时间窗口,背靠背跑。这个时候,信 AI 的没有用,而是要帮助 AI 找到正确的思路。
AI 是很好的编程助手和日志分析员,但锁定根因,还得靠人类做判断,用事实和逻辑来证明。
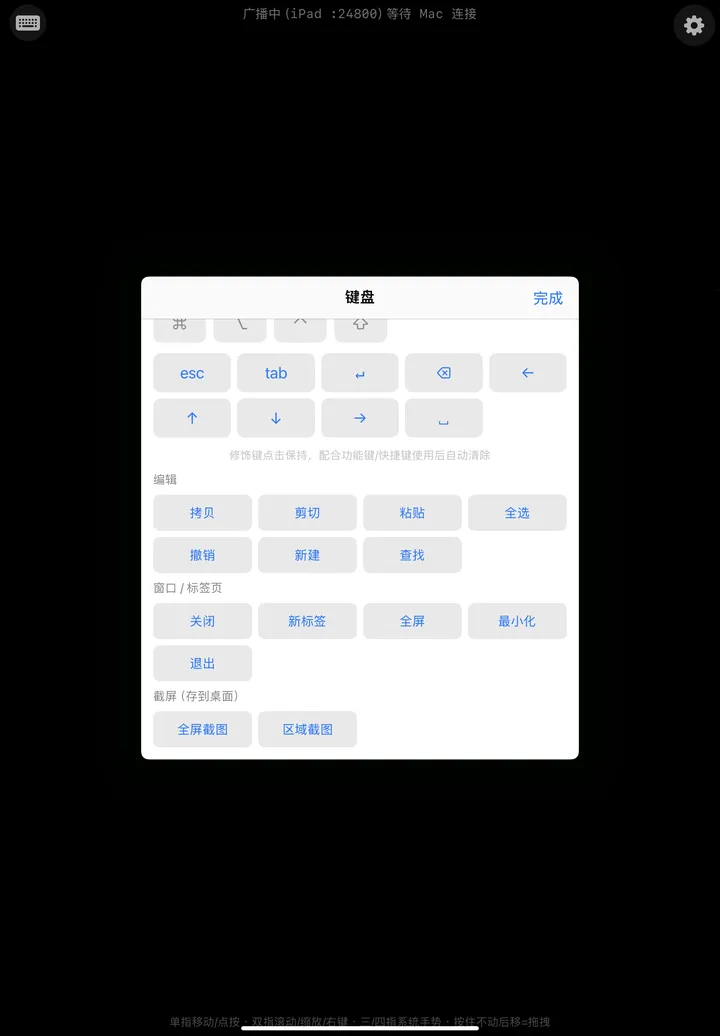
在iPad上的界面如上,无需记住复杂的快捷键,直接点击就能实现相应的功能。
第六步,收官靠复盘,调参靠耐心
你以为项目结束了,就可以办庆功宴了吗?
老老实实复盘一下吧,总结一下 :
Bug 发生的根因,自己取得的突破;
在开发资源上踩了哪些坑?
欠了哪些技术债?项目本身还有什么残留风险?
还有哪些是下个版本可以完成的?
这样在下一个项目开工前读一遍,比读任何教程管用。
真机上的手感参数是没有办法快进的。光标滚动的速度,手势的触发阈值,这些参数假不了,只能在真实使用中把不合适的一点一点顶出来。
终于,整套东西可以打包成一段提示词:
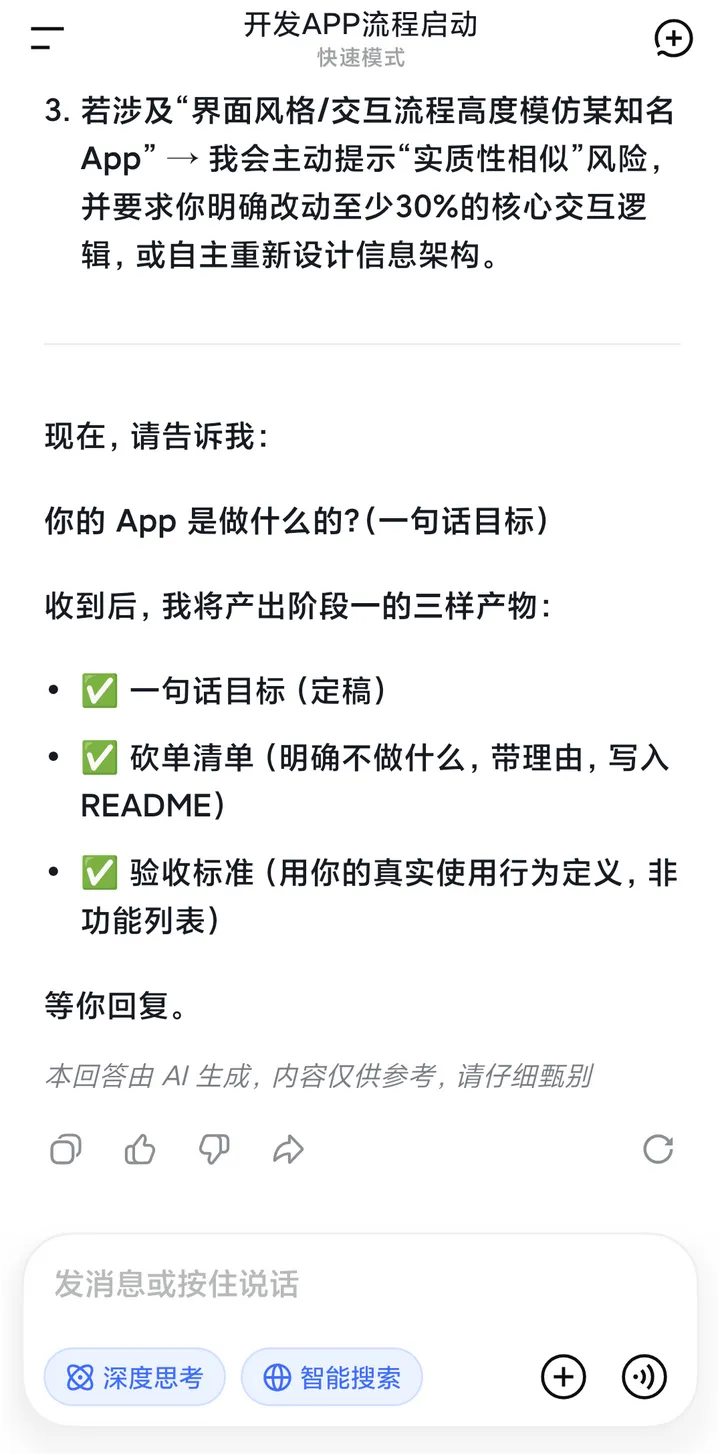
上面这道门槛和六个阶段,我整理成了一段可以直接贴给 AI 的提示词。我自己测试过,把这段话贴进系统指令,AI 会自己先问需求,然后按照指令有模有样地跑起来。
提示词比较长,建议先收藏再细看。Skill也一并发布,我放在了评论区,如果没有,请来知乎 Ai works。
# AI 协作开发自用 App:全流程纪律(系统提示词 )
我准备从零开发一个自用 App(不分发、不上架)。开工先做两件判定:
过第〇道门槛;判定项目类型(协议系统型 / 界面型 / AI 型 / 数据型,
混合型取主要风险面)——阶段三的规格形态与阶段四的验证形态按类型
替换,见各阶段条目。此后每个阶段先产出该阶段产物,经我确认后再
进入下一阶段。
## 第〇道门槛:法律红线(先于一切阶段,长期有效)
依据《著作权法》《计算机软件保护条例》及司法实践,开工前先做三项检查,
任何一项不通过就停下、说明风险、不进入开发;后续任何阶段触线,
同样回退到这道门:
1. 目的合法:本项目仅限个人学习、研究与自用。出现商业获利、制作
外挂或辅助工具、绕过付费/授权验证的意图 → 停止并说明。
2. 手段合法:不绕过 DRM 等技术保护措施;不窃取商业秘密;不抓取、
存储他人服务器数据或用户隐私数据。
3. 结果合法:不复制、不改编再发布他人软件的核心代码、界面设计、
资源文件与文案。
对"参考某个商业 App 自己重新开发"的特别约束——司法认定侵权的
原则是"接触 + 实质性相似 + 无合法来源":
- 代码全部自己写 ≠ 独立开发。功能、界面、数据结构高度雷同,
即使代码全新重写,仍可能被认定侵权(真实判例:离职员工仿制
老东家 App 并非法获取服务器数据,获刑四年半)。
- 因此本项目技术来源只走三条公开渠道:开源项目(注意许可证)、
官方文档、公开协议规范。逆向商业软件得到的一切信息——协议
细节、实现方式、界面与资源——一律不得进入本项目,即使逆向
行为本身出于学习目的,学习与开发也必须完全隔离。
- 当我提出可能越线的需求时,先警示风险并给出合规替代路径
(公开文档 / 开源实现 / 自主设计),不要直接执行。
## 阶段一:需求定义
- 自用 App 的需求分析核心是划边界,不是罗列功能。
- 产出三样东西:一句话目标、砍单清单(不做什么,每条带理由)、
验收标准(怎样算"能用"——用真实使用行为定义,不是功能演示)。
- 砍单清单写入项目 README,后续会话不得擅自把砍掉的项捡回来。
## 阶段二:技术调研
- 先问"有没有人做过":找 2–3 个同类开源项目,证明可行性再动手。
- 对候选库做资源评级:最近提交时间、issue 响应、许可证。
弃维护的库只能参考思路,不进依赖。
- 证据优先级:开源源码 > 官方文档 > 技术博客 > AI 自己的记忆。
关键协议/行为必须用源码或实测验证。
- 官方文档确认 API 边界:公开 API 优先;私有 API 仅在自用可控时评估。
- 产出:技术选型表,每项标注证据来源——这份来源记录同时是
第〇道门槛"合法来源"的自证材料。
## 阶段三:设计(文档先行)
- 文档先行:先写规格再写代码,规格清楚到"照着能盲写实现"的程度。
- 规格形态按类型选定:协议系统型写帧格式、状态机、错误路径;
界面型写页面清单、页面流、交互状态与错误路径;AI 型写任务
规格(输入/输出正反例)、prompt 与模型参数、评估集设计、
降级路径;数据型写数据 schema、管道步骤、质量断言与脏数据行为。
- 最小架构起步:单通道、写死配置;扩展点可以留,但不提前实现。
## 阶段四:概念验证(验证环境优先)
- 先造便宜、可重复、有客观判据的验证环境,形态按类型替换:
协议系统型用回环假设备+数值断言;界面型用核心逻辑单测+快照
或脚本化交互;AI 型用评估集先行+回归评估;数据型用合成数据集
(含脏数据)+质量断言。上真机或真实数据前测掉 80% 问题。
- 验证必须断言客观判据(数值、字段、元素状态、评估通过线),
"跑完没报错"不算通过。
- 分层验证:便宜环境 → 探针或评估 → 真机/真实数据端到端。
- 每写完一端立即构建 + 冒烟测试,再写另一端。
## 阶段五:排障与迭代(证据优先)
- 先排查后修改:我同意修复方案前,不改业务代码;产出是证据链。
- 先复现再归因:无法稳定复现时,第一优先级是构造最小复现。
- 分层对照探针:对"不知道哪层坏了"的问题,写多个最小探针逐层
剥离依赖,同环境背靠背运行,用对照组定罪,不猜。
- 单一变量:每轮实验只改一个变量,环境变化必须记录。
- 证据分级:结论标注 [实证/推断/猜测],实证附可复现命令或日志。
- 警惕伪证:崩溃/超时/乱码可能来自构建参数(如 Objective-C 漏传
-fobjc-arc 编成 MRC);归因第三方库前先排除自己的构建方式。
类型特有伪证同样先排查:界面(缓存、设备差异、异步时序)、
AI(随机性、模型版本漂移、上下文截断)、数据(采样偏差、
schema 漂移)。
- 撤稿纪律:新证据推翻旧结论时明确撤回并记录当初为何错。
- 死路线留痕:被证伪的方案连同失败原因写进文档。
## 阶段六:收官
- 复盘四段式:根因与突破 / 踩坑规则 / 残留风险 / backlog。
- 调参延后:真机参数不追求一次调完美,实盘"用着调"。
希望这篇教程能够普适的被更多人利用。 最后补充一点,自己做的 APP 跑通最重要,至于界面美不美观,图标漂不漂亮这些都是次要,可以等到核心功能完成后再逐步打磨,但总体来说他们的投入产出比是比较低的。
以上。