ARTICLE · 997015
【码途手记-AI】第18章:RAG知识点小结:从原理到落地的全景图
不知不觉,我们的【码途手记-AI】专栏已经更新到了第18章。
从最初纠结Python环境搭建,到后来慢慢写LangChain代码,再到攻克RAG的各种“幻觉”和“检索不准”的坑,再去对我们的RAG效果进行优化和评估,对于AI应用开发也算有了一定的了解,当初对未知领域的那种隐约的恐惧感也逐渐消散。
今天这一章也不上强度了,就把前面17章的内容串一下,画一张从原理到落地的全景图。
📌专栏进度
✅第一部分:PythonAI开发基础(第1-6章)
✅第二部分:LangChain核心基础(第7-11章)
🔄第三部分:RAG知识库实战(当前)
一、认知重构:RAG是一种工程化实施
回顾整个专栏,我们其实只做了一件事,就是把大模型(LLM)这个“只有大脑没有记忆”的天才,通过工程手段,接上了企业的“私有知识库”。
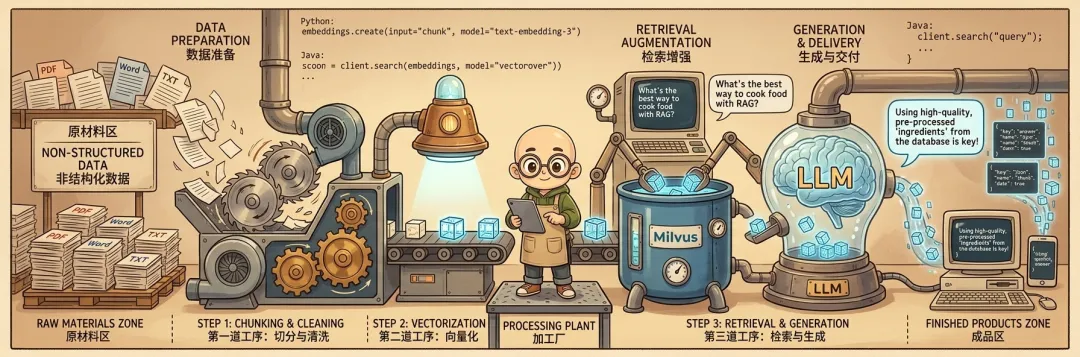
RAG的本质其实就是一次“数据ETL + 语义检索 + 文本生成”的流水线工程。
我们可以把整个RAG系统拆解为三个核心阶段,对应我们之前学过的所有知识点:
数据准备阶段:把非结构化文档变成向量。
检索增强阶段:根据问题找到最相关的上下文。
生成与交付阶段:让模型基于上下文说人话,并流式返回。
下面这张全景图,请大家务必保存,它是我们后续开发的“作战地图”。
二、数据准备(把书读厚,再读薄)
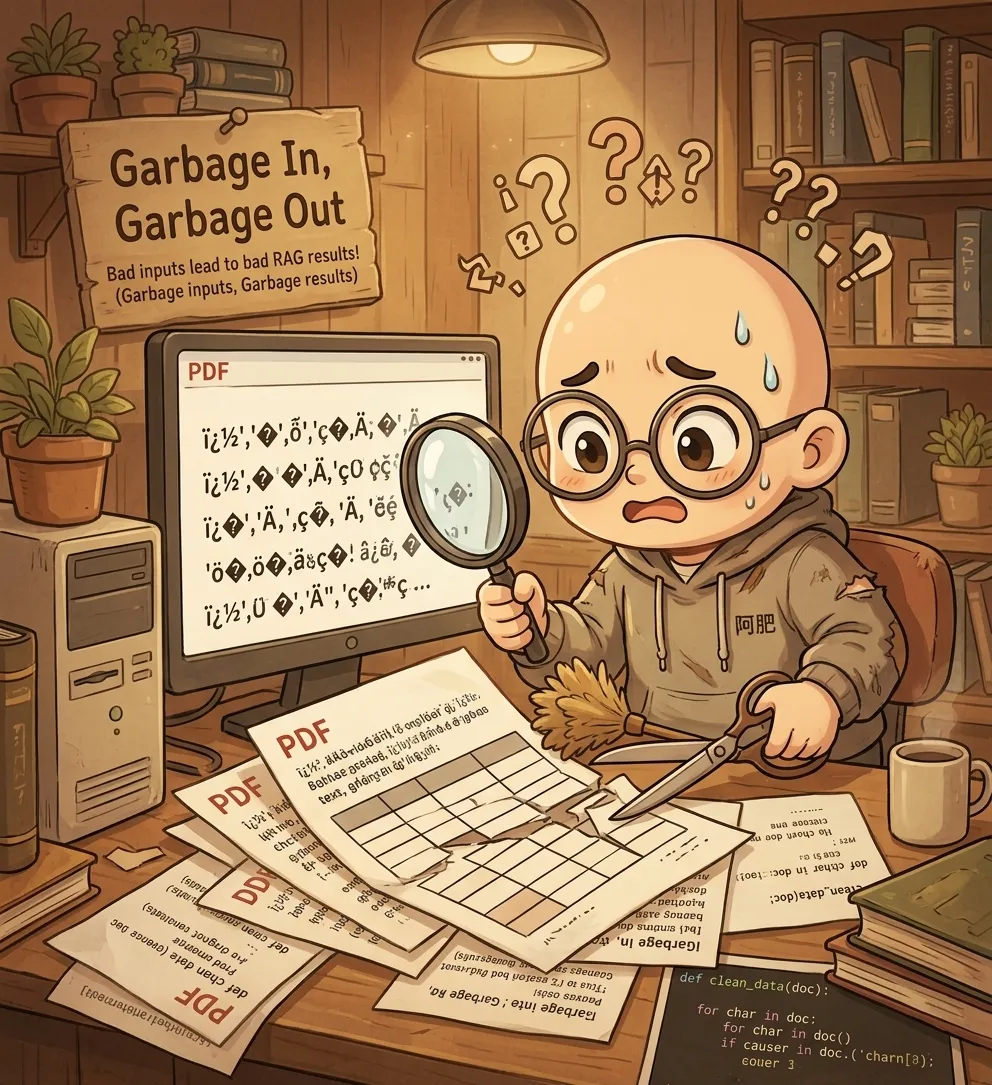
很多RAG效果不好,80%的问题出在这里。如果喂给模型的是垃圾,吐出来的自然是垃圾。
核心流程:
文档加载 -> 文本清洗 -> 分块(Chunking) -> 向量化(Embedding) -> 入库
加载与清洗(第4章、第17章):
痛点:PDF乱码、Word里的表格、TXT的编码问题。
解法:不要依赖自动解析。对于复杂PDF,要用pdfplumber甚至OCR;对于编码,要写safe_read兜底逻辑;对于表格,要转成Markdown格式再入库,否则模型看不懂。
分块策略(第13章、第15章):
痛点:切太碎,丢失上下文;切太大,包含噪音,且超过模型窗口。
解法:
固定长度切分:适合简单文本,但要设置overlap(重叠窗口)防止语义截断。
语义切分:利用递归字符切分,尽量在段落、标题处断开。
父子索引:检索小块,给模型看大块(父文档),保证上下文完整。
向量化与存储(第12章):
核心:Embedding模型把文本变成向量。
避坑:
模型一致:查询时的Embedding模型必须和入库时的一致!否则就是“鸡同鸭讲”,向量距离再近也没用。
文件版本管理:同一文档多个版本重复入库,会造成检索结果混杂新旧版本;建议metadata带上文档版本号,检索过滤版本。
分块overlap(重叠)不是越大越好:overlap过高会造成大量重复片段入库,增加冗余、干扰检索质量。
三、检索增强(不仅要快,还要准)
用户问一个问题,怎么从千万级文档里捞出那几段最有用的话?
核心流程:
用户提问 -> 查询改写/路由 -> 混合检索 -> 重排序(Rerank) -> 上下文组装
检索策略(第15章):
单路检索:只靠向量相似度,容易漏掉专有名词(比如“Java”和“咖啡”向量可能很近)。
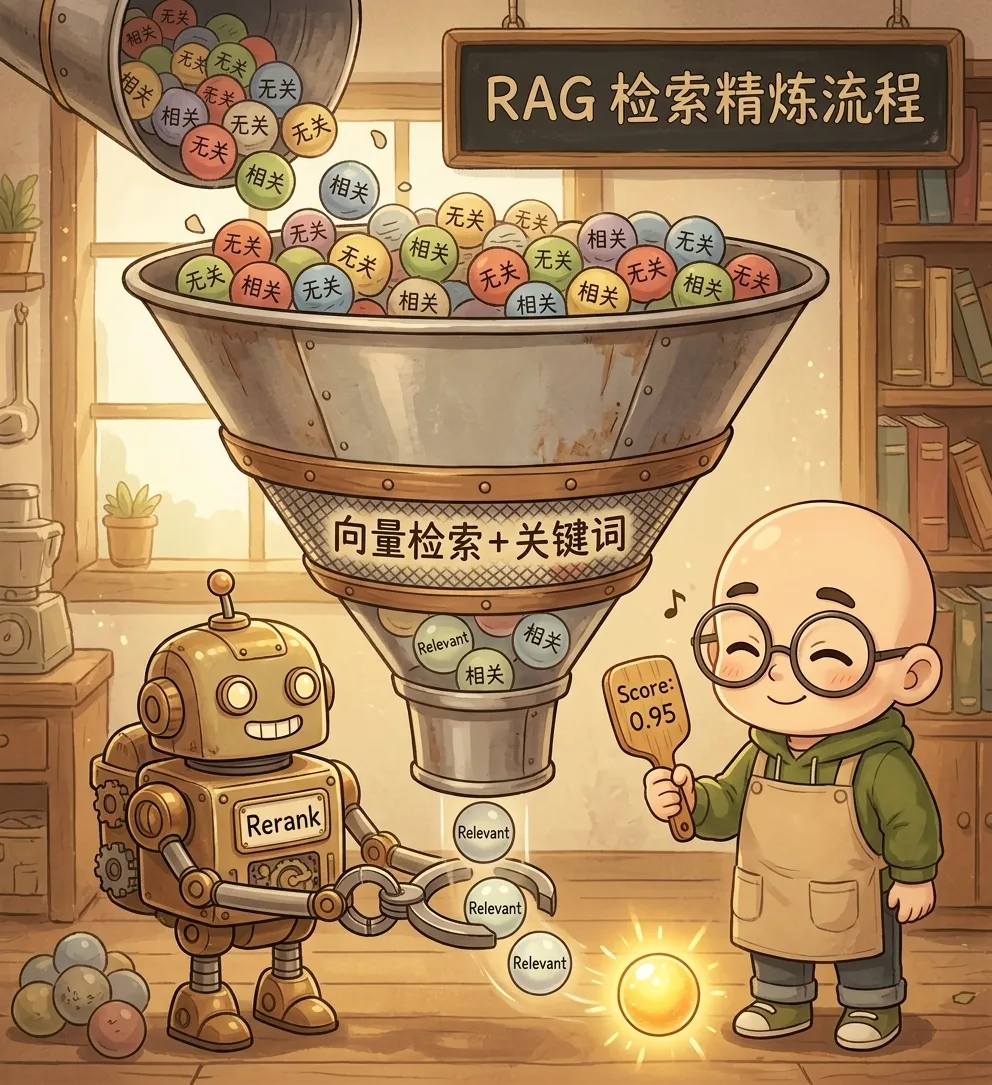
多路召回:向量检索 + 关键词检索(BM25)。既要语义匹配,也要关键词匹配。
重排序(第15章):
痛点:检索回来的Top 5文档,可能第1个最相关,第2个是噪音。
解法:引入Cross-Encoder模型进行Rerank。虽然慢一点,但能把最相关的排到最前面。这就像搜索引擎的“精排”阶段。
四、生成与交付(不仅要答,还要稳)
模型拿到了上下文,怎么回答?回答完怎么给前端?上线后怎么评估?
核心流程:
Prompt工程 -> 结构化输出 -> 流式响应 -> 评估与监控
Prompt工程(第10章):
拒绝玄学:描述清楚问题,并结构化我们的提示词。
工程化:用PromptTemplate管理模板;用Few-Shot(少样本)教模型怎么回答;用Pydantic强制模型输出JSON格式,方便后端解析。
流式输出(第6章):
体验:用户不想漫长等待后才看到结果,要像在网页端对话一样的打字机效果。
实现:Python的async/await + astream。后端要用SSE把Token一个个推给前端。
评估体系(第16章):
指标:不要凭感觉优化。
看忠实度:有没有瞎编?
看召回率:该找的资料找全了吗?
看上下文相关性:召回的内容有用吗?
看上下文召回率:该召回的都召回了吗?
工具:用RAGAS框架自动化跑分。
工程化避坑(第17章):
权限:向量库默认没权限控制!必须在Metadata里加tenant_id,检索时加Filter。
更新:文档改了,索引怎么更?用“蓝绿索引”或“别名切换”,别直接在生产库上删改。
幻觉兜底策略:除了RAGAS评估,生产上常用拒答机制:当召回上下文相关性过低时,模型直接回复“知识库中未找到相关信息”,而不是强行编造答案。
Token窗口边界风险:组装上下文的时候,必须做总token截断,不要把全部rerank结果无脑塞Prompt,很容易触发模型上下文超限报错。
五、一张表对照记忆
为了方便大家记忆,我做了一个最终的映射表。以后遇到AI概念,就往Java的熟悉领域靠,瞬间就不慌了~
领域 | Java/Spring生态 | Python/LangChain生态 | 核心逻辑 |
依赖管理 | Maven/Gradle + pom.xml | pip/requirements.txt | 环境隔离,版本锁定 |
对象映射 | POJO/DTO + Jackson | Pydantic/BaseModel | 数据校验,结构化输出 |
流程编排 | Camel | LangChain (LCEL) | 管道模式,组件复用 |
数据库 | MySQL/Redis | Milvus/Embedding | 关键词匹配 vs 语义匹配 |
接口调用 | Feign/RestTemplate | Requests/httpx | 同步阻塞 vs 异步非阻塞 |
配置管理 | application.yml + @Value | .env/python-dotenv | 环境变量注入 |
异常处理 | Try-Catch/GlobalException | Try-Except/日志监控 | 兜底策略,服务降级 |
六、 下一步:从RAG到Agent
RAG解决了“基于已有知识问答”的问题,但它还是被动的。
真正的智能体(Agent),应该是主动的。它能自己思考:“用户要查天气,我得先调用天气API;用户要订机票,我得再去调支付接口。”
这就是我们专栏第四部分LangGraph与Agent开发要讲的内容。
我们会把RAG变成一个工具塞给Agent。让Agent不仅能查知识库,还能帮你干活。
【阿肥碎碎念】
写到第18章,最大的感受就是跑通Demo不难,难的是上线之前需要考虑怎么避坑。
如果我们一起学习到了这里,RAG这条路基本走通了。接下来Agent部分,才是真正的深水区,干就完了~
#RAG #RAG知识库 #RAG优化 #RAG效果评估 #LangChain
下期预告:【码途手记-AI】第19章:LangGraph是什么:从简单Chain到复杂工作流
互动提问:回顾这18章,你觉得哪个环节(环境、Python语法、Prompt、RAG检索、工程化)是你觉得最难的?评论区聊聊,我们一起填坑。