ARTICLE · 998796
Midscene 从踩坑到上手:插件+Node.js 实战全记录(Web AI自动测试工具)
作为常年做各种管理系统开发者,我早就受够了开发系统后遇到的痛点:每次人工测试就要耗掉大半天时间。直到看到Midscene这个纯视觉驱动的AI自动化框架,不用写元素选择器、靠截图就能识别控件的特性,完全戳中了我想降低脚本维护成本的需求,于是便开启了这段从Chrome插件折腾到Node.js SDK的踩坑之旅。
第一阶段:Chrome插件的“曲折安装路”
最开始我想着先不用搭代码环境,直接用官方推荐的Chrome插件快速体验功能,省得一开始就陷入依赖配置的麻烦。按照官网指引,我第一反应是去GitHub的Midscene仓库下载离线安装包,可日常开发环境里GitHub访问极不稳定,页面加载半天转圈,Release页面根本刷不出来。
既然GitHub走不通,我就转向国内Gitee镜像仓库下载打包好的插件包,当时下载完导入Chrome后,插件面板显示版本是v0.41,我没多想就直接开始配置模型参数。结果刚输入完通义千问Qwen-2.5-VL的API Key,点击执行操作就频频报错,很多官网文档里提到的“桥接模式”“批量任务”功能根本找不到入口。翻了半天才反应过来,Gitee上的这个镜像版本停更了快一年,而Midscene官方最新Release已经到了v1.4.5,旧版本不仅功能缺失,连新的多模态模型适配都没做,完全没法正常使用。
等好不容易把网络环境调整好,顺利打开GitHub下载了最新的源码包,新的问题又接踵而至:我本地环境没装pnpm,直接用npm执行构建命令,依赖版本冲突直接把构建流程卡死;后来补上pnpm,执行`pnpm run build`时又报出Rsbuild构建路径错误,提示找不到`apps/chrome-extension/dist`目录。折腾了快一个小时才找到解决办法:先在项目根目录执行`pnpm run build`把底层核心包编译完成,再进入`apps/chrome-extension`子目录单独执行构建命令,最后把生成的`extension`文件夹直接导入Chrome的开发者模式,终于看到Midscene插件成功出现在了浏览器扩展栏里。
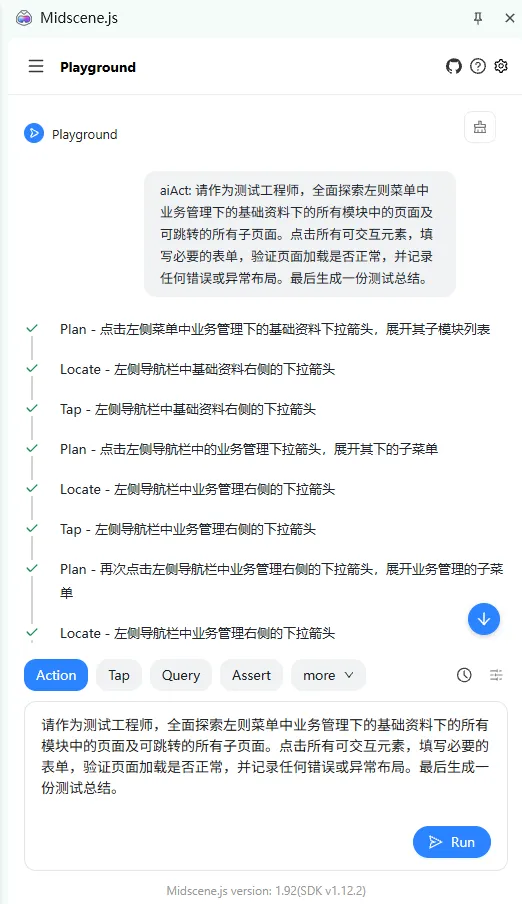
本以为装完插件就能顺利体验,没想到使用阶段的坑一点没少:一开始把模型配置里的`OPENAI_BASE_URL`写错了末尾路径,导致所有AI请求都返回404;后来又发现Chrome默认把插件图标收进了扩展程序折叠栏,每次要点击半天才能调出面板;最麻烦的是桥接模式调试时,本地脚本始终连不上浏览器标签页,最后才发现必须先在插件设置里手动开启“允许桥接模式连接本地服务”的开关,同时保证本地脚本的环境变量和插件里的模型配置完全一致,才能顺利打通连接。
第二阶段:转向Node.js SDK,解决工程化落地难题
插件玩通之后,我发现纯可视化的操作没法和我现有的Playwright自动化流程结合,也没法实现之前想做的多页面自动遍历逻辑,于是决定切换到官方的Node.js SDK方案,把Midscene集成到现有项目里。
刚上手就遇到了和插件阶段不一样的新问题:一开始我直接全局安装`@midscene/cli`,执行`midscene --version`却提示命令不存在,排查后才发现是系统环境变量没有把npm全局包的路径加入白名单,改用项目本地局部安装依赖后才解决。跑第一个示例脚本时,AI识别控件的响应速度慢得离谱,一个简单的点击按钮操作要等十几秒,查日志才发现我默认调用了GPT-4o大模型,不仅推理延迟高,token消耗速度也远超预期,跑3个简单的交互操作就花掉了近千token。
后来我换成之前调研过的Qwen-2.5-VL优化模式,通过动态帧率采样和窗口注意力机制,直接把单任务的token消耗降低了40%左右,推理速度也提上来了。同时我还在代码里加了AI识别结果缓存,重复访问的页面不用重复截图分析,进一步把整体token消耗压到了可接受的工业使用范围。
踩坑后的真实使用感受
折腾完这一整套流程下来,我最大的感受是:Midscene确实重新定义了UI自动化的体验。以前写自动化脚本,80%的时间都在和脆弱的元素定位较劲,现在用自然语言描述“点击导航栏里的设备管理按钮”,AI就能自动找到对应控件,哪怕前端调整了按钮的位置和样式,只要视觉上功能没变,脚本依然能稳定运行,维护成本直接降了一个量级。
但它也不是银弹:纯视觉驱动的特性决定了它对大模型的UI理解能力依赖很高,遇到布局特别密集、相似控件特别多的页面,偶尔还是会出现识别偏差;token消耗的控制也需要花心思做优化,直接用高成本的商用大模型跑大规模测试用例,成本会比传统方案高不少。
整体来看,Midscene非常适合我们这类工业物联网场景的H5运维页面测试,不用反复适配不同版本的DOM结构,一套脚本就能覆盖多端界面,只要做好模型选型和缓存优化,完全能成为提升自动化测试效率的利器。
给新手的避坑总结
1. 不要随便从国内非官方镜像下载旧版本插件,优先从GitHub官方Release下载最新源码自行构建,避免版本功能缺失
2. 构建Chrome插件前必须先编译根目录的核心依赖包,不要直接进入插件子目录执行构建命令
3. 新手入门优先用Qwen-2.5-VL这类开源优化后的多模态模型,比默认GPT-4o的token成本低30%\~50%,更适合大规模使用
4. 跑多页面遍历任务时,一定要在代码层维护已访问URL集合,避免重复操作带来不必要的token浪费